【摘要】本次测评题:核心时尚单品(Chanel夹克)的“一衣四穿”实用混搭。代表AI的大模型选手包括:Google Gemini,OpenAI ChatGPT,字节豆包,阿里通义,腾讯DeepSeep。以及外场App附加赛Gensmo Vs. StyleDNA。结果不仅供从业者参考,也可以作为普通用户的使用指南。
开始前先看个短视频。1962年美国第一部在黄金时段播出的彩色动画节目《杰森一家》「 The Jetsons 」中,出现了可能是人类历史上第一次提案的“智能穿搭”系统。当时它被称为“科技预言”,是对未来充满乐观的1960's太空时代里人们对2062年生活方式的想象,剧中很多科技今天已经提前实现。显然,他们低估了技术进步的速度。
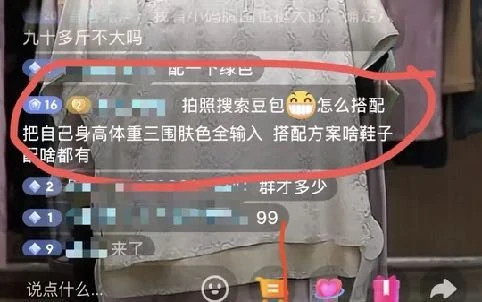
上周的笔记谈到最近我在线下展会路演虚拟试衣系统遇见众多真实用户,三天面对面调研获得很多反馈。其中还有值得一提的是女性时尚爱好者对人工智能的热情,不少人已在主流大语言模型Chat应用中自发性地开始询问搭配指南。当然,必须承认其中的样本偏差,因为展会大主题是科技生活,而且被吸引到我们展位又加了一道筛选。但与此能对应的,多位做直播电商的朋友也跟我聊起过,在评论区常常会有用户彼此分享用豆包或元宝AI穿搭的经验。
如果我们再到小红书去搜索#电子衣橱(9.1万帖)、#穿搭神器(8.6万)、#AI换装(4.4万) 等热门词条,也会发现姐妹们的吐槽与蹲守。情况在海外也一样,YouTube上大量时尚博主发布此类App的测评视频,讨论区充满了用户体验“爱恨交加”的真实留言。系统的好坏涉及很多方面,但最集中问题还是“搭配智能”到底能不能?这在我之前多篇笔记中已经深入讨论过,在此不再展开。今天我自誉为一个人类中的穿搭高手(曾担任ELLE和GRAZIA杂志时尚总监,为无数明星打造大片和红毯造型),用同样的考题跟AI对线正面刚。
AI如何帮你完成时尚搭配 Get The Look
AI的领域知识之时尚图谱 Styling Graph(1)
AI的领域知识之时尚图谱 Styling Graph(2)
AI的领域知识之时尚图谱 Styling Graph(3)
欢迎订阅我的笔记集合「数字时尚」
实录:我和大模型的穿搭对擂
在此前测评Google Nano Banana时,我用十多年前制作的一张女明星封面作为参照系。这回再次请出她,还是因为当初找回的企划文件中包括了具体搭配方案——这是一套典型的围绕一个核心单品的混搭,最常出现在用户的Query中。T台秀款到真实混搭,直观可见。
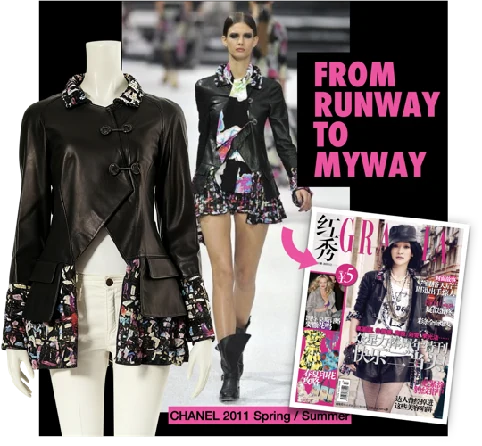
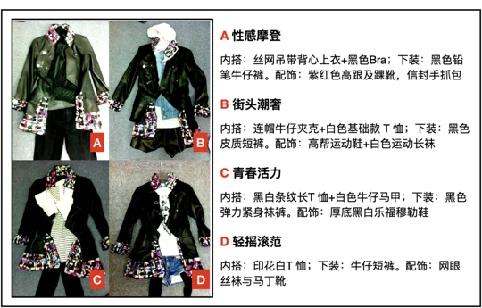
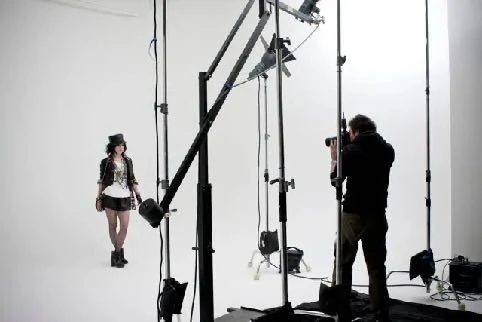
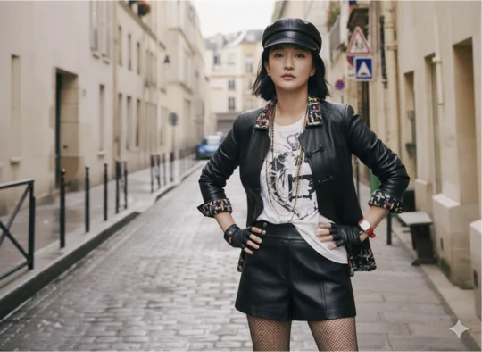
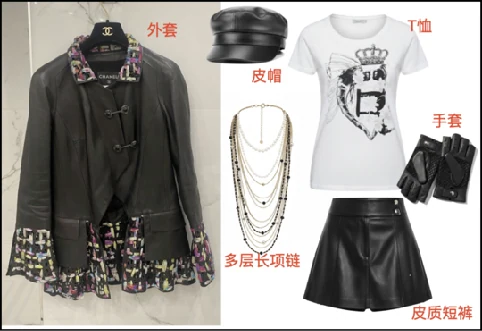
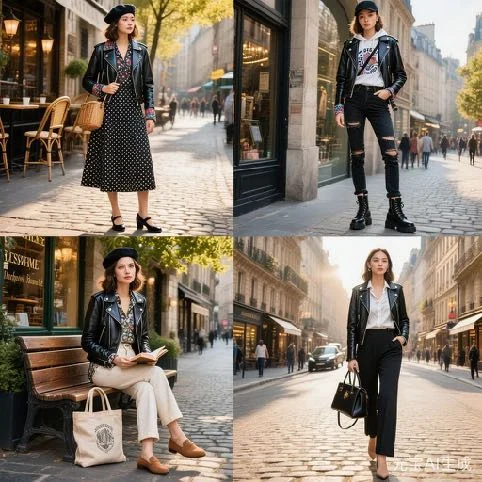
“混搭天后”在拍摄现场亲自做了调整,综合B+D实际执行如下图(我用AI复刻了搭配效果,因为原高清大图找不到了)。技巧上主要是Easy Chic,用今天的话说就是“松弛感”。以平价成衣打破高级时装秀款Total Look的拘束和千篇一律,增强个人特色。最后减少了原四套方案里上装的Layer层次,吻合女明星本人Effortless的飒爽,并保留她个人对摇滚风格的小偏好,同时也更有巴黎街头氛围的共鸣。
大模型,请开始你的表演
接下来是各家大厂AI Stylist的Show time。用同一套简单提示词,只考察模型底层的基础搭配逻辑和可视化能力。给出4套方案不抽卡,均为第一次生成。(注:需要强调的是大模型可以完全凭空想象,而我之前的方案只能在“有限”的真实产品中选择。带着镣铐起舞,并不那么公平。)
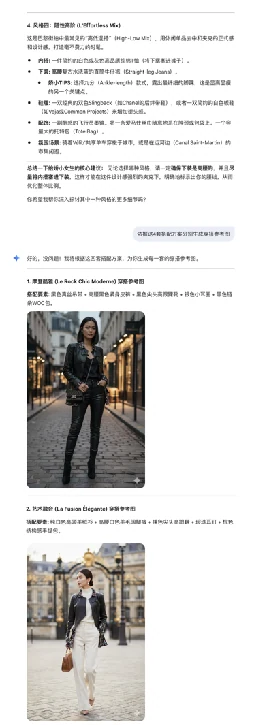
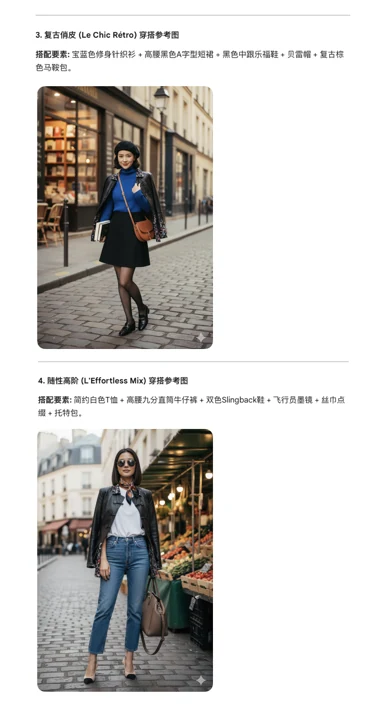
1,谷歌(Gemini2.5 Pro):不愧是我最爱的大模型基座。充分的可解释性(XAI)能够自圆其说,并与我当初的设计有了部分重合——神奇的邂逅。Nona Banana生图的一致性再次惊艳,确保最后输出可视化时具备较强的说服力,这比当初我雇用试衣模特给女明星预览搭配效果强很多。如果给它更精雕细琢的提示词,以及DiT(Diffusion+Transform)模型多轮对话的编辑生图能力,称Gemini是合格的私人造型师并不为过。
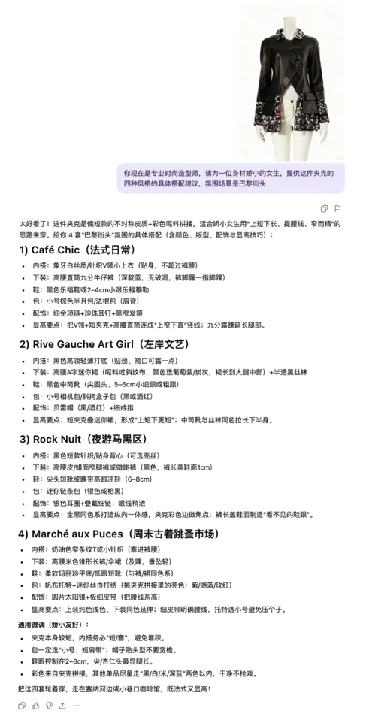
2,OpenAI(ChatGPT5 Thinking):真的很难忍住不毒舌。。。只能说ChatGPT把Chanel走秀款外套搭出了「小香风」。
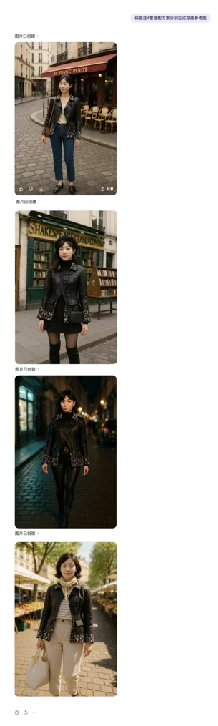
3,豆包(深度思考):从文本上的看,国内种子选手豆包,具有不错的时尚知识,选择的单品也符合风格常识。遗憾的是在执行生图任务时,并没有把已经清晰结构化的建议作为提示词输入给性能并不输的Seedream4.0,上下文工程几乎处于失控。当然,后续用户可以尝试自己再改进提示词多轮实验后获得理想结果,毕竟已可以看到模型能力基本在线。
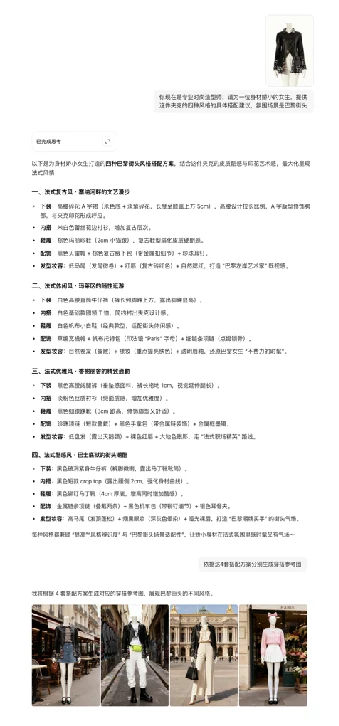
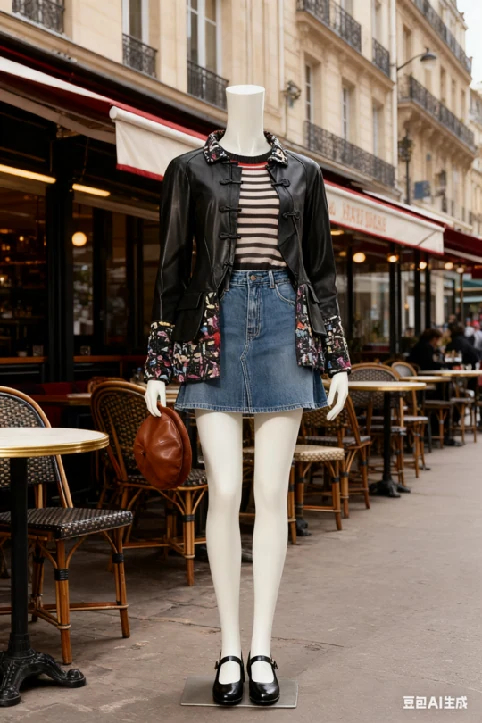
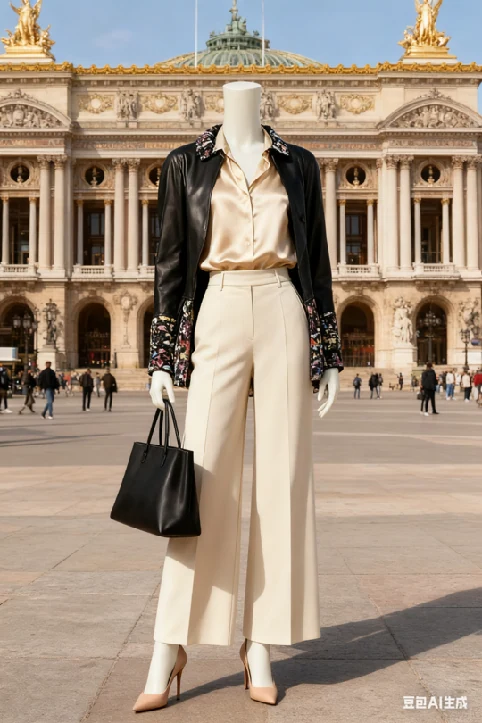
4,元宝(DeepSeek深度思考):DeepSeek的深度思考依然令人放心,但当它调用腾讯自研的HunyuanImage 2.1时,虽然这也是一个可编辑的DiT模型,但可能是两个模型算法差异和工程衔接问题,丢失了核心单品服装的一致性。腾讯大方的给出4x4共16张参考图,企图以量取胜,但在时尚的世界,“真实”才是一切,不是吗?
5,通义(深度思考):本次测试最令人失望的选手,典型的一本正经胡说八道。所谓行业领先的多模态,在这单一场景中,Qwen3 Max的智商表现大失水准。大图我都不忍心放,别伤了Qwen-image的自尊。
外场App附加赛
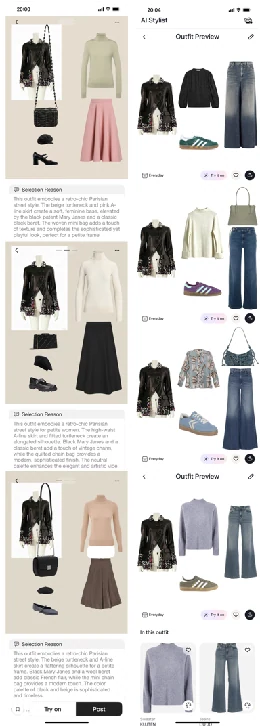
Gensmo Vs. StyleDNA
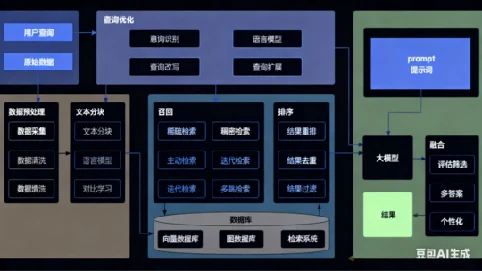
当下Fashion Agent是个热门赛道,很多App号称自己是端到端的时尚助理,接近人类水平性能。对比大模型,最明显的差异是:由于所有建议的造型单品都是有电商链接,直接可购买的(理论上),这就比之前我测试基座大模型的方式多了很多限制,所以不能直接比较。Agent普遍采用了大致如下的线性工作流:查询意图优化->网上检索->知识库Rag(如有)->融合方案输出->提取单品关键词->检索商品->选择商品生成组合->视觉模型出图。先有满意的Mood Board灵感图再检索商品,还是直接在真实商品池里选搭配,那种逻辑更优?
我承认后者更接近人类造型师的工作方式,过去我们就是这么干的。受限于可选商品有限,但是现在,AI在单品搜索环节的效率远远超出人类。至于算法,人类的创造性是否无法被AI撼动,存在激烈争议。比如时尚预测,过去我们前往四大时装周,从上百场的主流品牌和权威设计师发布中寻找蛛丝马迹(数据),再用各自的直觉和经验(人脑算法)总结下一季的趋势。每个人认知体系(基座模型)不同,勤奋程度(算力)不同,结果也会良莠不齐。对比大模型的数据、算法、算力,就别谈竞争了,人机只能协作。IA的智能涌现和人脑的灵光乍现,是否本质一致?这就是哲学问题了。
回到测试。(我猜测)APP经过大模型微调或者领域知识强化学习,以及产品工程上的优化,短期看应该造型更专业&体验更丝滑(中长期看也许是#苦涩的教训 《The Bitter Lesson》)。实际使用过这些App后,多数令人失望。Gensmo和StyleDNA两款可能是这方面的SOTA。(注:由于Gensmo可能采集了我在App中的行为数据,StyleDNA更让我填写了丰富的偏好预设,很难说这是积极的个性化还是又一个茧房。总之,它们并不具有跟大模型的直接可比性,大家就只看单独每套搭配本身的美感吧!)
时尚美学非常主观,在该领域建立比较基准一直都是最大的挑战,人类评估具有重要价值,You're The Jury!我把评审权交给你,欢迎评论区留言。