【写在前面】在上篇 Styling Graph(2)里提到了Daydream如何正面硬刚 ChatGTP和 Google的Agentic Shopping,怀抱同样雄心的另一支创业团队Gensmo也在6月底正式发布了其2.0版本。这个将自己定位为世界第一个AI Fashion Agent的平台,在美通社发稿宣称已筹集超过6000万美元的种子资金,自去年12月上线测试版App以来,帮助用户生成了超过1000万种风格匹配,并索引了1亿件时尚产品,在TikTok和Instagram上,每天UGC穿搭分享量达数千次,一些视频的观看次数超过百万。创始人胡宁拥有卡内基梅隆大学人工智能博士学位,曾担任谷歌移动搜索技术主管和阿里巴巴副总裁。采访中她强调:“时尚的未来并非人工智能取代个人风格,而是利用科技让用户能够自信地表达自我,这种平衡是Gensmo的核心。”是的,部分场景下的AI产品在设计之初就应该秉承增强人类的理念,而不是取代;也正如我在之前博客文章里反复谈到的观点,时尚购物旅程本身对很多人来说也是乐趣,应该节制AI的侵入感,保留更多的权力还给用户。更何况在现实的技术意义上,该领域的知识图谱至今与人类理解尚未完全拉齐。
麦肯锡《The state of fashion 2024》报告预计,未来3至5年内,生成式AI可为时尚及奢侈品行业增加1500至2750亿美元的经营利润。很多传统时尚企业在上一个信息化时代,数字基础设施不够完善,其中就包括企业知识图谱的构建,使得AI的应用基本依赖第三方的标准化技术服务,在电商内容生成和产品辅助设计流程中浅尝即止。对于有些数字化程度较高的头部企业,也因为背负品牌形象的价值负担,谨慎避开了让AI与消费者直接交互的风险,将仍存在“幻觉”的AI应用于中后台。比如LVMH正在利用Agent快速无缝地建立VIC客户档案,并向SA(销售助理 )提供建议。AI基于「客户偏好-产品信息-时尚共识」知识图谱的数据整合,可以预测客户喜欢哪些其他商品,哪些与之前的购买可以搭配,甚至是之前因为时间或勇气不足而不敢尝试的类型,那些SA不会推荐的产品——他们可能担心无效,导致客户的不信任或失望。
然而像Gensmo这样的新创公司没有这样的顾虑,将时尚搭配、搜索、虚拟试穿和沉浸式个性化氛围无缝集成到一个AI赋能的用户体验中。鼓励用户上传已经和希望拥有的衣服、或从社交媒体或时尚出版物中汲取的任意风格灵感照片,又或者仅仅简单地用自然语言描述他们的具体需求。然后智能引擎直接将这些输入快速转化为实用的建议, 生成完整的搭配、甚至合适的发型和化妆技巧,并结合 虚拟试穿功能,让用户可以毫不费力地想象推荐的服装在自己身上的实际外观,加速「灵感—购物车—下单」旅程的转化。实现这些愿景的根基是对时尚的深刻理解,当前的人工智能技术非常擅长结构化理性任务,但时尚和美——受文化、情感和个人经历的影响——本质上是主观的。因此创新的指导性问题就是:“人工智能能否学习品味并理解美?” 要让专用的AI模型不断进化,从人类的经验中学习,就离不开时尚图谱。
欢迎订阅我的笔记: 数字时尚
2025年3月宇树机器人亮相上海时装周NMTG秀场。本文所有配图与文章内容无直接关联,旨在回顾“机器人”与时尚连接的某些“表演”时刻。当人工智能革命从「生成式」转入「代理式」阶段,AI也从基于人类输入生成合成内容的工具,进化为具有问题推理、方案规划与执行能力的,可以自主决策的“机器人”,无论它是否具有物理外观,还是纯粹的数字形态。
Styling Graph (1)(2)(3)
共同的前言
(读过Graph-1 & 2 的朋友可以直接跳到Part-3. 规则逻辑部分)
在通用模型基座已经达到落地可用标准的当下,「领域知识」成为阻扰时尚行业AI Mass Adoption的瓶颈之一。Google的Agentic智能购物采用了Shopping Graph,构建了产品-卖家-品牌-评论之间的语义网络,但这种围绕「产品知识」的图谱,无法捕捉超越客观属性的细致美学、文化和主观意义。另外,在众多杰出的生图模型中,也因为对时尚风格的理解局限,导致生成的换装可控性总有遗憾。我想时尚领域知识应该还需要另一图谱用于构建视觉元素的语义网络:「时尚图谱」Styling Graph。
无论是GPT-4V还是Gemini 2.5 Pro在通用视觉理解上也只有70分,更谈不上精准的时尚生成(包括自然语言问答、生图生视频)。对此,我将分三篇系列文章从跨学科(社会学、语言学、符号学、知识管理、时尚心理等)角度,首先抛砖引玉,在理论层面尝试提出可能改进时尚视觉语言模型(FVLM)的三角研究框架:【视觉特征←→文本术语←→规则逻辑】。下一步的工作是将这些抽象思想转化为具体的计算模型、数据结构和算法,构建一个具有明确评估方法论的稳健实验设计。
最终的目标是让三角框架能用于构建视觉语言训练(VLP)的数据库,结合检索增强生成技术( RAG),为视觉语言模型(VLM)扩展能力边界,缓解模型的知识固化、长尾知识缺失与幻觉问题,使用知识图谱支撑大模型的可解释性。考虑到Agentic端到端流程场景,将其装配到两个“大脑”,供给端的专家Agent,以及用户消费端的决策Agent。每个Agent有——一个知识图谱后端确保答案正确且符合上下文,一个LLM 前端确保交互自然。
从更广阔的角度看,如果能够成功解决这些挑战,该方法将为其他需要主观解释、文化语境和隐性人类理解的领域(如艺术、设计、烹饪等)提供一个构建“文化智能”人工智能系统的蓝图。为泛化多模态知识图谱提供一个强大的范式,弥合人工智能研究中长期存在的鸿沟。
2024年1月巴黎高级定制时装周夏帕瑞丽(Schiaparelli)让模特怀抱机器人婴儿
Part-3. 规则逻辑
System of Fashion
“规则逻辑”是人类时尚知识的总结,包括习俗化的符号象征、公认的趣味标准等,往往隐含于经验之中,需要显式提取并编码到知识库。在“图像特征 ←→ 文本术语 ←→ 规则逻辑”三角结构中,扮演约束和推理依据的角色。
这些规则涵盖色彩搭配的协调技巧、图案组合的宜忌、不同场合的着装礼仪、以及依据体型选择服饰的指南等等。它是知识关联桥梁,连接图像提取的视觉特征和文本语义标签。例如,当视觉分析识别出服装款式或颜色时,规则可以决定这些视觉元素在特定情境下的可接受性或搭配优劣,从而将感知层信息提升到知识层进行推理。通过让模型生成并筛选自身的高质量多跳推理路径,提升对主观语义的解释能力
把模糊的时尚知识转化为无数的三元组 <主 (Subject), 谓 (Predicate), 宾 (Object)>,抽象为机器可读格式的无数“神经元”,从而构建结构化的语义神经网络形成知识图谱,形成知识库骨架。将图像、感知和经验纳入,并在此类多模态上进行表征学习,这些规则节点/关系可以与服饰实体和属性术语相连,形成推理规则集。
有研究表明LLM中的长思维链(CoT)同样能有效提升VLM的性能。将文本CoT数据迁移到多模态场景,微调的效果接近多模态蒸馏,也许能处理时尚图像中复杂的文化符号。例如解决“何以成为Halo Element”时,模型需先定位设计元素,再分析颜色、纹理、廓形等文化关联,在意义层借助强化学习与时间戳向量实现可辩论的符号演化追踪,最后综合生成结论。
仅靠数据驱动的模型难以掌握丰富的常识和逻辑规则,更不必说那种最受顶尖玩家们追捧的时尚法则竟然是“犯错”——它是一种耐人寻味、有意为之、深思熟虑的刻意疏忽,无论是意大利人口中的Sprezzatura,还是代表巴黎女性的Effortless,还是现在我们家常挂在嘴边的「松弛感」。也许利用Transformer技术路线天然的幻觉“劣势”,反而更容易突变出这种“高级感”。
2024年2月赞达亚 (Zendaya)身穿Mugler 1995年作品“机器人套装”出席《沙丘2》的首映红毯
搭建领域知识规则的两种技术路径,也代表了AI进化史上模仿人类的两种选择:
隐式规则学习 – 数据驱动
当前学术研究多采用数据驱动的方法,从大规模服饰搭配数据中学习搭配模式,捕捉服饰之间更复杂的规则与关联(如多维度兼容性、季节与材质适配等)。典型做法是利用度量学习或图神经网络,将服饰组成Outfit的兼容性用向量空间(Vector Space)表示出来。这类方法能够从非结构化的流行趋势和用户行为中总结出“隐性规则”(如哪些单品常一起出现),但瓶颈在于:模型缺乏对显性时尚规则的了解,可能学到的数据模式难以解释,而且需要大量搭配数据支持。当碰到新颖搭配或违反常规的组合时,模型难以判断好坏,因为缺少先验的规则知识。
典型例子是Polyvore时尚Outfit数据集,其中包含约6.8万套由时尚爱好者搭配的服饰集合,每套搭配都精心挑选确保风格统一。这类数据提供了隐式的上下文:哪些单品经常一起出现、某件上衣通常配何种风格下装等。将其构建成服饰图(如超图结构)或通过Transformer注意力机制建模多件商品间的兼容概率关系。但我发现所有Polyvore研究都忽略了这些Outfit Moodboard通常包含与服饰不相关的,用于装饰的范围道具和贴纸(全部被识别后排除在分析目标之外),其实正是这些元素代表了Outfit创作者希望表达的搭配情景,风格宣言,情感价值观等更高维度的上下文抽象规则。
显式知识融合 – 知识驱动
另一方向是融合人工制定的规则,将服装属性、风格、场合等实体和关系存储其中。这类融合显式规则的系统在一定程度上突破了纯数据驱动的瓶颈:它们让模型考虑到领域知识,改善了推荐的精细度和可解释性。然而,显式规则建模也面临挑战:规则获取困难,时尚规则往往隐含在专家经验和大众文化中,具有模糊性和主观性;即使有了规则,还需选择适当的表示并融合进模型,如何权衡规则约束与模型灵活度也是研究重点。
以人类专家为核心的知识驱动路线,其实在AI前两次浪潮中都失败了。专家系统面临知识获取难、维护成本高和使用场景受限等问题。但目前AI正走向“算力的瓶颈”,“大数据+弱规则”的发展思路受到挑战。融合是趋势,未来人类领域专家需要通过构建整合性的研究框架和实现知识的数字化、算法化表达,与数据驱动流派共同推动AI向更高智能迈进。最终提升模型在需要复杂多跳推理任务上的表现。让模型不仅能做关联,还能理解因果关系,从而提高系统的透明度和用户信任度。
美国波士顿动力公司制造的“机器狗”被送上了Coperni 2023年秋季的T台
时尚体系的「语言-言语-话语」
搭建知识图谱规则还是要回到语言的本质,它是人类独有的建模系统,塑造我们对世界的认知。现代意义上的语言是多模态符号,超越了文本,包含艺术、图像、音乐、饮食等多感官多经验,甚至这些事物构成的仪式。当然服饰(Dress)、装扮(Dressing)也包括其中。所有符号系统共同参与了自我意识和对存在的理解构成,
正如 Part-2 文本术语所述,文本语言仍是核心。我们为时尚所创造的规则源自这样的社会意义生成,在此,仅仅作为一个分析视角,我冒昧重新定义和挪用经典语言学中的Langue(语言),Parole (言语)和 Discourse(话语)的概念来理解和构建系统。
语言Langue:
通常作为符号系统的整体,泛指人类语言表达,是静态系统。
言语Parole:
指个体在具体情境中的语言实践行为,具有偶然性和个体性。
话语Discourse:
强调语言的社会系统性实践,是对言语的扩展,涉及权力关系、意识形态和意义生产。
正是这样的体系将特定服饰建构为我们日常时尚生活中的“Must Have”、“Top Trend”等概念,从而“权力”实现了对大众的规训。对此,法国哲学家米歇尔·福柯就提出过:话语并非单纯的语言现象,而是权力、知识与意识形态交织的历史性社会实践,其核心在于揭示语言如何通过体系建构现实、规训主体并生产真理。他强调话语随时代变迁而重构,话语不仅描述现实,更创造现实。
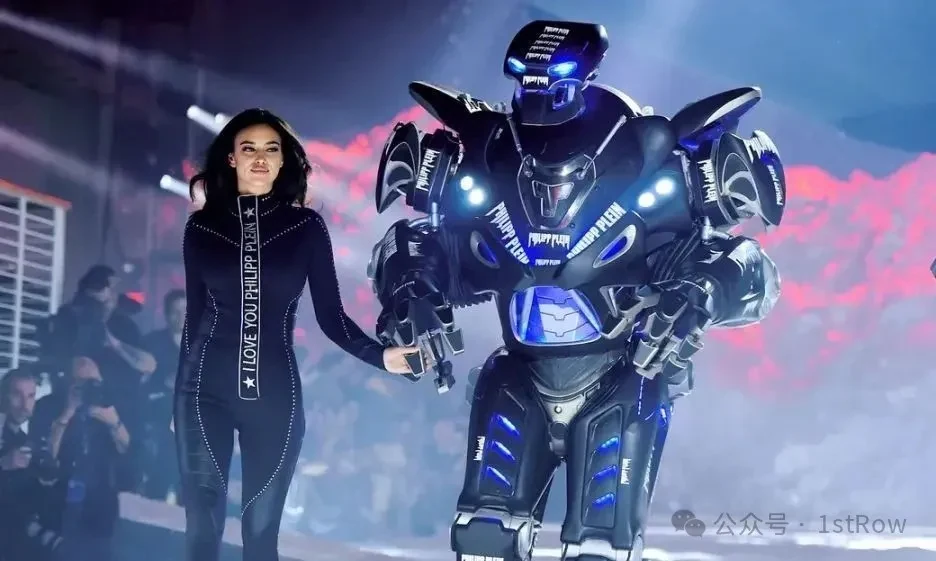
Philipp Plein 在其 2018秋冬秀上第二次带来了机器人装置
接下来,我试着用例子来解释前面涉及的学术名词,以及体系的规则是如何在Langue的符号框架、Parole的实践创新、Discourse的社会权力中不断重构:
来看一件简单的彩虹印花白色T恤,它所能够被诠释的复杂性。其“能指”(signifier)是衣服物理本身,“所指”(signified)是一件印有七色弧形光带的白底T恤,这里能指+所指=符号系统,构成了我们在 Part-1. 视觉特征中谈到的第一层抽象,也就是语言(Langue)。“白色T恤”跟 Part-2中的例子“牛仔裤”一样,也是时尚语言变迁历史中极具代表性的单品,如何从19世纪末的水兵内衣变为后来朋克和嬉皮士运动中的象征,最后又如何成为万能基本款的故事我们不再赘述,仅仅聚焦彩虹印花。
彩虹符号可以抽象成语言(Langue),比如基督教文化将彩虹的“希望”意义推广为普世价值,1997 年梵蒂冈委托设计师Jean-Charles de Castelbajac 为参加巴黎世界青年日庆祝活动的500位主教、5000位神父和100万年轻人设计了彩虹色的服装。
当一位女性穿上这件衣服,即时装言语(Parole)的实践,是符号的具体使用,是个人化的、实体化的、穿上的装扮,传递了一种战胜困难的光明与乐观,绚烂的色彩和弧形结构引发视觉和心理的愉悦。如果放入新的语境中(时间、场域切换),通过时装话语(Discourse)解构和符号操纵,意义再次解码,彩虹多样的颜色变成了象征不同文化、种族、信仰的人们和平共存,也可能代表了这位女性是LGBTQ+ 群体的支持者,毕竟这是彩虹符号最广为人知和普遍接受的现代“所指”。
这解释了为何同一种服饰在不同文化背景下可能有截然不同的称谓与寓意。特定服饰会被群体附加某些特质和角色意义,穿上它甚至会对个体心理产生影响。这一现象被称为“外观感知”——观察、评估或推论自己/他人外观的历程,我们依赖它为日常赋予意义,即使大部分情况下发生在无意识的层次上。也就是说服装的逻辑规则会影响穿着者的行为和认知,换言之,人们不自觉地赋予服饰符号意义,并据此调整对自己的感受和他人眼中的形象。
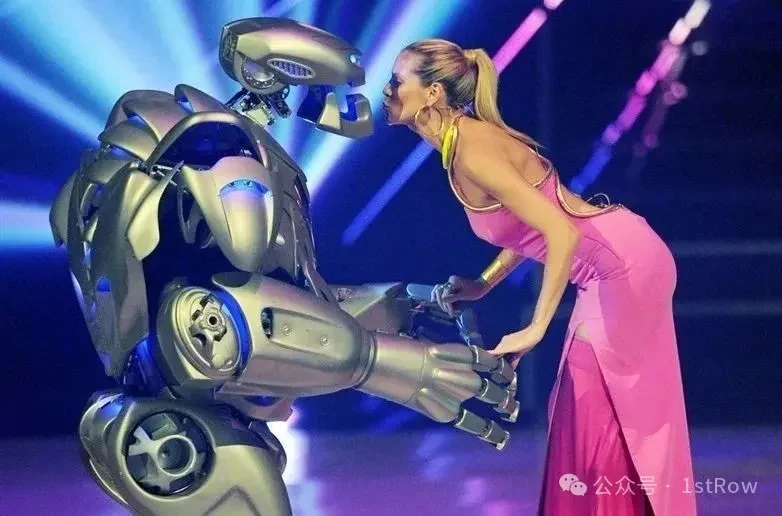
2013 年超模主持人海蒂·克鲁姆在德国超级模特决赛舞台亲吻机器人
探索永无止境
Never End
人工智能如何学习时尚话语中嵌入的“权力关系”?复杂的社会学建构如何能够被量化或编码成影响VLM的机器可读格式?这不仅需要数据,还需要带有社会和文化背景的标注,以及能够解释社会动态而非仅仅图像特征的复杂因果推理或符号推理机制。这凸显了跨学科人工智能研究中反复出现的挑战:将丰富的、定性的人文理论转化为可量化、可计算的框架。
“融合”隐式和显式知识需要一个稳健的冲突解决机制,当数据驱动的规则(例如,“这些物品经常一起出现”)与专家定义的规则(例如,“这种组合在非洲裔族群美学上是不正确的”)发生冲突时——在时尚这样一个主观且流动的领域,这种冲突是不可避免的。需要一个涉及分层规则应用、从人类反馈中学习偏好,甚至是元学习,以确定优先级。有效的融合不仅仅是结合输出,它是一种深度集成,其中符号知识指导学习,而学习到的模式则完善符号规则。
循序渐进和可控落地的重要性。一方面,要充分利用成熟技术(如CLIP模型、图数据库)来降低研发难度,避免反复造轮子。另一方面,要针对实际产品需求优先开发核心功能。需要产品和技术团队密切配合:产品团队应明确主要用例和体验目标,让技术实现有针对性;技术团队则要把握好知识与算法的平衡,在保证推荐准确实用的前提下逐步增加智能成分。定期的跨团队评审(包括对推荐结果的主观质量评估)将有助于纠偏模型或知识库构建中走偏的部分。
展望未来,随着系统运行不断获取真实用户互动数据,我们可以不断完善FVLM模型和知识图谱,实现数据飞轮真正的持续进化。长期愿景是打造一个“时尚大脑”——不仅能听懂诉求,还能结合大数据洞察潮流,推荐搭配匹配商品,用专业知识赋能每一个爱美之人。从商业角度,能显著提升产品的差异化竞争力,在时尚科技领域占据领先地位。
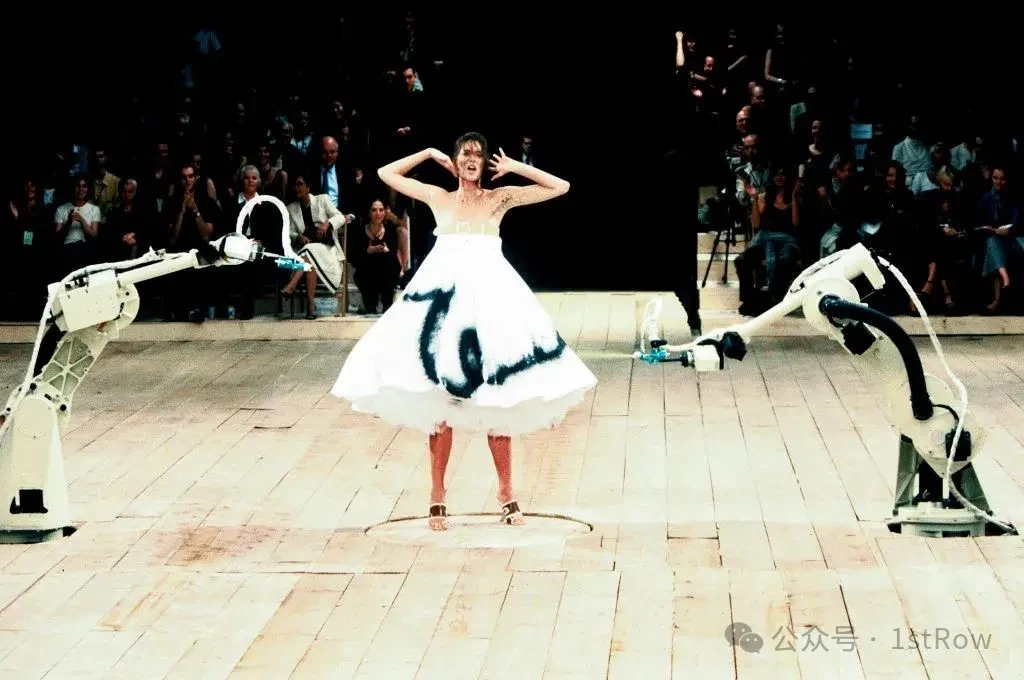
亚历山大·麦昆 (Alexander McQueen) 1999 年春季时装秀机器臂现场为模特绘制裙装的名场面
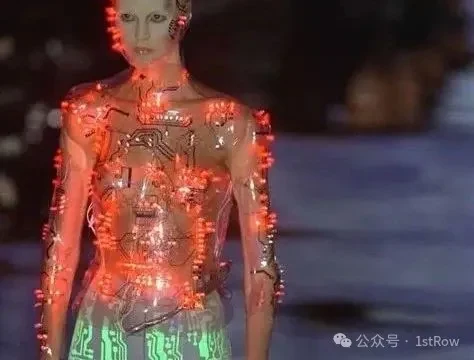
痴迷科技的McQueen为Givenchy 1999秋冬设计的未来主义机器人套装