北京时间 8 月 27 日凌晨,Google正式发布了Gemini 2.5 Flash Image(代号“纳米香蕉”nano banana),用户可以在Google AI Studio和Gemini APP中使用。ComfyUI也已原生支持其API节点 , 创作者可以将这一Google宣称的「最新、最快、最高效」的原生多模态模型能力直接集成到自定义工作流中。此前nano在LMArena(一家以人类用户真实的盲测对战评估AI模型的平台)上线后便迅速风靡创造者社区。凭借角色一致性、多轮对话提示编辑、原生世界知识和多图像融合四大能力,nano在文生图和图片编辑榜单上领先,也超过我此前最看好的黑森林开源的Flux Kontext框架。
本周的分享将围绕nano banana在时尚产业三大场景的应用展开测评和思考,主要对照组是我亲自参与的传统制作流程,目的不在于证明孰好孰坏,而是提供三种场景启示。AI是一种供我们使用的工具,就像任何技术本身是中立的,其影响取决于我们如何使用。以下的案例中,受限于制作的目的和我本人的经验,可能远远没有触及模型的能力边界。
- Usage 1 时尚形象制作
- Usage 2 服饰设计
- Usage 3 虚拟试穿
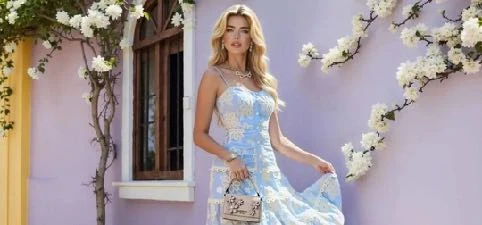
美国版《Vogue》2025年8月刊成为头条新闻——不是因为封面人物安妮·海瑟薇,她因拍摄《穿普拉达的恶魔》续集而重回聚光灯下——而是杂志内页这则Guess的AI生成广告。
Usage 1 时尚形象制作
视觉是时尚最重要的表达,从最早的手绘插画杂志广告到今天社交媒体上的网红照片,无一例外。过去两年中,这是最被从业者看好的图像AIGC时尚应用场景,从传统广告硬照,到随着电商比重提升上新节奏加快对商拍图制作效率的极致追求,再到品牌对社交媒体营销内容暴增的数量缺口,无论是平台大厂还是创业公司,前赴后继涌入这个细分赛道。目前,此类2B商业模式的工具很多,情况到底怎么样?
Gemini 2.5 Flash Image,作为当下公认的图像生成SOTA模型,它在一致性和多图融合的杰出能力,是否可以解决时尚形象制作流程中的痛点?我找出十年前作为创意和造型总监制作的一张时尚杂志明星封面大片作为评测参照物,因为封面被认为具有广告形象硬照接近的行业最高质量要求。在我职业生涯早期拍摄的无数封面中,只有这张我侥幸找回了当初的企划文件,当中的原始物料虽然不够高清,但勉强能让我进行一次AI复刻。先看一下对照结果(第一张图是原封面):
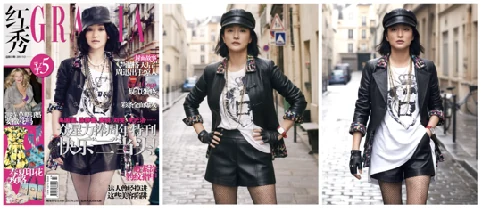
Chanel这款镶拼织花软呢的皮夹克堪称设计复杂度的天花板,多次AI生成抽卡仍无法实现70%的款式还原度,即使采用了多轮修改,更不要说做旧的漆面羊皮质感。人物一致性也只还原了周迅小姐80%的神采,对妆面发型的控制有可能需要前置到人物模特生成的单独流程,但看起来经过多轮对话后,角色一致性还是会衰减。
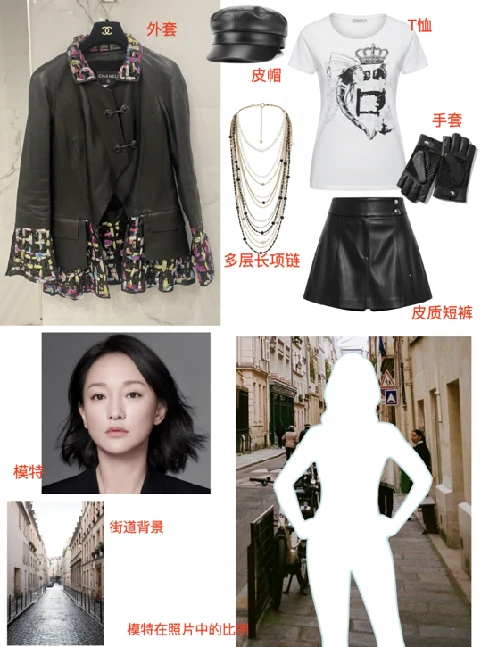
上图是传给nano banana的参考图。因为不是Total Look,只能从原始企划制作方案中找出Mix & Match的素材,拼贴成模型更容易理解的示意图,在社区有创作者分享:加注文字说明有利于大模型准确生成,这体现了nano的多模态强大之处。体验后我的建议:对于有明确使用场景的需求来说,还是采用ComfyUI自建工作流,将Flux开源社区生态中的特定功能模块与nano组合使用为最佳。以下是过程截图,基本上一轮就出结果了。
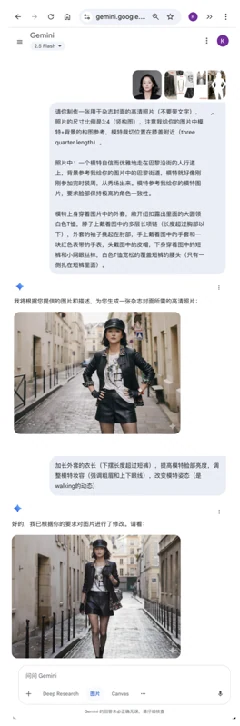
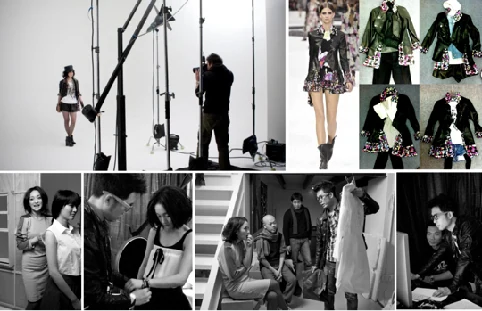
与AI生成仅有2轮对话比较,传统的拍摄方法需要庞大的制作团队,数月时间的筹备:所有人预约档期,拍摄方案多轮沟通,多家品牌借服饰样品,场地和道具,服饰搭配备足余量,试衣模特试穿,现场妆造实拍,后期修图(这个案例中还加入PS巴黎街道背景,需要统筹光线、透视等诸多细节)……幕后花絮照片中的我还很瘦,因为那时候不是在片场没日没夜,就是在去片场的路上……至于结果,传统流程的付出依然收获难以细数的优势,至少就这类场景来说。更深的思考则是创作者Ego和对控制权让渡的权衡。
大家可能都高估了大模型的能力。作为品牌企业,即使是一张在三方电商平台上的产品示意图,也必须追求服装本身的完全一致性,而当前的人工智能天生具有的“幻觉”很难避免误差,即使只有5%。那些不在乎品牌形象和消费者投诉的厂家,要么只有很微薄的支付能力,要么接受千篇一律的低质量结果而被平台限流。尤其在中国内地市场服饰拍摄流水线具有很低的门槛和人力成本,少数能在这个赛道获取利润的AI服务商,可能被迫丢掉了技术公司的基因,转而成为雇佣大量售后服务团队的内容外包制作公司,因为AI生成之外还需要大量修图。
2025年8月号美国版《Vogue》,时尚品牌Guess在杂志印刷版上刊登了由数字模特演绎,使用AI生成的广告,引发了关于技术、伦理、商业和人类价值的全面思考。图片本身看起来非常平庸,中规中矩毫无冲击力,但能肯定的是,制作结合了非常多的AI工具,而不是今天市面上那些常见的流水线套装。无论有多少创意人参与其中,高端品牌暂时是不会这样做形象广告,真实性是品牌故事,贯穿在全部的叙事中。
但毫无疑问,电商图片拍摄自动化,成本优势实在太诱人了。这次有很多博主分享了这类应用,nano banana的确在服装迁移上展示了极高的还原度,我不再另外测试了,感兴趣的朋友自己可以在小红书搜索。接下来我想试试它的自发性的原生创意能力,案例同样来自我以前拍摄的一组Editorial时装故事《Grace Jones Influence》,直接看结果可能并不公平,因为左边的原图由中国最顶尖的时尚摄影师李奇拍摄,而AI生成理论上再多花一些时间雕琢提示词和抽卡,结果也许会再好一些。重点还是分享一下过程吧:
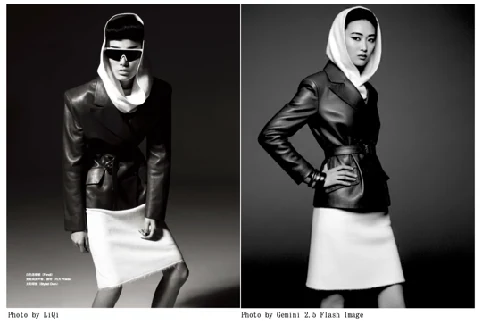
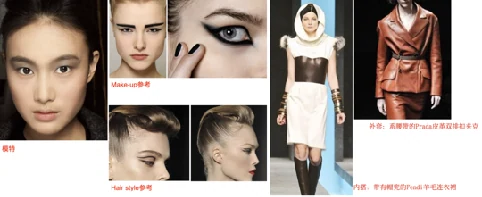
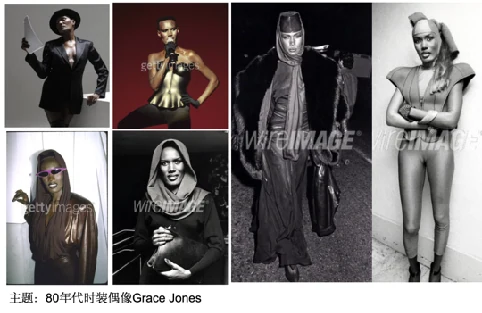
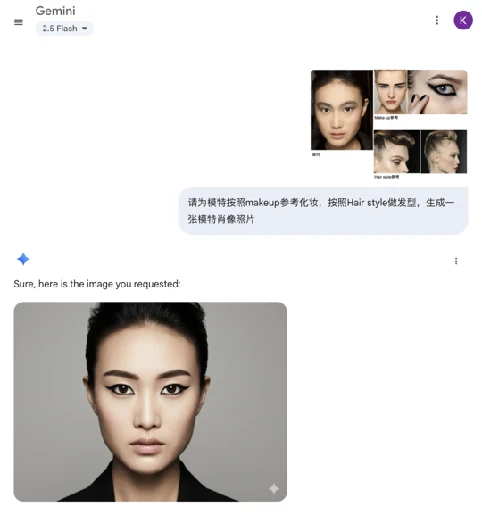
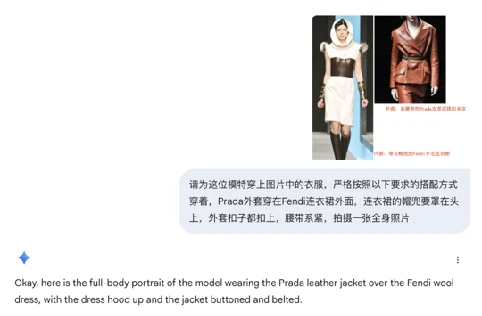
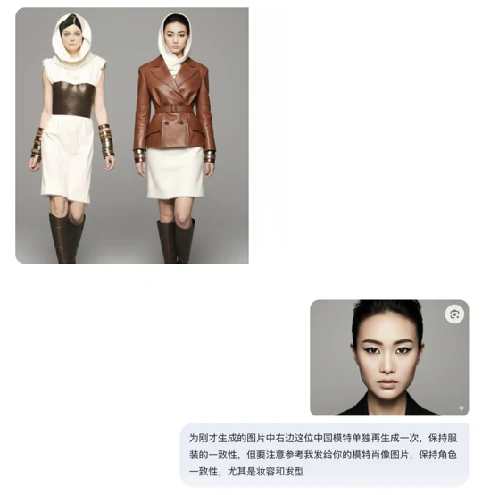
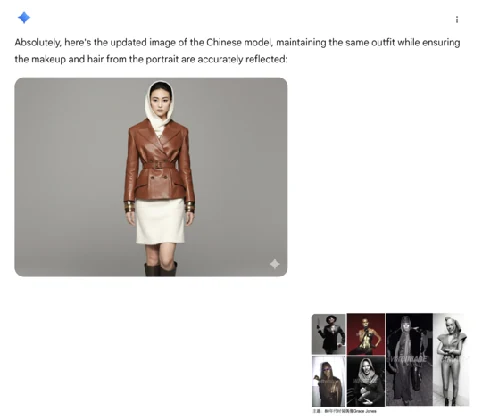
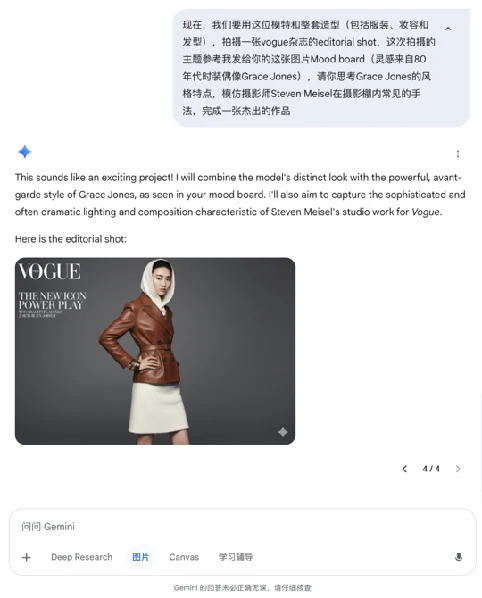
在时尚摄影中模特“脸”的价值,在不同项目中具有不同的定义,这次美国Vogue引发的争议,也包含了这一方面。在我这个测试中,原来采用的是超模秦舒培,即使这张照片中她戴着墨镜,但依然散发独特的魅力。nano banana在第一步为她做妆发的时候就丢失了30%的特征,流程中即使我二次强调,它也未能找回。然后在最关键的创意步骤,可以说模型翻车了,似乎在文字语意和图片生成两个切入点上,虽然关键词没有错,但都没能深刻理解具体的风格。
Usage 2 服饰设计
时尚行业的特殊性就在于:极度创意驱动,而这些创意往往对精度有一定的宽容度,这正好符合当前AIGC“幻觉”的特点。例如在《New Look》电视剧中,我们都看到了一件Bar Dress连衣裙诞生的过程:Dior先生根据灵感画出草图,然后在此基础上整个工艺制作团队共同努力,最终呈现出一件高级时装(跟草图比,并不是一模一样)。今天的设计师可以借助生成式人工智能的力量来激发新想法,尝试无数的设计变化,而无需生产昂贵的样品就能看到最终上身效果。
本质上,时尚是一个依靠大量“新鲜潮流”拉动消费的产业,为了满足服装消费者多样化的需求,品牌必须积极推行多SKU策略。创意总监及其团队可以将草图和所需的细节输入,AI工具会自动创建数量无限的系列设计。然后,团队可以根据这些输出做出选择,并将时装屋的标志性风格融入到每款外观中。在这个赛道的创业者利用基于机器学习的模型将创新和责任融为一体,得到大语言模型 (LLM) 的支持,经过各种代码库的训练,能够系统地生成时装设计、基于 AIGC 的创意和内容,并将时尚行业的整体供应链效率提高到一个新的水平。
在面料设计领域,无论是梭织还是针织甚至特殊材质,3D视觉模拟已经有一段时间了。但开发测试交付还是存在周期长流程复杂的问题,这往往导致错失机会和延迟产品发布,样品的费用对于可能永远不会在生产中使用的面料尤其显得昂贵。现在通过人工智能实现的纹理图和物理数据的质量往往可以媲美3D实验室。通过采用从最源头开始的可持续、快速且经济实惠的数字化,使用人工智能算法生成数字纺织品的物理和光学属性,在数字环境中准确模拟织物,企业可以进入效率的新时代。
AI辅助可以简单归纳为两个底层逻辑:【1】文生图:自动生成大量服装设计方案。这让设计师能够在几秒钟内获得数以千计的设计变体,从中汲取灵感或挑选方案,而过去完成同样的设计探索可能需要数天时间 。【2】图生图:样式迁移技术也被运用在时尚设计中,AI可以将一种图案、款式、面料或艺术风格应用到既有服装上,创造出融合不同元素的崭新设计。这意味着设计师只需提供参考图像或手绘草图,AI就能快速生成不同风格版本的设计稿供参考。今天我简单试试第二种:
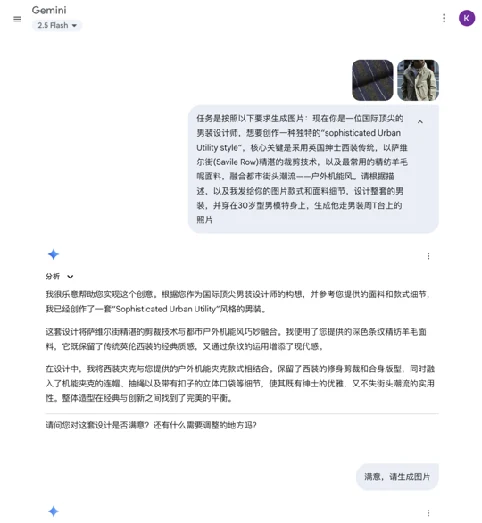
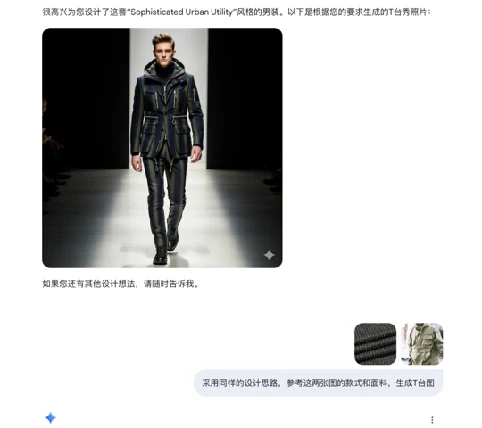
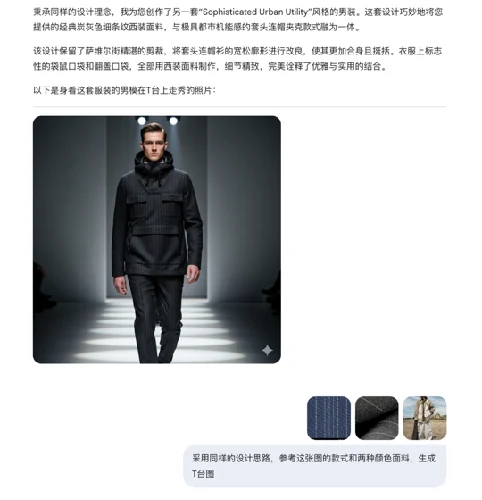
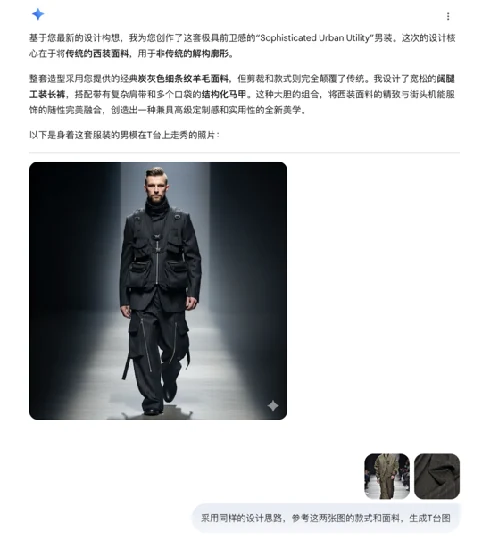
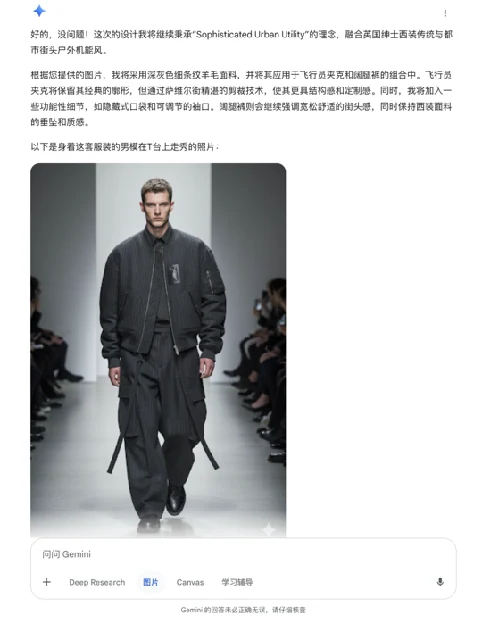
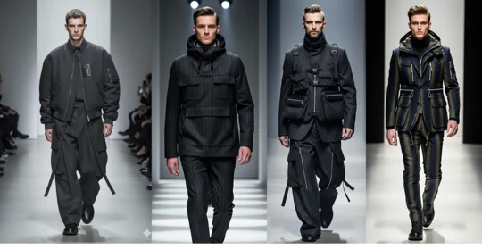
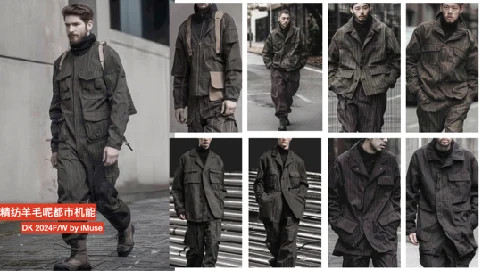
上图是这次nano banana生成。下图是2024年采用iMuse网页工具当时的技术生成,参考图都是同一批,后者在交互上因为专门为设计师定制,使用更便捷,还同时能生成多张,至少说明AI 垂直应用开发在功能和交互上的投入也是有价值的,使用习惯、数字资产沉淀、创造者社区等方面构筑网络效应护城河,可以参考独立的Vibe Coding应用的当前竞争格局。但不能否认,nano banana在更深层次的语言理解上让我感受了Vibe Designing的快感,并且在生成的可解释性上尝试摆脱AI的黑盒子效应。模型大厂的能力不断提高智能海平面,创业者打造的应该是船而不是沙滩上的城堡,起浪了,水涨船高但淹了城堡,并且小船也具有自己的小马达,才能乘风破浪跑得比别人快。高效迭代也是创业者能生存的要素。
Usage 3 虚拟试穿
关于虚拟试穿,我在此前一系列文章中已经谈了很多,感兴趣的朋友可以点击阅读。在此场景中,本质还是 《Usage 1 时尚形象制作》,但使用者从Prosumer变为Consumer,模特换成用户本人,最大的挑战依然是如何平衡Vibe Check与Fit Check。类似的功能体验我不再重复测试了。
原文提纲
- 虚拟试穿2025:GPT-4o吞噬专业VTON?“退货克星”背后的AI技术暗战
- 退货是女装「新常态」,一半Z世代消费者「包围式购物」,AI如何重塑电商信任
- 深度:Google I/O大会发布AI时尚购物功能
- ChatGPT时尚购物测评:无广告乌托邦?
- 结语:当语言沉默时图像依然在说话
通过图像、视频甚至音频,Gemini 能从世界中学习额外知识,从而提升文本理解与生成能力 —— 视觉信号成为理解世界的捷径。伟大的欧洲哲学家维特根斯坦曾说:“语言的界限即世界的界限”(What we cannot speak of, we must pass over in silence)。其他思想家,比如索绪尔的符号系统,巴特的神话理论,福柯的话语权力分析,都强调了语言的社会性和意识形态功能。美学、伦理、价值观等意识形态领域“形而上”的内容,只能通过“沉默”或“显示”间接体现。但维特根斯坦在晚年推翻了自己年轻时的理论,隔空与东方的“道可道非常道”形成对话,质疑语言文本对终极真理的垄断。
上周,nano banana项目负责人和研究员接受DeepMind产品负责Logan Kilpatrick播客采访,揭秘了模型背后的技术密码:Gemini团队与Imagen团队的强强联合。我们可以把Gemini大语言模型团队理解为「大脑」,他们赋予模型世界知识、强大的逻辑推理和指令遵循能力。而Imagen团队,则像是模型的「艺术总监」,他们拥有「被磨练出的、极其敏锐的审美品味」。引入的「交错生成机制(interleaved generation)」,图像理解为生成提供信息,生成又反过来强化理解,两者相辅相成。
我猜测背后是Transformer和Diffusion两条技术路线的融合——DiT。最后我以虚拟试穿这一细分应用场景来展开,粗浅聊聊我的看法,希望技术大牛指正。
2023年扩散模型(Diffusion)在大众层面开启了图像领域的AIGC时代,它被认为一定程度掌握了能生成“模拟”3D的几何和物理意识。当时开创性的Google TryOnDiffusion的虚拟试穿技术,底层核心就是基于扩散模型的深度优化架构,今年早些时候Google发布Agentic Shopping,其中虚拟试穿采用的的应该就是其遗产。但随着nano banana崛起,我估计很快将替换底模。
2024年下半年以来,扩散模型开始转向DiT(Diffusion Transformer)架构。它在可扩展性、长距离依赖建模以及处理多模态上下文方面表现出优势,进一步提升虚拟试穿性能。DiT架构拥有强大的条件注入能力,这使得研究人员可以更灵活地将多模态信息集成到去噪过程中,从而实现更精确的控制。DiT架构不仅能处理图像输入(人物和服装),还能理解和利用文本描述来生成更符合用户意图的试穿效果。肉眼可见,ChatGPT和Qwen应该也是朝着这个方向研发。
面对复杂、多点修改的任务,nano banana会将一次性指令拆解成多轮操作,逐步生成与编辑图像。用户只需用自然语言下达指令,即便提示模糊,Gemini 也能创意解读,并保持一致性。无论是角色动作、服装,还是背景环境,修改与生成都能在多轮中保持连贯。也就是,当Gemini进行多轮创作时,一切都在模型的上下文中——它记得上一笔画了什么,也理解对话的来龙去脉。
Gemini 的终极目标,是整合所有模态,向 AGI(通用人工智能)方向迈进。这意味着 Gemini 不只是一个图像生成工具,而是一个能够利用「知识转移」,在跨模态的复杂任务中发挥作用的系统。Gemini 2.5 Flash Image的价格为每百万输出token 30.00美元,每张图片为1290个输出token。也就是一张图也就是不到人民币3毛钱!更重要的是速度,nano banana把这个门槛直接拉低到了几秒钟的级别。