原标题:生成式AI在时尚领域的应用综述《Generative AI in Fashion: Overview》
作者
WENDA SHI(香港理工大学纺织与服装学院)
WAIKEUNG WONG 和 XINGXING ZOU(香港理工大学纺织与服装学院及人工智能设计实验室)
翻译
DeepSeek
说明
本文中的数字编号[N]代表相关论文索引,可在文末的参考文献列表中查询。
本文讨论的论文、公开代码和数据集链接可在以下网址获取:https://github.com/wendashi/Cool-GenAI-Fashion-P apers/
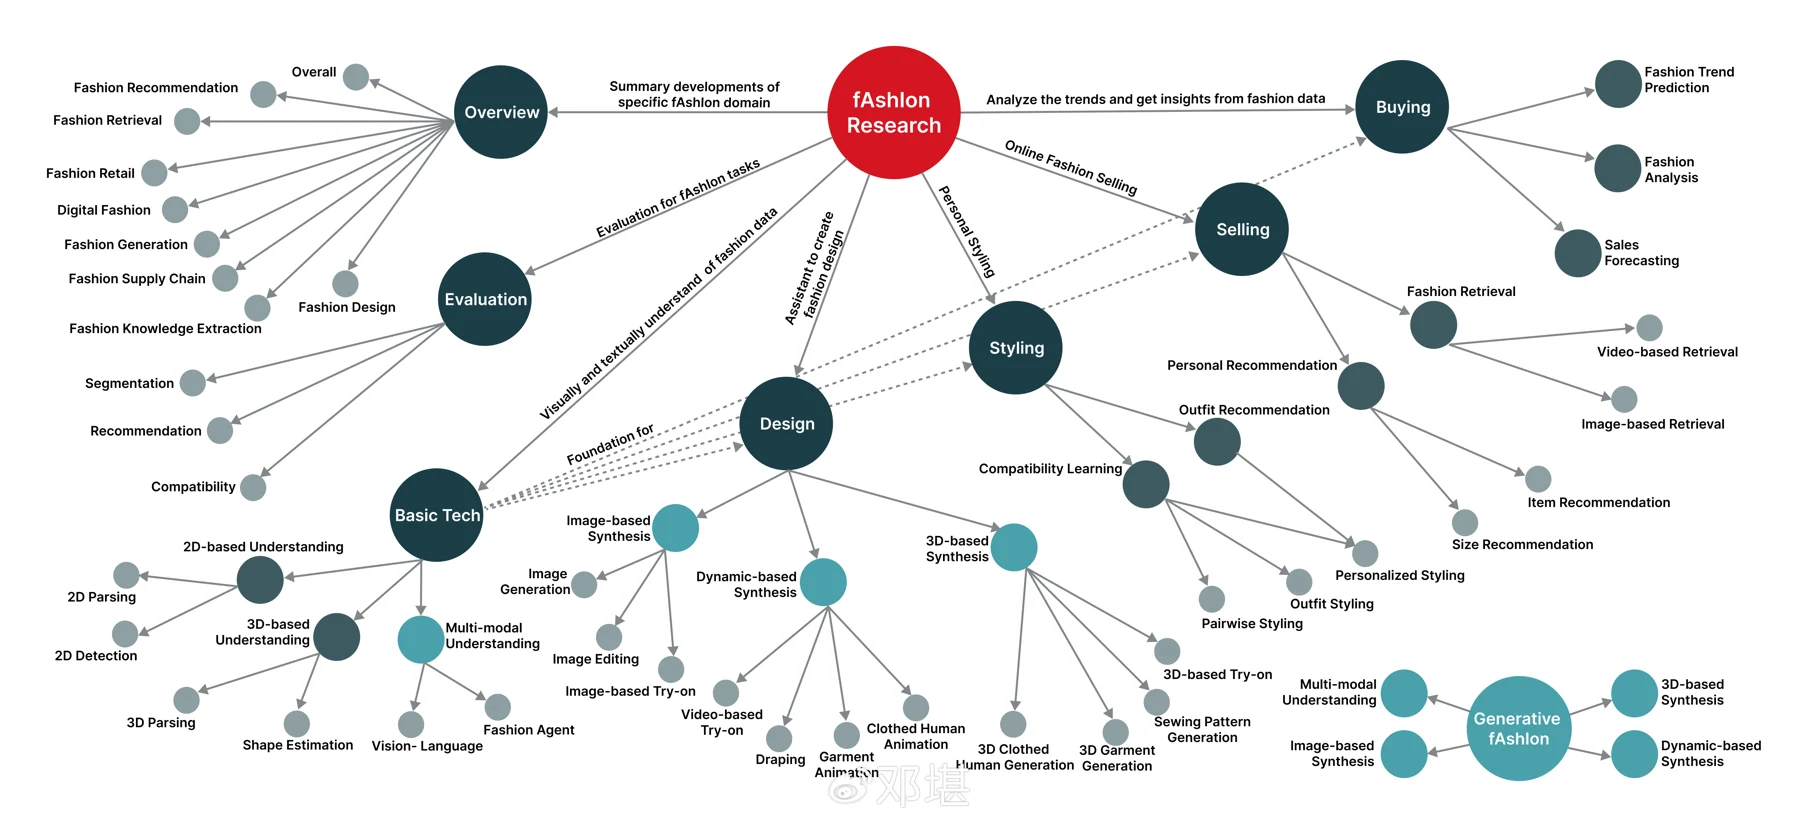
Mindmap of Overall Fashion AI (fAshIon) Research.
生成式人工智能(GenAI)近年来因其能够生成高质量且具有美学吸引力的图像、3D和视频内容而广受欢迎。创新的GenAI解决方案正在改变多个设计相关行业的范式,尤其是时尚领域。本文探讨了GenAI在时尚相关任务和应用中的融合。我们的研究包括对470多篇研究论文的全面回顾以及对30 0多个应用的深入分析,重点关注它们对该领域的贡献。这些贡献被归纳为四大类中的13项任务:多模态时尚理解,以及基于图像、3D和动态(视频与可动画3D)格式的时尚合成。我们深入研究了这些方法,认识到它们在推动未来实现最先进(SOTA)性能方面的潜力。此外,我们还全面概述了5 3个公开可用的数据集,适用于训练和评估以时尚为中心的模型,并提供了相关的评估指标。最后,我们回顾了实际应用,揭示了现有挑战和未来方向。通过全面的调查和深入的分析,本文旨在成为理解GenAI在时尚领域当前发展格局的有用资源,为这一动态领域的未来创新铺平道路。
1. 引言
时尚不仅仅是穿着服装,它还反映了身份和个性,充满了创造力。如今,时尚行业是采用GenAI最重要的领域之一。GenAI能够产生出人意料的多样化输出,使其成为从协作设计流程到简化内容创作的时尚各个方面的宝贵工具。根据麦肯锡的数据,GenAI对时尚和奢侈品行业的潜在影响至关重要,预计在未来三到五年内将贡献1500亿至2750亿美元的营业利润。这一行业独特的艺术表达与商业动态的结合,使其特别适合探索GenAI的可能性。随着GPT-4和Stable Diffusion等基础模型带来的重大范式转变,总结现有的时尚相关任务和应用变得尤为必要。
在此背景下,本文旨在基于学术和工业视角的细致研究,提供深入见解并描绘全面的发展轨迹。为此,我们全面搜索了聚焦GenAI在时尚行业应用的论文。我们的综述涵盖了470多篇论文,并将进展分类为图1所示的四大类中的13项任务。除了学术论文外,我们还回顾了300多个GenAI产品,其中6 9个与时尚行业相关,以更好地将研究与实际应用联系起来。
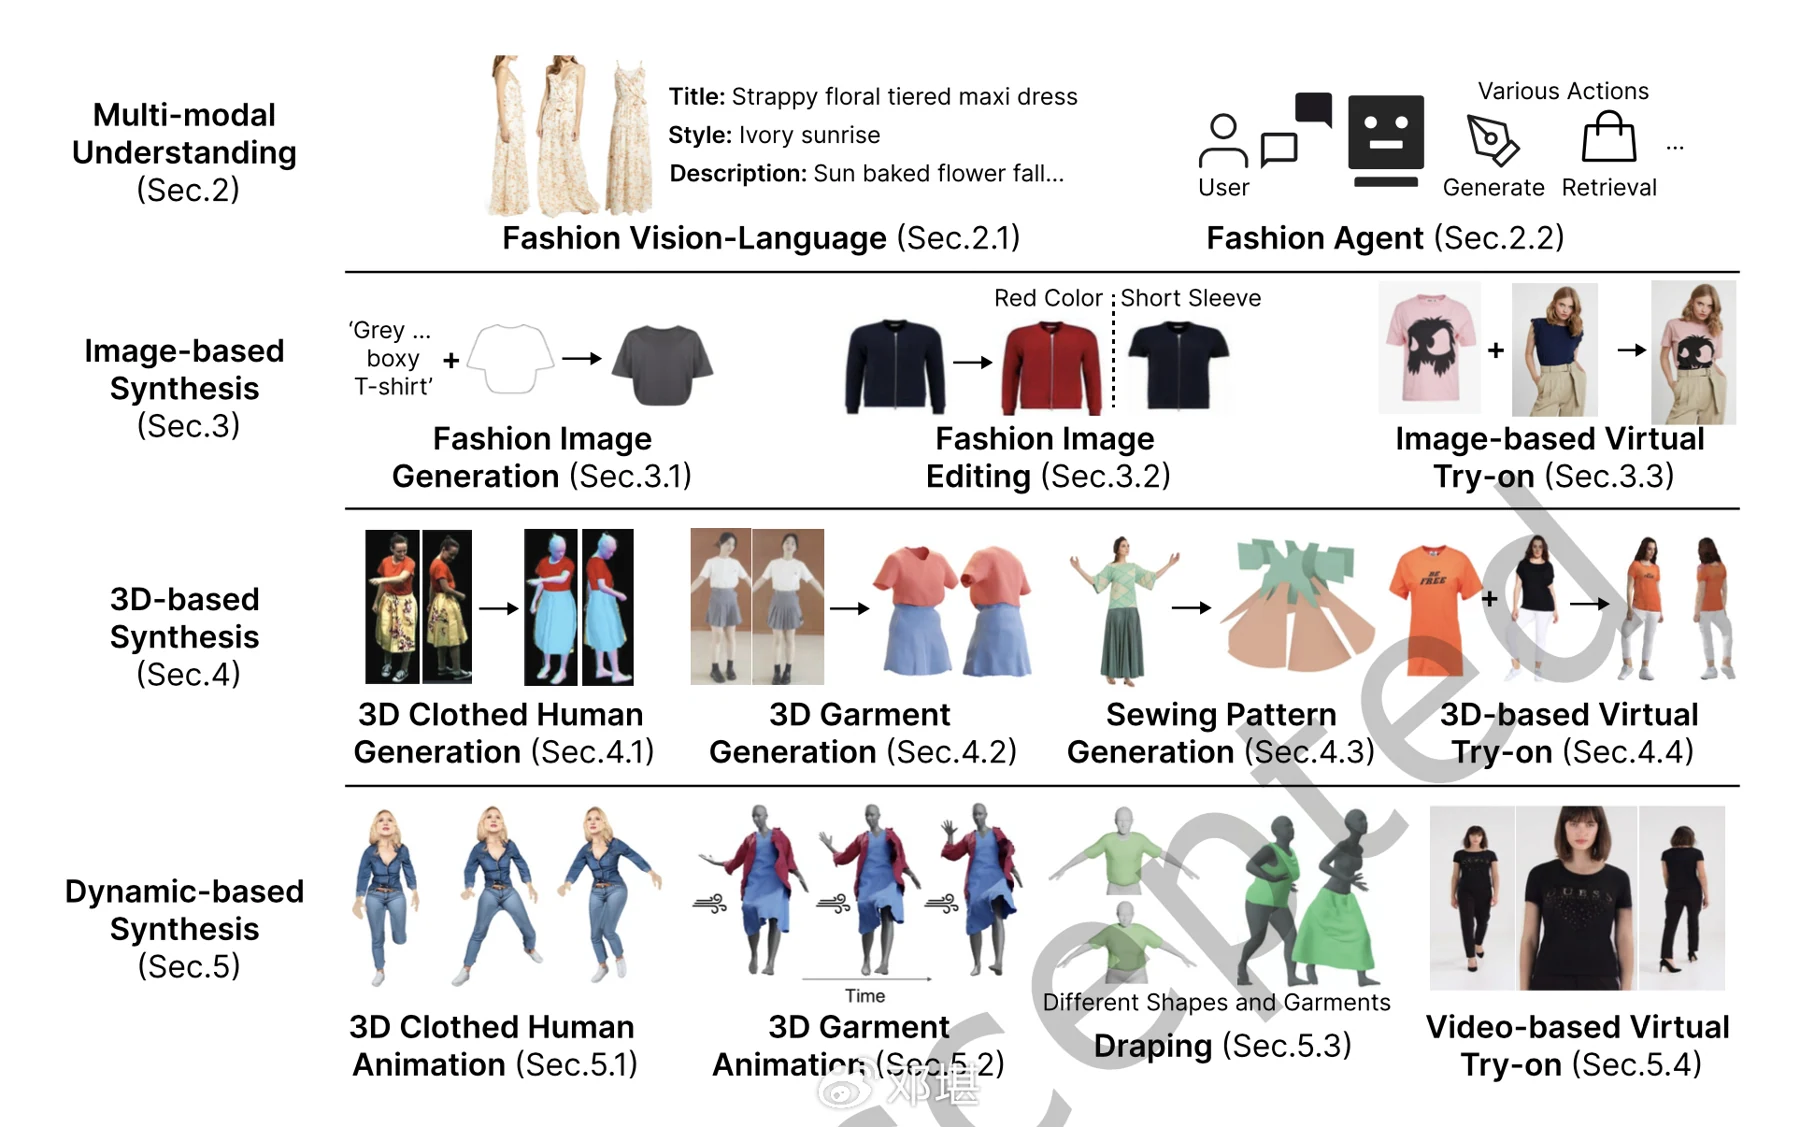
图1
相关综述
鉴于时尚的巨大潜力,这一领域在计算机科学中一直备受关注,已发表了多项调查。其中一些调查[40; 56; 285]聚焦于多种视觉任务,包括时尚分析、时尚推荐和时尚合成。然而,这些涵盖多个领域的工作均发表于2023年之前,早于基础模型的广泛采用。此外,部分调查专注于特定子领域;例如,[195; 224]关注时尚图像检索,[290]深入探讨时尚分析,[333]探索虚拟试穿,[32; 33; 83]讨论时尚推荐系统。在这些工作中,最新的[195; 387]涉及时尚兼容性,但它们仍仅聚焦于单一领域,而非提供全面的概述。
我们的工作与以往研究的不同之处在于,主要关注用于生成各种形式时尚数据(包括时尚产品的文本描述、图像、视频和3D模型)的神经网络训练或微调的基准和方法。随着大语言模型的进步,时尚领域的GenAI正呈现出将先前独立的任务整合为更连贯和实用框架或流程的显著趋势。例如,以前独立的时尚解析[204]和检测[218]任务现在被整合到图像编辑[538]和虚拟试穿[476]等应用中。这鼓励了GenAI在时尚中的全面和灵活应用,从而开发出更强大和有效的解决方案。
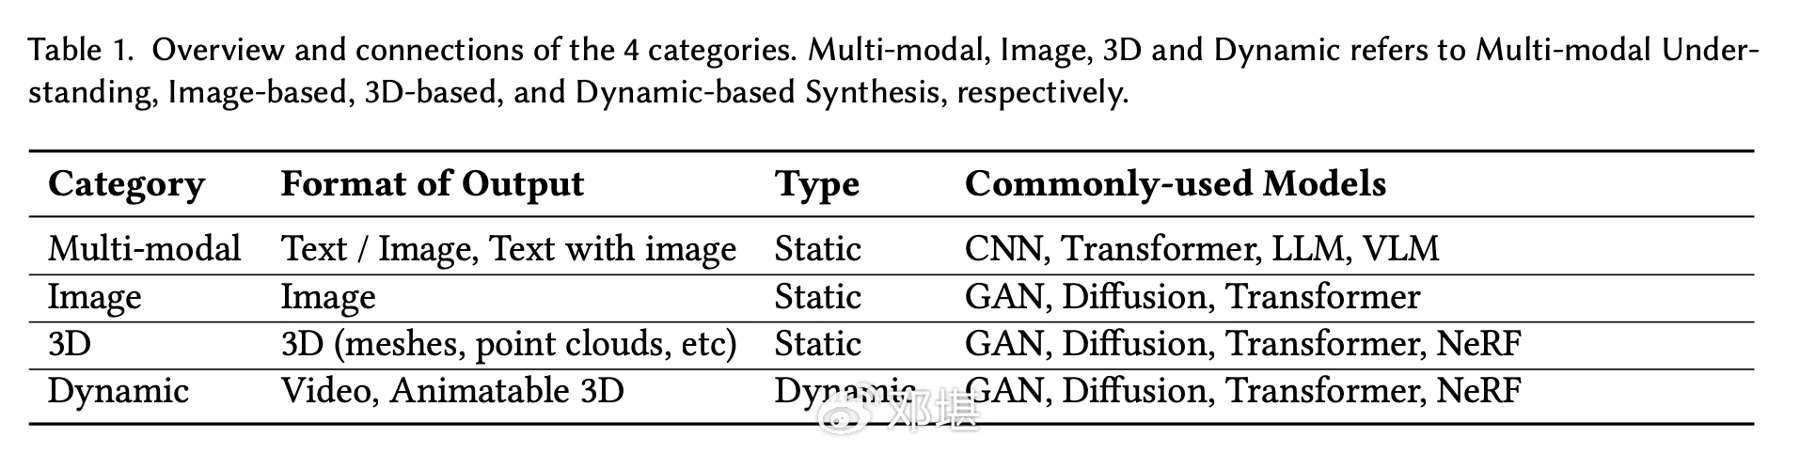
表1
此外,向多任务AI模型的转变是时尚相关任务的另一个关键趋势,凸显了GenAI的适应性和效率。新兴方法如时尚视觉语言预训练(VLP)和时尚代理展示了处理多种任务的能力。这一转变不仅优化了资源利用,还为时尚领域引入了灵活的解决方案,覆盖了更广泛的应用。为此,总结这些新趋势十分必要。如表1所示,据我们所知,这是首个专注于时尚领域GenAI的完整研究。
其贡献总结如下:
我们全面概述了与时尚相关的任务和方法,从GenAI的视角出发,旨在为社区提供清晰的指导图,快速把握这一前景广阔领域的整体格局,并通过利用基础任务的最新进展促进领域特定知识的迁移。
我们将现有方法按输出格式组织为四大类(如表1所示)。对于每个子任务,总结了相应的数据集、评估指标以及最先进方法的性能比较,并进行了深入分析。
我们提供了利用AI时尚方法的商业化应用典型案例,并详细总结了它们当前提供的功能。
最后,我们概述了当前领域内的挑战,并提出了几个有趣且有前景的主题,讨论了未来的发展方向。
综述的组织结构:
本文探讨了GenAI在时尚中的应用,如表1所示,方法分为四大类。第2节涵盖多模态时尚理解,而第3、4和5节分别介绍基于图像、3D和动态的时尚合成。第6节总结了该领域的代表性应用。我们在
第7节讨论了挑战和未来方向,并在第8节进行了总结。
2. 多模态时尚理解
2.1 时尚视觉语言
2.1.1 方法
视觉语言预训练(VLP)模型的出现,为单模态学科如计算机视觉(CV)和自然语言处理(NLP)开启了新时代。VLP在生成模型中扮演着关键角色,例如CLIP[365]在unCLIP(DALL-E 2)[369]和潜在扩散模型(LDMs)[372]中的集成。然而,在时尚特定应用中,重点不仅在于广泛的表示(如物体识别和定位),还在于捕捉细微的细节(如子类别、材料和轮廓)[157]。
为了应对时尚数据的复杂性,研究人员开发了面向时尚的VLP模型,采用不同的多模态融合架构。这些架构如图2所示,将时尚VLP模型分为单流(1-stream)[87, 123, 203, 586]、双流(2-stream)[30, 59]和混合模型[159, 160, 402],如表2所示。单流(1-stream)架构将文本和视觉特征结合在单个编码器块中,使用合并注意力进行多模态输入融合,参数效率更高。相比之下,双流(2-stream)架构为文本和视觉输入使用独立的编码器块,不共享参数。同时,混合(1-stream/2-stream)方法旨在结合两种架构的优势,轻松适应多样化的下游任务。
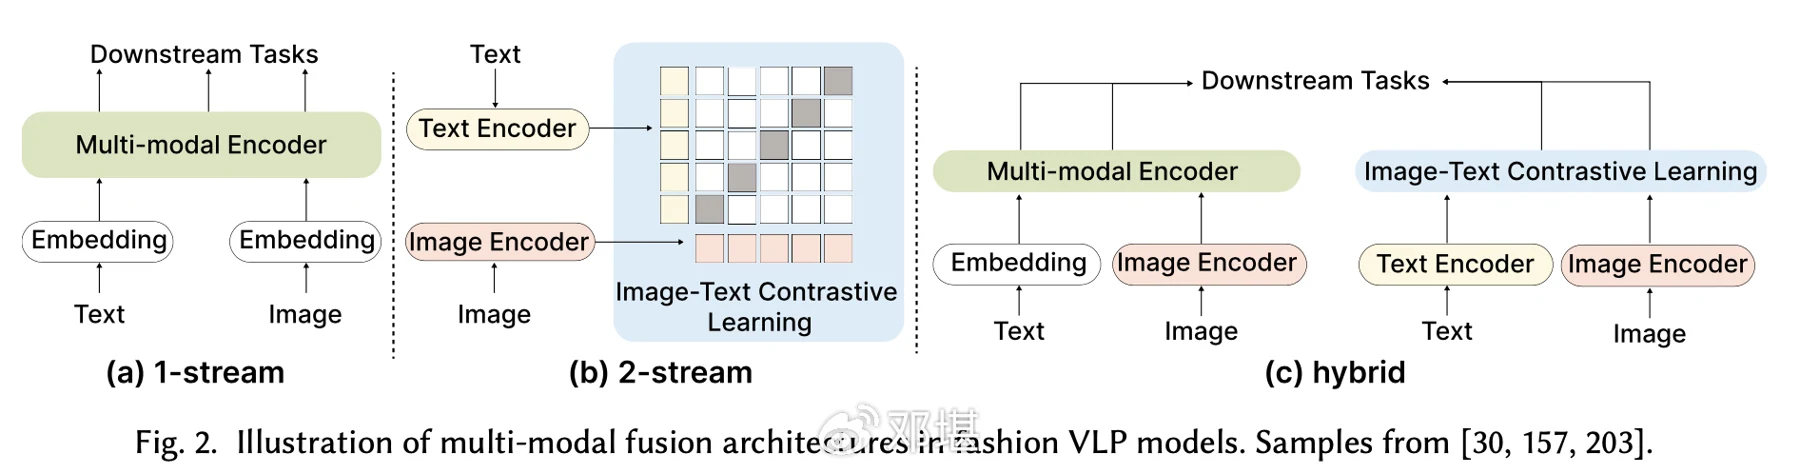
图2
在单流类型中,FashionBERT[123]是首批旨在解决时尚行业中跨模态检索中文本和图像匹配问题的VLP模型之一。它将基于补丁的图像特征与基于BERT的文本表示相结合,从而克服了兴趣区域(R oI)特征在捕捉细粒度细节方面的局限性。
为了增强其有效性,FashionViL[157]采用了一种混合VLP框架以及两个预训练任务,旨在捕捉时尚数据中丰富且细粒度的细节。随后,FashionSAP[160]引入了抽象时尚符号和属性提示技术,实现了对多模态时尚属性的有效建模。然而,时尚数据集常常显示出图像和文本信息之间的不匹配。为了解决这一问题,Song等人[402]提出了同步注意力掩码(SyncMask)。该技术生成能够精确定位图像块和单词标记的掩码,这些掩码在图像和文本中同时出现。
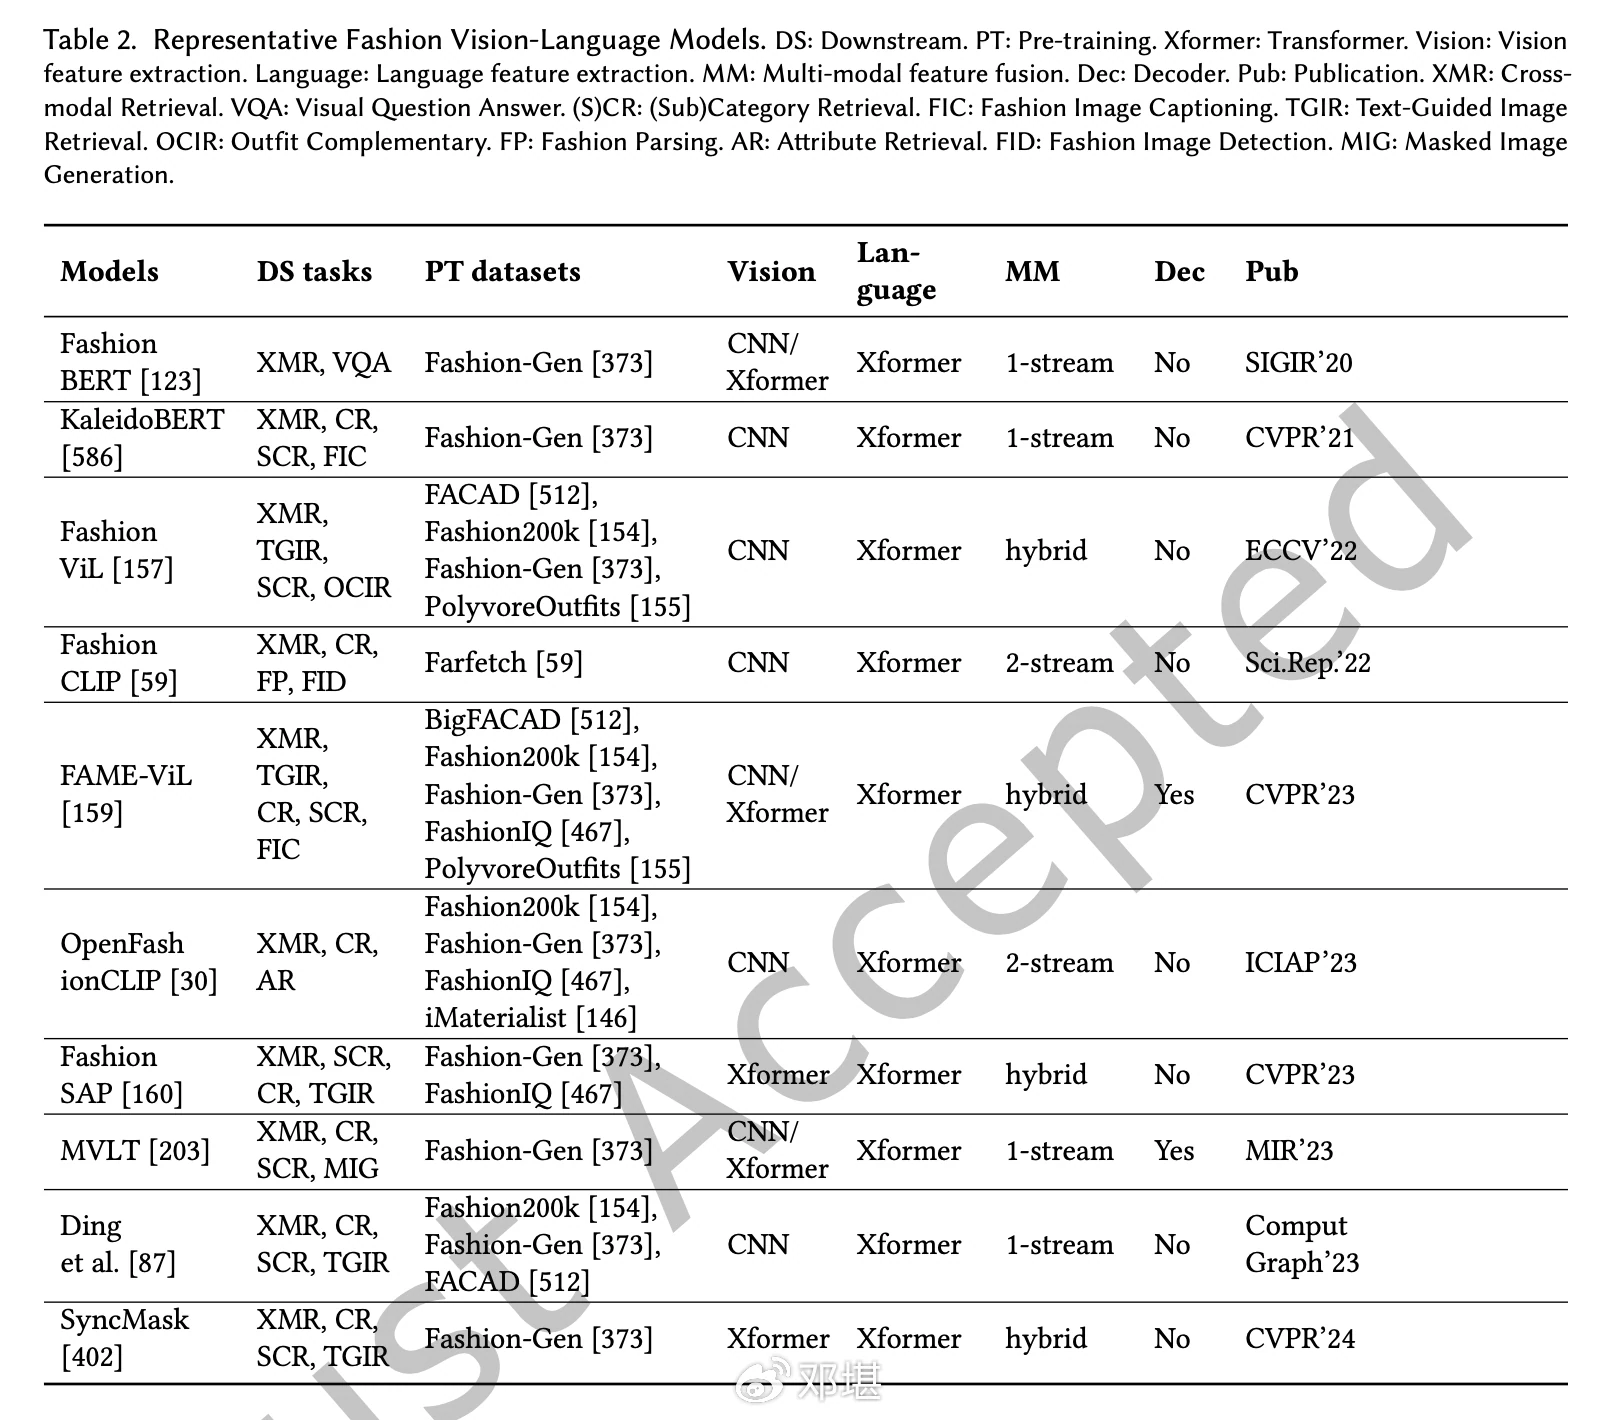
表2
2.1.2 基准数据集
基准总结在表3中。通过分析本小节讨论的论文中基准的使用频率,我们发现Fashion-Gen[373]、Fa shion-200K[154]和FashionIQ[467]是最常用的数据集。其中,Fashion-Gen因其包含最多的文本-图像对而脱颖而出,成为预训练的热门选择。此外,Fashion-Gen支持广泛的下游任务,包括文本到图像检索、图像到文本检索、类别识别和子类别识别。Fashion-200K是第二大数据集,主要用于类别检索任务。而FashionIQ虽然规模较前两者小,但非常适合文本引导的图像检索任务,成为特定应用的宝贵资源。
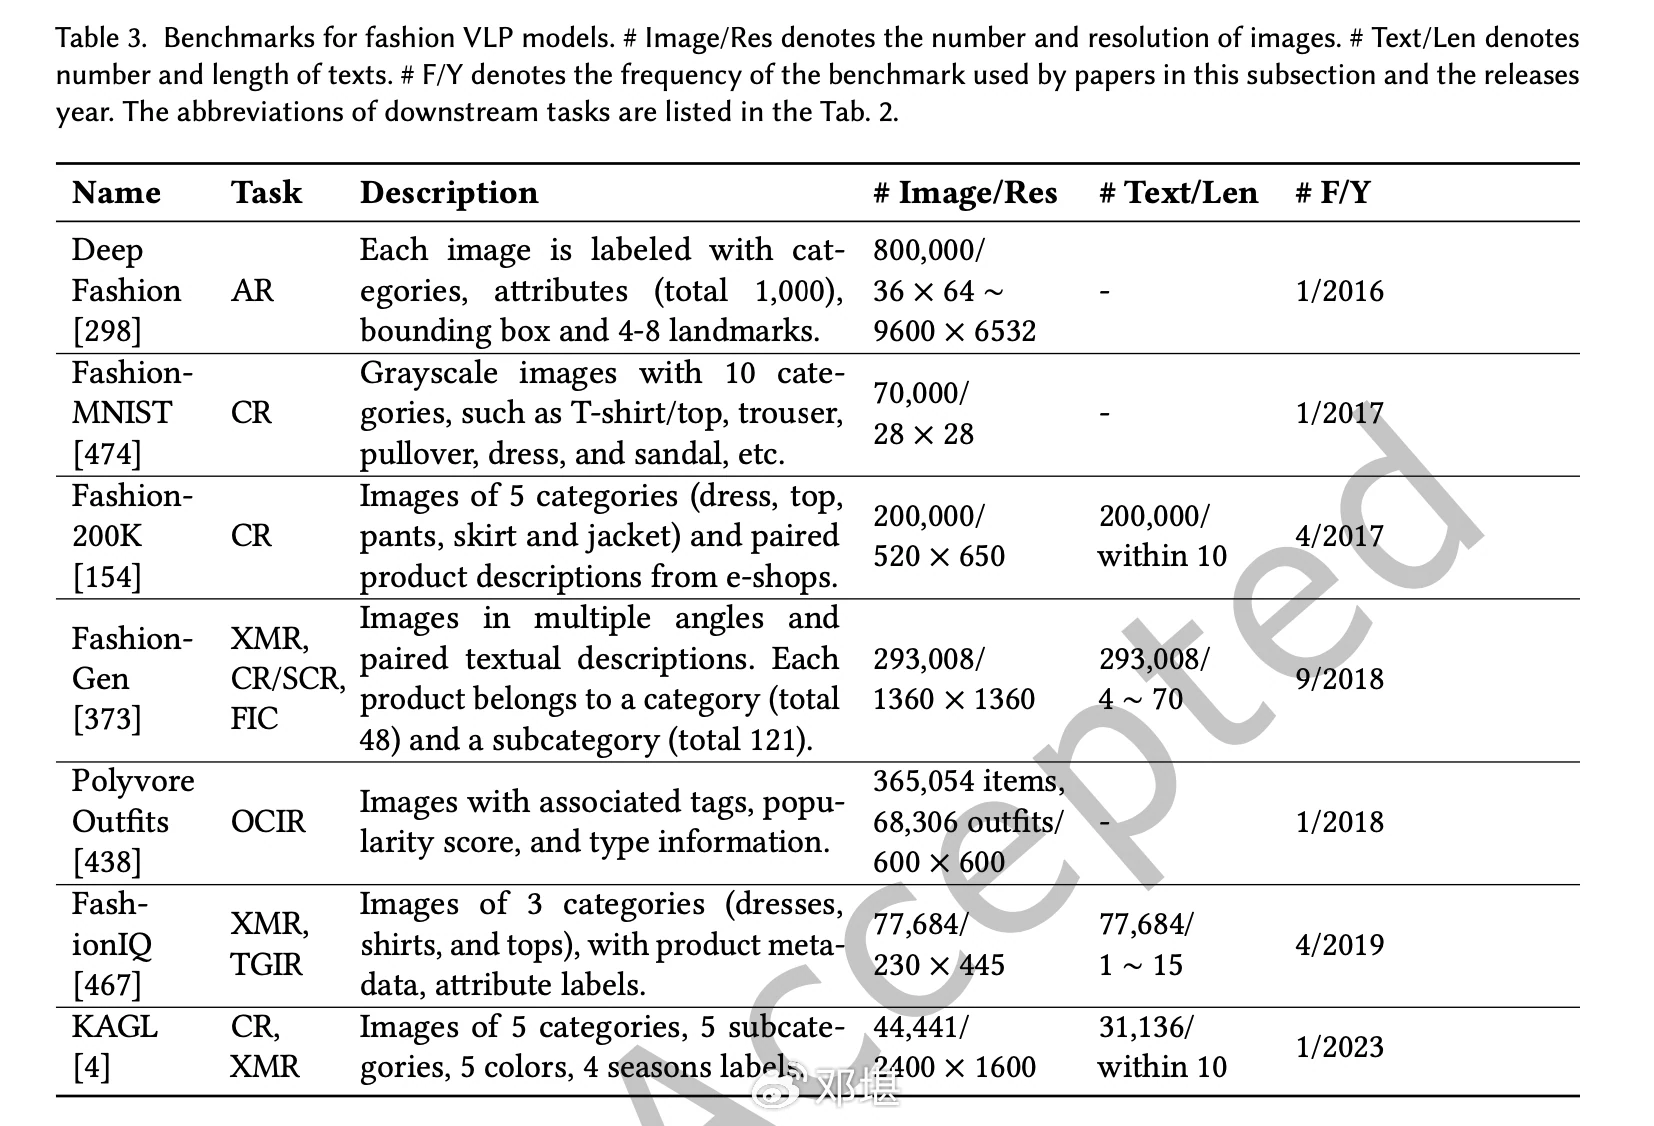
表3
2.2 时尚代理Agent
2.2.1 方法
大型视觉语言模型(LLM/VLM)基于的代理通过思维链(CoT)[461]和问题分解[571]展示了先进的推理和规划能力。此外,这些代理还具备与环境交互的能力,如[8]所示。在时尚领域,时尚代理已被调整用于处理以前孤立的任务,如时尚搜索[388]或推荐[17, 78, 312]。这些任务可以整合到更多样化的应用和灵活的流程中,包括时尚图像编辑[64, 561]、3D服装生成[162]、跨模态检索[47]和视觉问答(VQA)[415, 448],如图3所示。
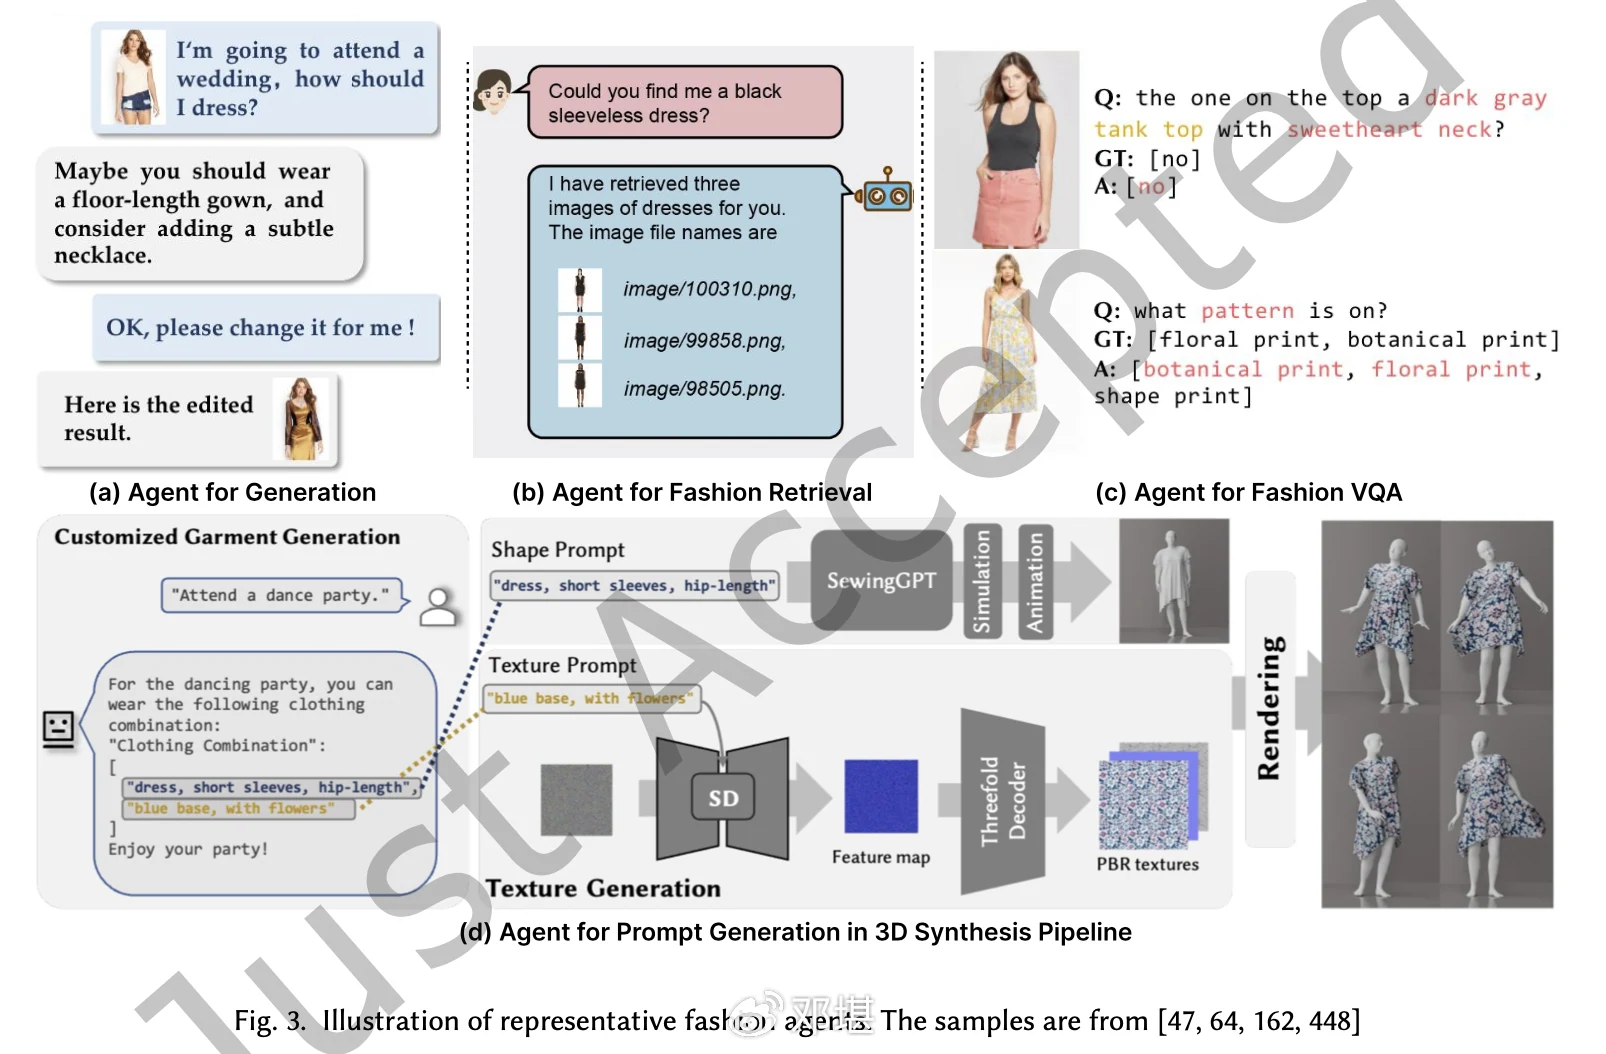
图3
这些方法的主要目标是利用LLM作为代理,使交互更加自然和流畅。Fashion-GPT[515]是最具代表性的工作之一。它集成了多种时尚检索模型,允许用户通过文本与ChatGPT进行交互。通过精心构建一系列提示将检索模型纳入ChatGPT,使其能够逐步解决复杂的检索查询。
最近,为了通过自然语言简化交互,并利用ChatGPT学习3D合成流程中的内容,DressCode[620]采用GPT-4[21]作为代理。通过设计提示使其扮演服装设计助手的角色,提供格式化的输出。随后,询问其对服装的描述,促使其输出特定模板的参数。
除了直接调用外部LLM API外,UniFashion[522]通过两阶段流程将LLM和扩散模型集成,统一了检索和生成任务。开始,它通过语言模型理解描述,通过扩散模型捕捉视觉细节,进行预训练以理解时尚。然后,在第二阶段,通过实际图像和文本输入进行微调,提升其处理不同类型数据的能力,从而提高整体性能。
2.2.2 基准数据集
目前,时尚代理尚无特定的定量评估基准。这可能意味着时尚代理的评估可能更适合用户主观实验,例如调查问卷。然而,对于不同的下游任务,为Fashion Agent选择相应的下游任务基准是一种常见的做法。对于VQA,基准测试包括FashionVQA[448]。检索时使用表3中已经包含的FashionIQ[46 7]和Fashion-200K[154]。
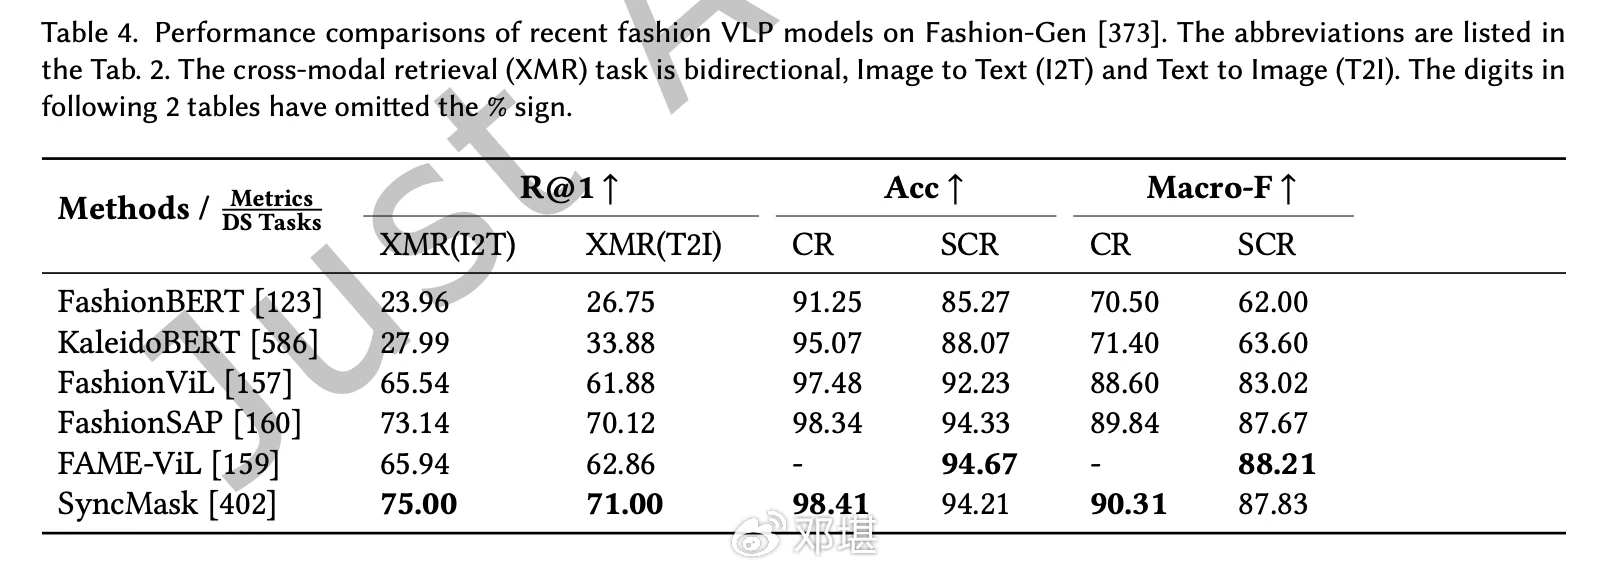
表4
2.3 评估指标
无论是时尚视觉语言还是时尚代理,具体的评估指标均由下游任务决定。对于检索任务[413],使用前k准确率指标(R @ K)。对于涉及识别和时尚图像描述的任务,准确率(Acc)是衡量有效性的主要指标。此外,Macro-F分数是评估分类模型的有用指标,尤其是在处理不平衡数据集时。
表4和表5列出了这些数据集上方法的性能比较,数字来自原始论文。对于生成任务,采用CLIP分数、初始分数(IS)和人工评估。在VQA任务中,指标是Top-1准确率。对于检索任务,采用R @ k、归一化折损累积增益(NDCG @ k)和平均精度(mAP)。
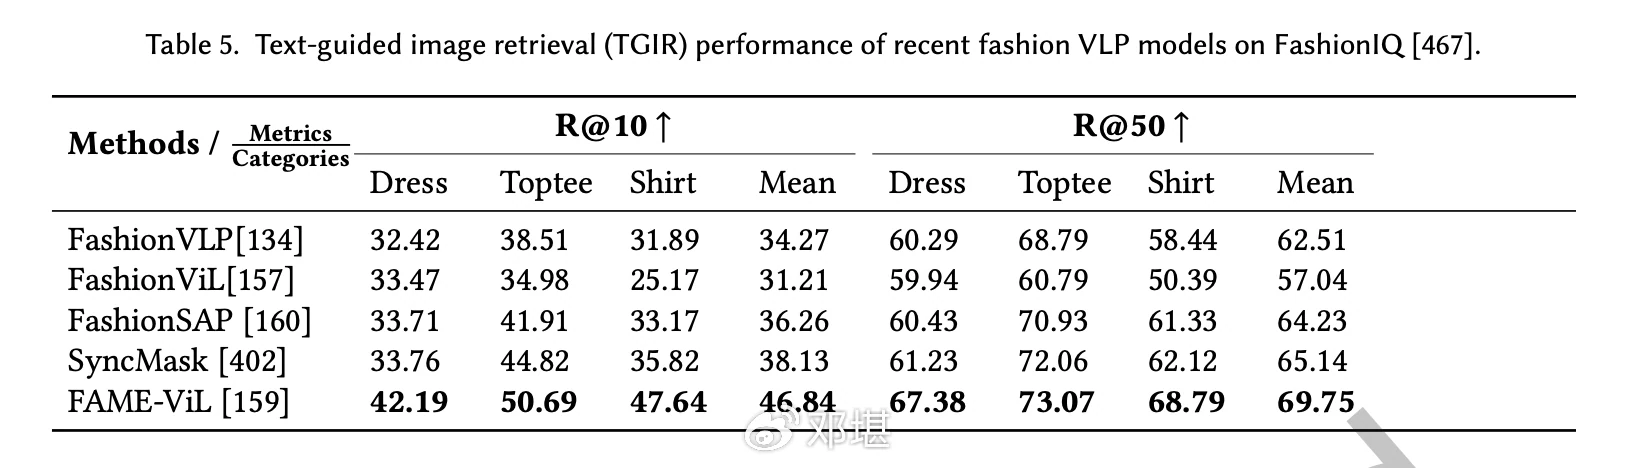
表5
3. 基于图像的时尚合成
时尚图像生成(第3.1节)关注合成完整的时尚单品(时尚图像中的全局区域),而时尚图像编辑(第3.2节)致力于修改特定属性(时尚图像中的局部区域)。基于图像的虚拟试穿(第3.3节)致力于将新服装图像整合到特定姿势的主体上,同时保持整体美学和谐。这三个不同的任务根据输入的差异进行分类,如图4所示。此外,基于图像的时尚合成的评估指标在第3.4节中总结。
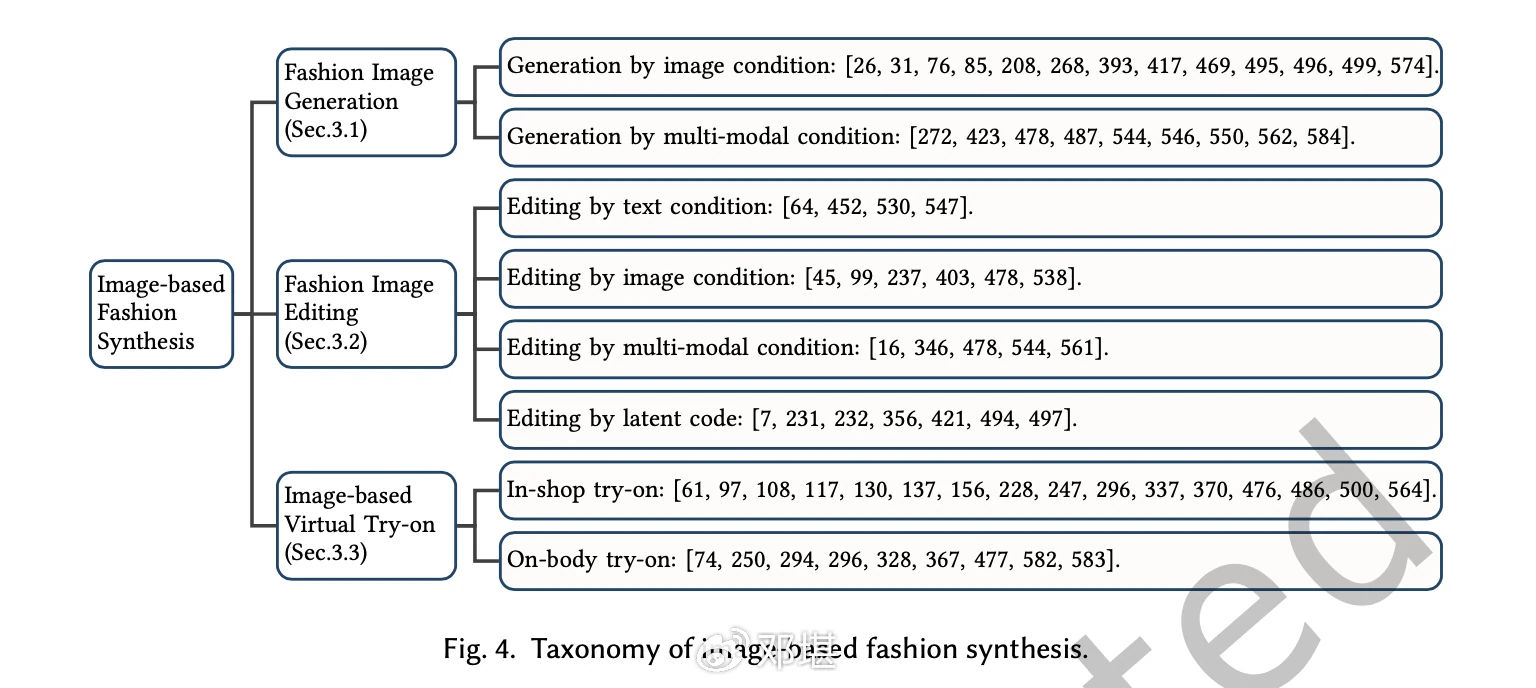
图4
3.1 时尚图像生成
3.1.1 方法
如图5所示,时尚图像生成的目标是基于不同输入(如结构或风格)生成全新时尚单品的图像。它也可以定义为有条件的图像到图像转换。根据不同的输入,时尚图像生成可分为基于图像条件的生成[26, 31, 76, 85, 208, 393, 417, 469, 495, 496, 499, 574]和基于多模态条件的生成[272, 423, 478, 48 7, 544, 546, 550, 562, 584]。根据不同的算法的生成,还可以分为基于GAN的方法[31, 76, 393, 423, 469, 495, 584]、基于Transformer的方法[546, 550]和基于扩散的方法[26, 478, 487, 496, 582]。
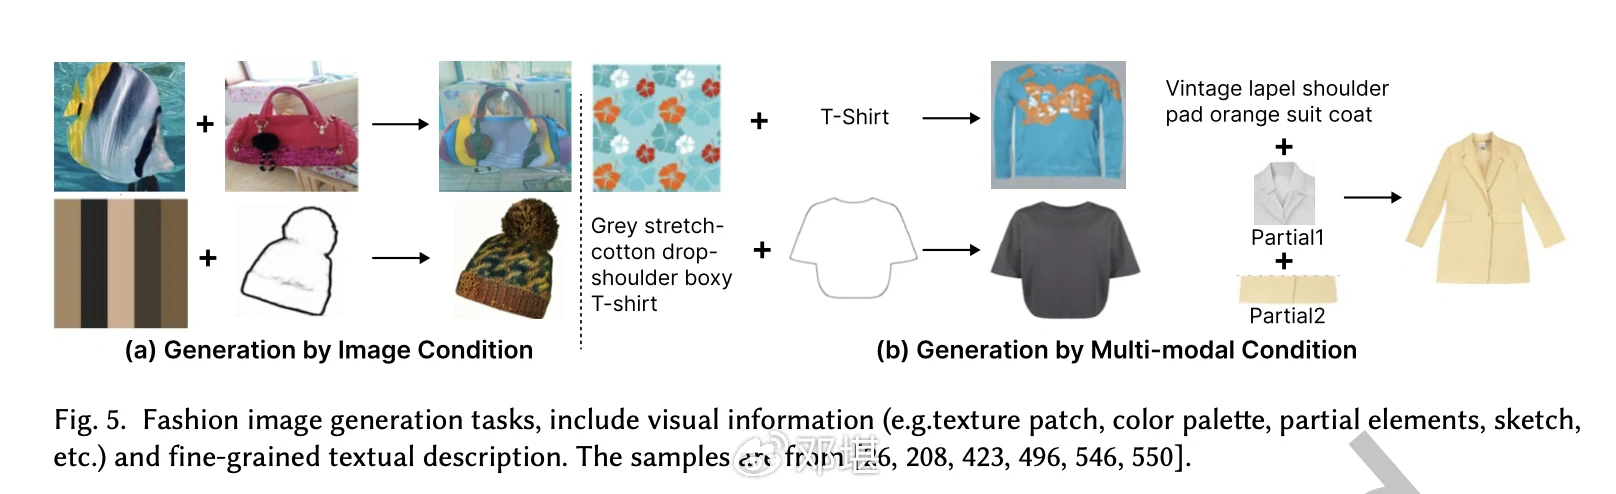
图5
此前,大多数基于图像条件的方法使用条件生成对抗网络(GANs)[31, 76, 393, 469, 495]开发。T extureGAN[469]是首个允许用户附加额外信息(如布料补丁)作为图像条件的深度图像合成方法,但其结果依赖于附加补丁的位置和大小。FashionGAN[76]通过将所需面料图像映射到选定的时尚草图或服装轮廓图像,通过将面料图像编码生成潜在向量并定义新颖的损失函数。为了更好地平衡可控性和多样性,TID[495]通过多条件特征交互模块结合草图与纹理,而ID-GAN[393]引入了跨域特征融合编码器网络。随着扩散模型最近的兴起,[26, 478, 487, 496]利用更多样化的灵感元素生成新单品,如海洋生物图像[26]和客户的交互历史[487]。
基于多模态条件的生成遵循与基于图像条件的生成类似的轨迹,最初由GAN[584]等方法主导,逐渐转向扩散模型[423]。除此之外,图像条件被处理为视觉标记,与Transformer方法中的文本标记一起作为输入。ARMANI[546]利用带有跨模态码本的跨模态预测Transformer,从而能够从文本、草图或部分图像生成逼真的图像。类似地,UFC-BERT[550]采用基于Transformer的多模态统一框架,使用非自回归生成确保图像一致性。
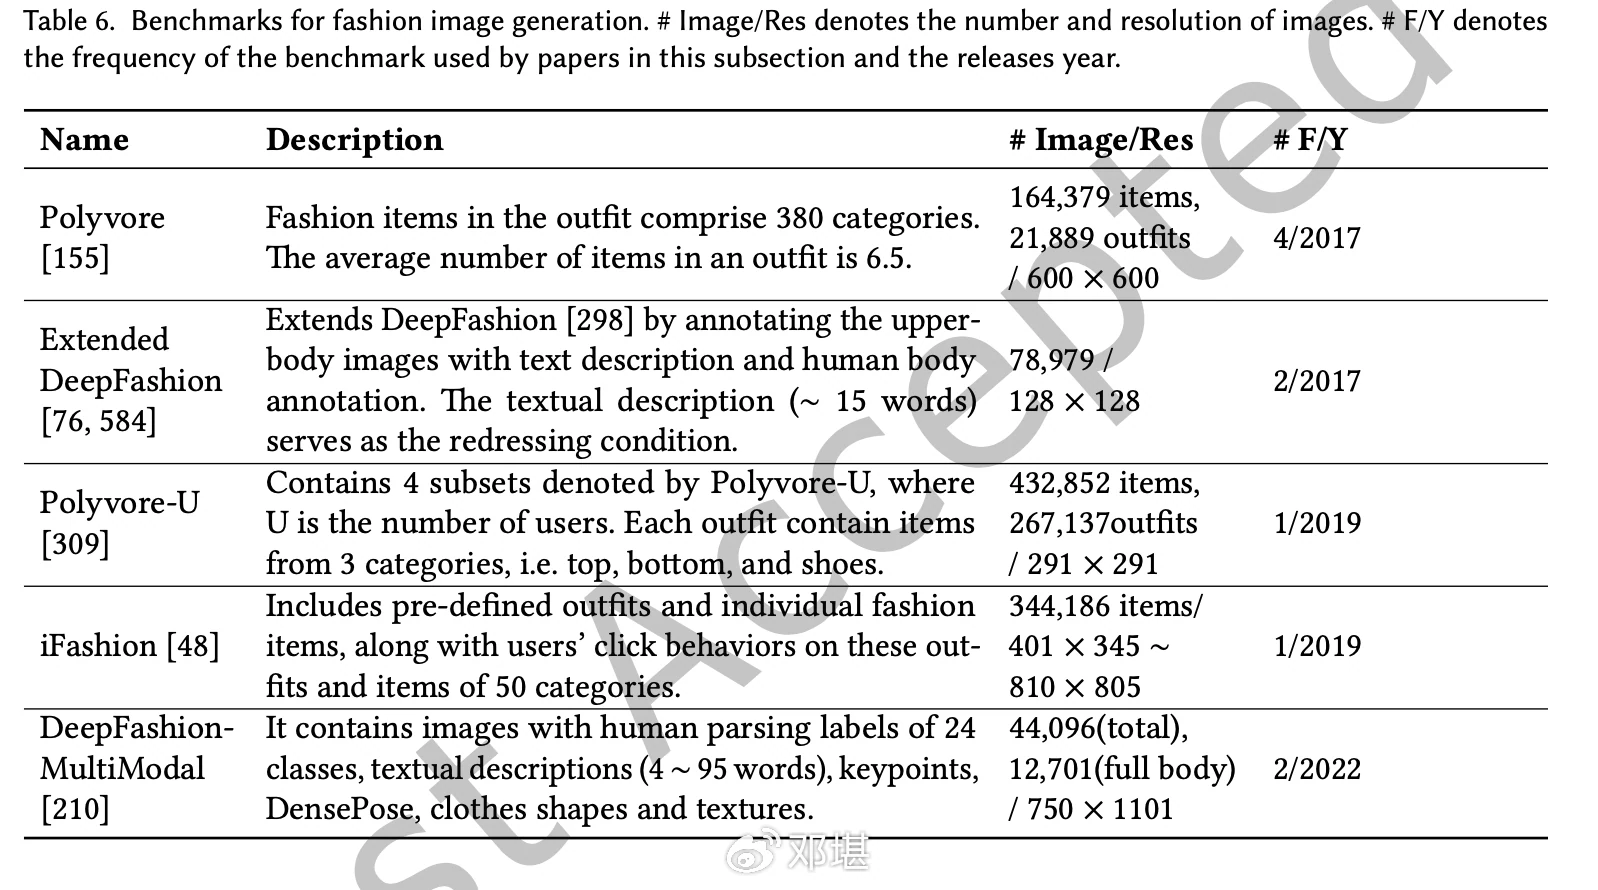
表6
3.1.2 基准数据集
由于时尚类别的多样性和生成任务的灵活性,缺乏统一的基准导致大多数工作依赖私有的自制数据集[26, 76, 268, 423, 496, 498, 546, 550, 574]。表6列出了公开可用的基准,如[76, 584]和[210, 272]。
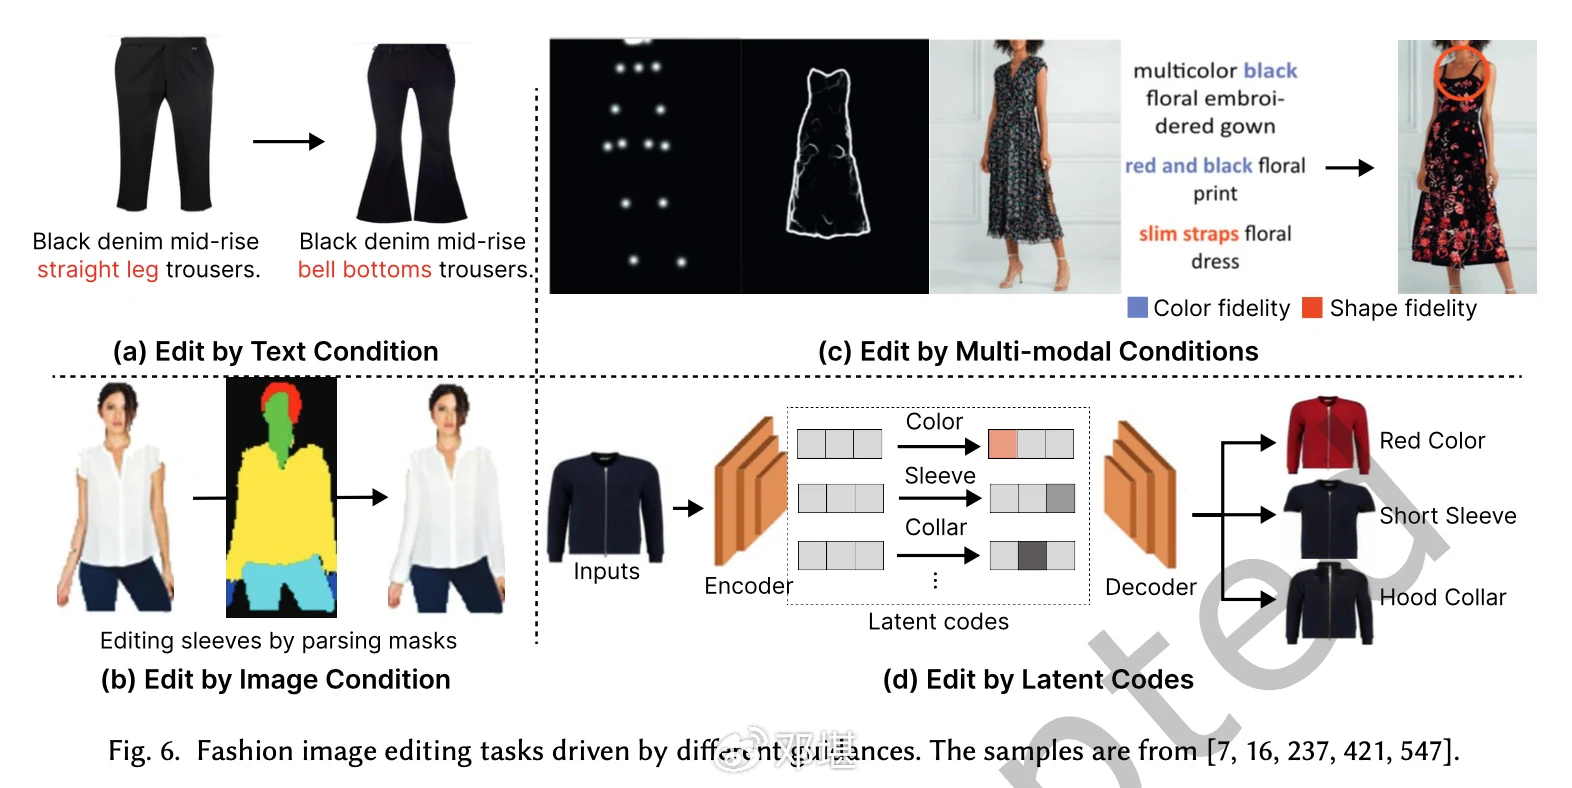
图6
3.2 时尚图像编辑
3.2.1 方法
与旨在创建整个艺术感(图像的全局区域)的时尚图像生成不同,时尚编辑专注于修改单品的特定属性(图像的局部区域),如图6(a)-(d)所示。时尚图像编辑可分为基于显式条件的编辑(如文本[64, 452, 530, 547]、图像[45, 99, 237, 403, 538]和多模态条件[16, 346, 427, 544, 561])和基于潜在代码的编辑[7, 231, 232, 356, 421, 494, 497]。
对于基于图像条件的编辑,开发了各种GAN方法,如FE-GAN[99]、TailorGAN[45]、PISE[538]和VP TNet[237],利用视觉线索(如解析图)操纵时尚图像。时尚编辑生成对抗网络(FE-GAN)[99]是一项代表性工作,其时尚编辑方法基于草图和稀疏颜色条件。与依赖标准卷积和归一化层的先前方法不同,FE-GAN通过特殊的注意力归一化层注入条件,从而实现更精确和可控的时尚图像操作。在基于文本的编辑方面,扩散方法尤其借助CLIP[365]变得流行。
然而,直接通过CLIP处理文本(提示)作为编辑条件会导致服装部分泄漏、属性混淆和区域不一致等问题。为解决这些问题,DiffCloth[547]构建了一个时尚语言结构,通过二分匹配实现结构语义对齐,从而在属性级别实现精确编辑。为实现更广泛的编辑可能性,研究人员提出了基于多模态条件的编辑方法。例如,MGD[16]是一种基于扩散的模型,能够生成适合人体图形的时尚图像。它响应多种输入,包括文本、人体姿势和服装草图。与传统的修复方法不同,MGD选择性地保留或移除指定区域内的特定信息以满足编辑目标。
在潜在代码操作方面,这类方法几乎都是基于GAN的。AMGAN[7]通过使用激活图和感知损失进行属性操作,针对现有GAN的局限性,专注于特定区域(如袖子)。Fashion-AttGAN[356]增强了AttG AN的目标,以提高时尚编辑效果。然而,独立控制纹理仍然具有挑战性。为解决这一问题,Rank i n Style[231]使用CLIP[365]导航StyleGAN[223]的潜在空间,而InspirNET[494]引入了无监督解耦框架以实现细粒度纹理解耦。
这些基于潜在代码的编辑方法既不具扩展性也不通用,因为它们仅适用于少数有限属性。因此,Ko ng等人[232]提出了一种分类器引导的扩散流程,通过在去噪过程中微调ViT实现更可扩展的属性编辑。为适应更多样化的编辑条件,PFNet[421]引入了一种无监督服装属性解耦网络,通过分层风格控制和最小化互相关性独立编码属性。
3.2.2 基准数据集
与时尚生成任务类似,大多数工作依赖于私有的自制数据集[64, 99, 237, 346, 403, 427, 530, 538, 5 44, 547],少数公开可用的基准列于表7中。此外,以往的时尚数据集通常关注全局描述,缺乏可以指导精确局部编辑的局部描述信息。相反,GarmentSet[45]、Dress Code[338]和DFMM-Spotlight[4 52]专注于服装和配饰的局部区域,支持通过文本或图像输入进行局部编辑。
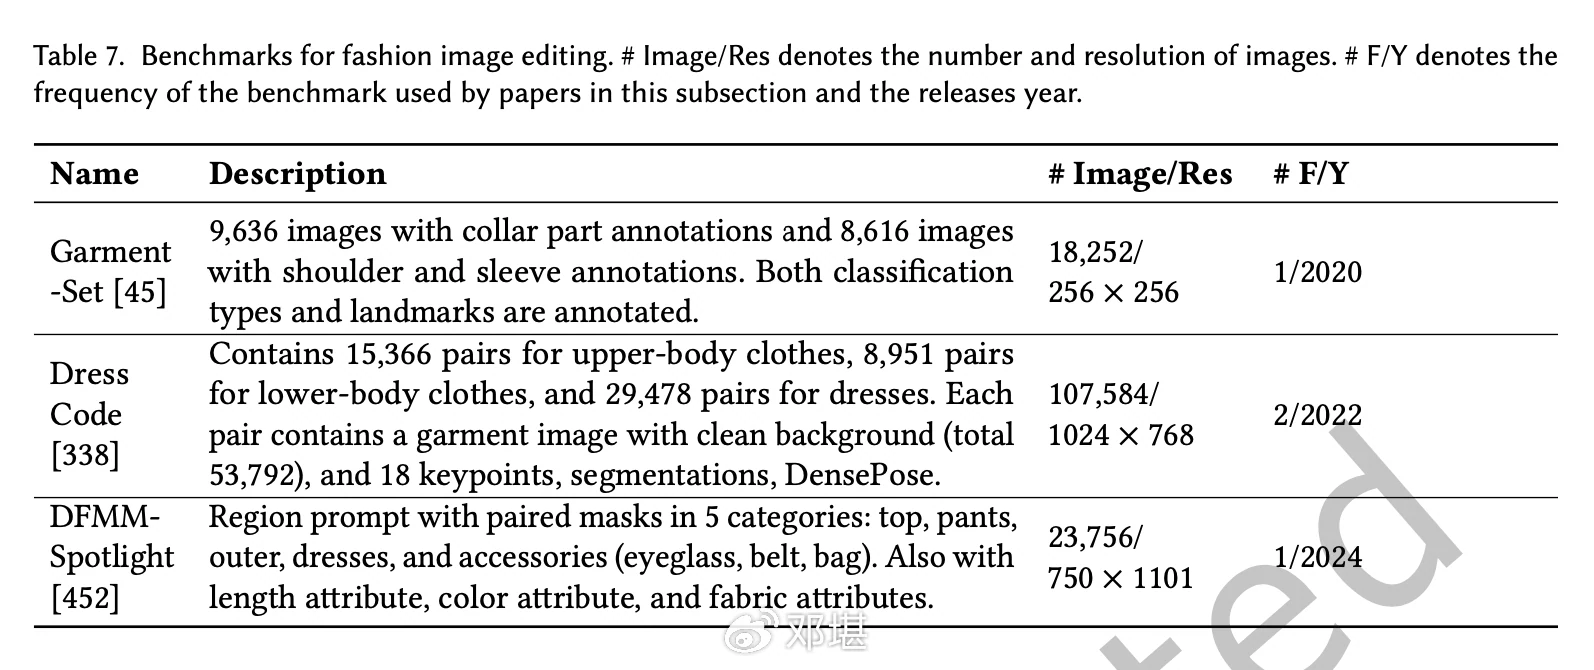
表7
3.3 基于图像的虚拟试穿
3.3.1 方法
虚拟试穿任务旨在将新服装适配到特定姿势的人体上。该任务的方法根据使用的输入大致分为两类。
涉及店内服装图像,主要挑战是将服装转换并匹配到目标身体,如图7(a)所示。
涉及穿在身上的服装图像,需要在转移前对覆盖区域进行精确分割和修复,如图7(b)所示。
大多数虚拟试穿方法属于第一类[61, 97, 117, 130, 137, 156, 228, 247, 337, 370, 476, 486, 564]。然而,这些方法需要耗费大量人力创建配对训练数据集,这显著限制了其可扩展性。第二类方法尝试直接将服装从一个人转移到另一个人,减少了对配对数据集的需求,但由于缺乏配对数据,其性能受到影响。特别是,从穿在身上的服装图像中解耦服装的详细信息仍然是一个挑战[250, 294, 296, 3 28, 367, 477, 583]。
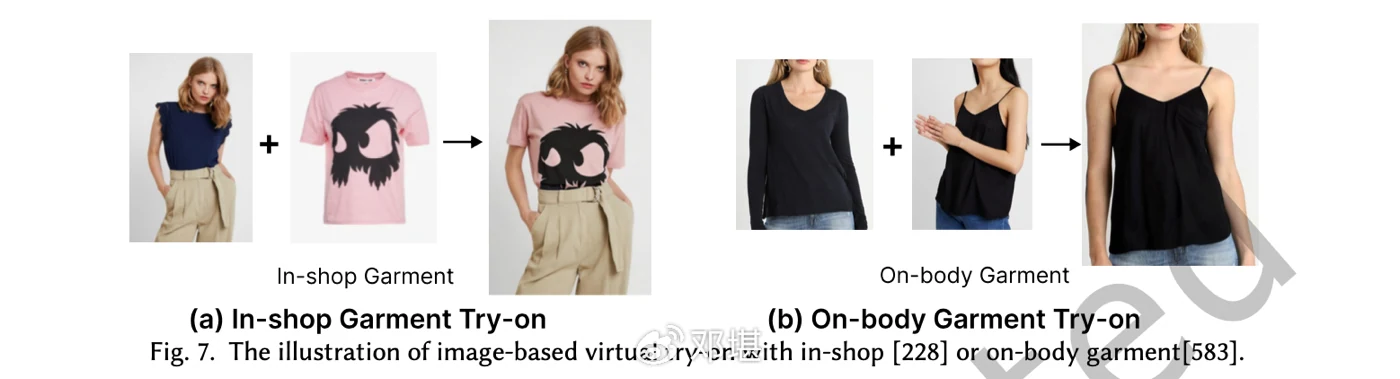
图7
这些试穿方法可以根据骨干算法分为基于GAN的方法[61, 130, 247, 250, 328, 476, 477, 564]、基于Transformer的方法[117, 370]和基于Diffusion的方法[137, 228, 337, 486, 583]。
现有的基于GAN的方法通过实施两阶段方法解决虚拟试穿问题:(1)将服装重塑以适应目标区域,(2)使用依赖GAN的试穿生成器整合调整后的服装[228]。虚拟试穿网络(VITON)[156]是这些方法的里程碑。在此之前,传统方法使用3D建模技术实现逼真的服装模拟,但3D注释数据限制了其大规模部署。因此,VITON提出了一种基于图像的虚拟试穿方法,仅依赖普通RGB图像而不利用任何3D信息。它引入了几何变形以将店内服装与参考个体对齐。
接下来,研究人员围绕提高视觉效果和可扩展性展开了一系列工作。MG-VTON[97]是首个尝试多姿势引导的虚拟试穿系统,使服装能够适配到具有多样姿势的人体上。它提出了一个条件人体解析网络和一个细化网络,以将服装与任何姿势对齐。这些基于GAN的方法依赖卷积神经网络(CNNs),难以捕捉输入像素之间的长距离连接,常导致斑驳或不一致的结果。
为解决这一问题,研究人员开始使用基于Transformer的方法。DBCT[117]引入了一个双分支协作模块以利用跨模态信息。CIT[370]捕捉与服装无关的人体信息和店内服装之间的长距离相关性,然后在人体表示、变形服装物品和相应变形服装掩码之间建立交互依赖关系。
此外,基于Diffusion扩散的方法最近变得越来越流行,因为扩散模型已成为最强大的生成模型家族。TryOnDiffusion[583]以并行-UNet架构开创了这一方法。LaDIVTON[337]引入了一种文本反转方法,将服装特征转换为CLIP标记嵌入以指导生成,保留纹理和细节。DCI-VTON[137]采用基于范例的修复和变形模块以保持服装细节。StableVITON[228]提出了零交叉注意力块,不仅通过学习语义对应保留服装细节,还利用预训练模型的固有知识生成高保真图像。
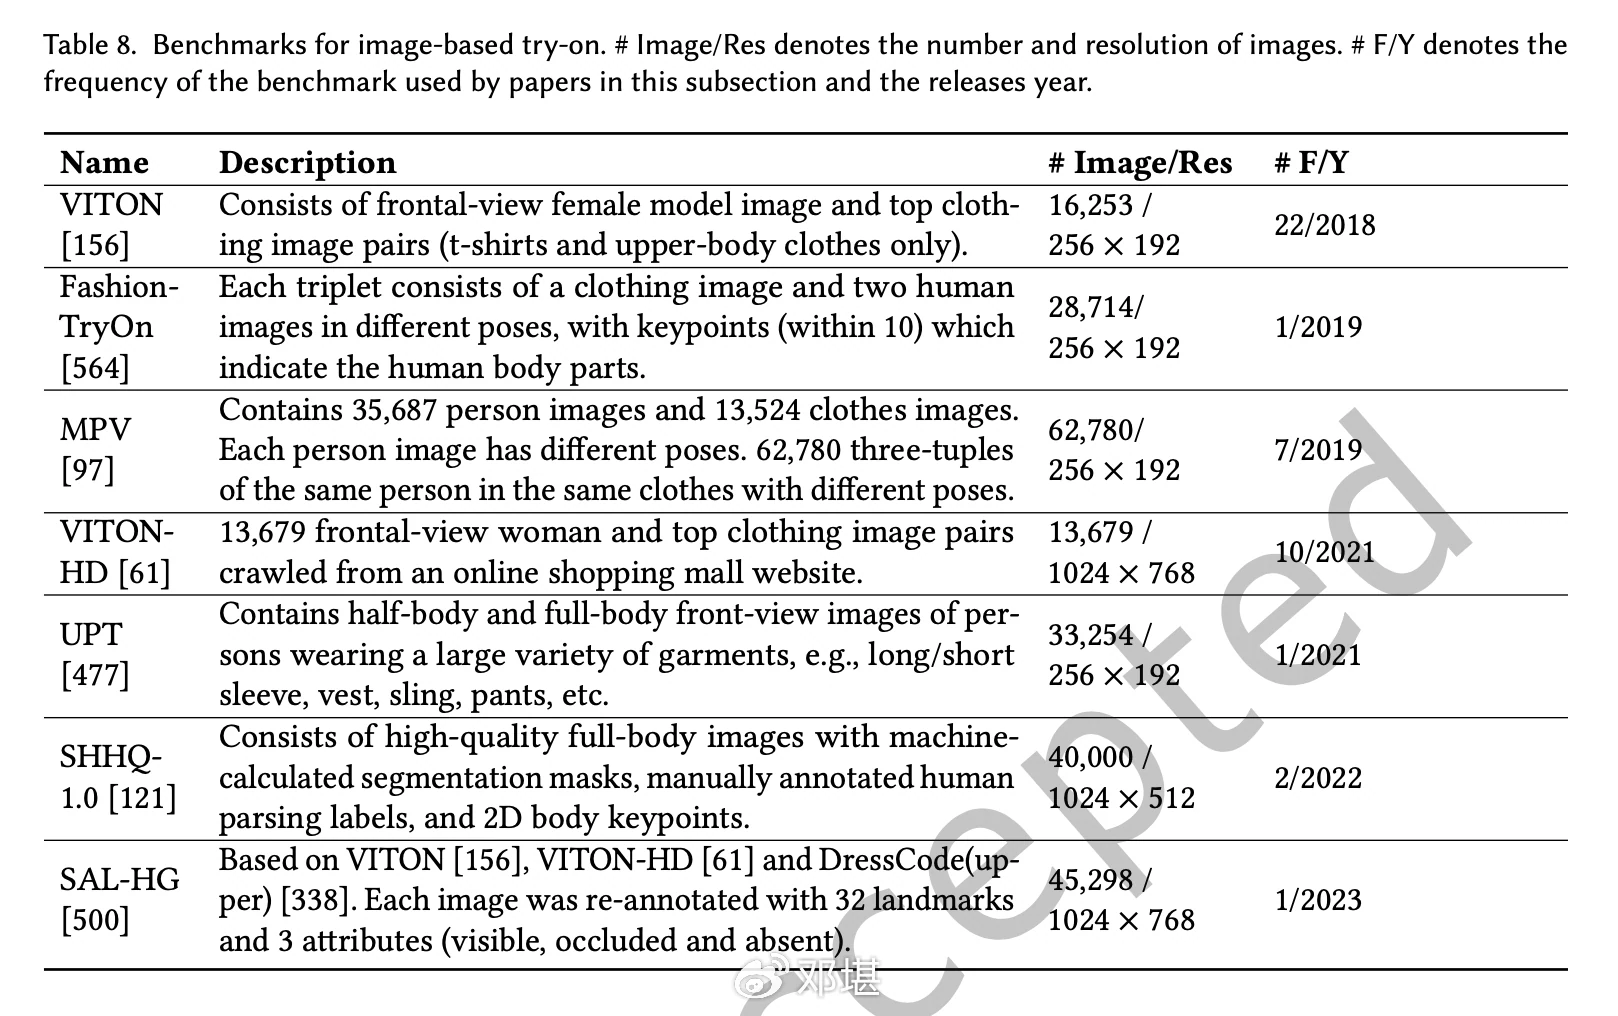
表8
3.3.2 基准数据集
公开可用的基准数据集详见表8。其中,VITON[156]是最常用的数据集。其他如FashionTryOn[564]、MPV[97]和SAL-HG[500]因其包含多姿势、关键点和地标而值得注意。此外,SHHQ-1.0[121]特别关注全身图像,而UPT[477]专注于穿在身上的服装试穿。
此外,多项研究[75, 182, 272, 294, 296, 313, 367]选择使用DeepFashion[298]或DeepFashion-MM[210]进行虚拟试穿与编辑任务(见表6)。最近,越来越多的研究[228, 337, 486]同时使用VITON-H D[61]和Dress Code[338](见表7)作为基准。还观察到Dress Code[338]在本小节讨论的论文中被使用了8次(基于图像的虚拟试穿)。表9总结了常见基准上最新方法的性能。
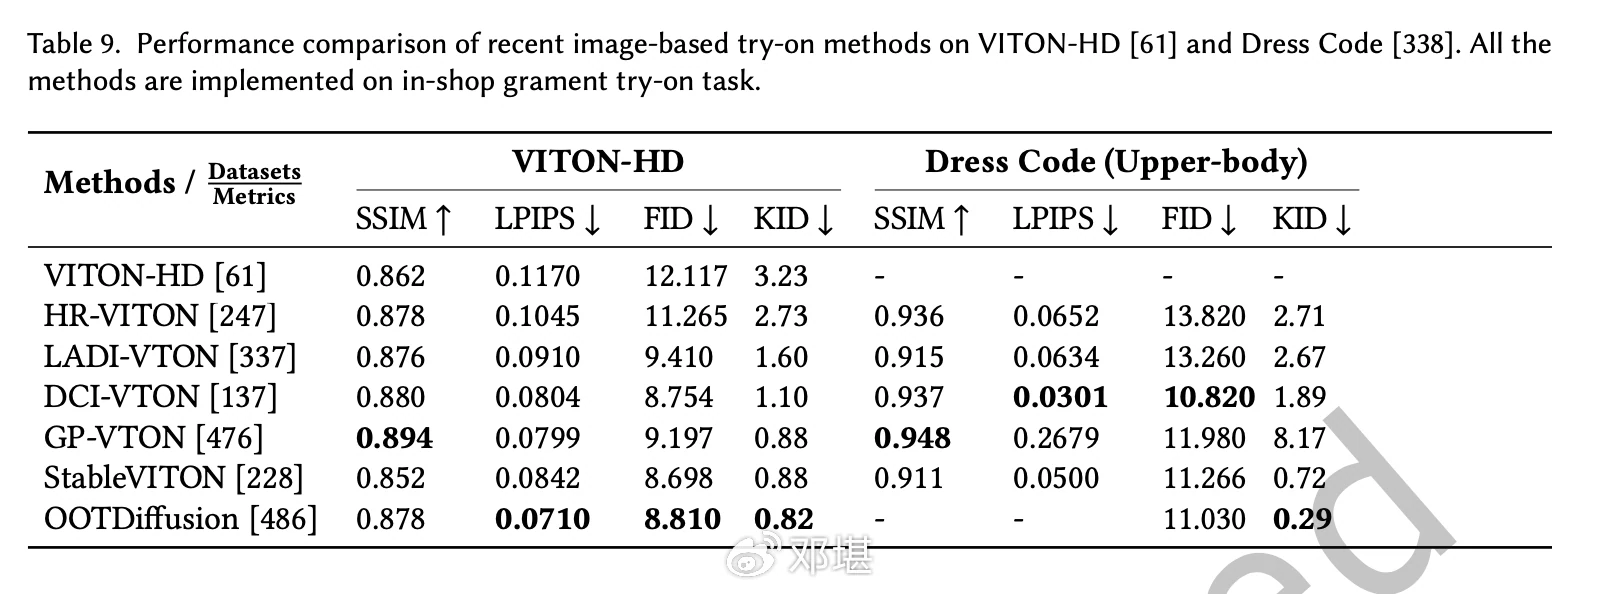
表9
3.4 评估指标
时尚图像生成和编辑任务以及基于图像的虚拟试穿与一般图像生成任务共享常见的评估指标。这些指标包括SSIM、LPIPS、FID和KID。
结构相似性指数(SSIM)[458]通过亮度、对比度和结构测量图像相似性。峰值信噪比(PSNR)[4 58]通过均方误差比较生成图像与原始图像。初始分数(IS)[378]通过初始网络进行评估。CLIP分数[365]量化生成图像与文本描述的相关性。Frechet初始距离(FIDs)[170]比较从初始网络提取的深层特征。学习感知图像块相似性(LPIPS)[543]通过比较特征距离计算感知相似性。
除此之外,其他指标如分类错误、兼容性评估准确率和核初始距离(KID)[424]也用于比较。此外,Ren等人[370]通过Jaccard分数(JS)[198]评估模型在匹配目标服装类型方面的表现,该分数基于解析分割区域计算。
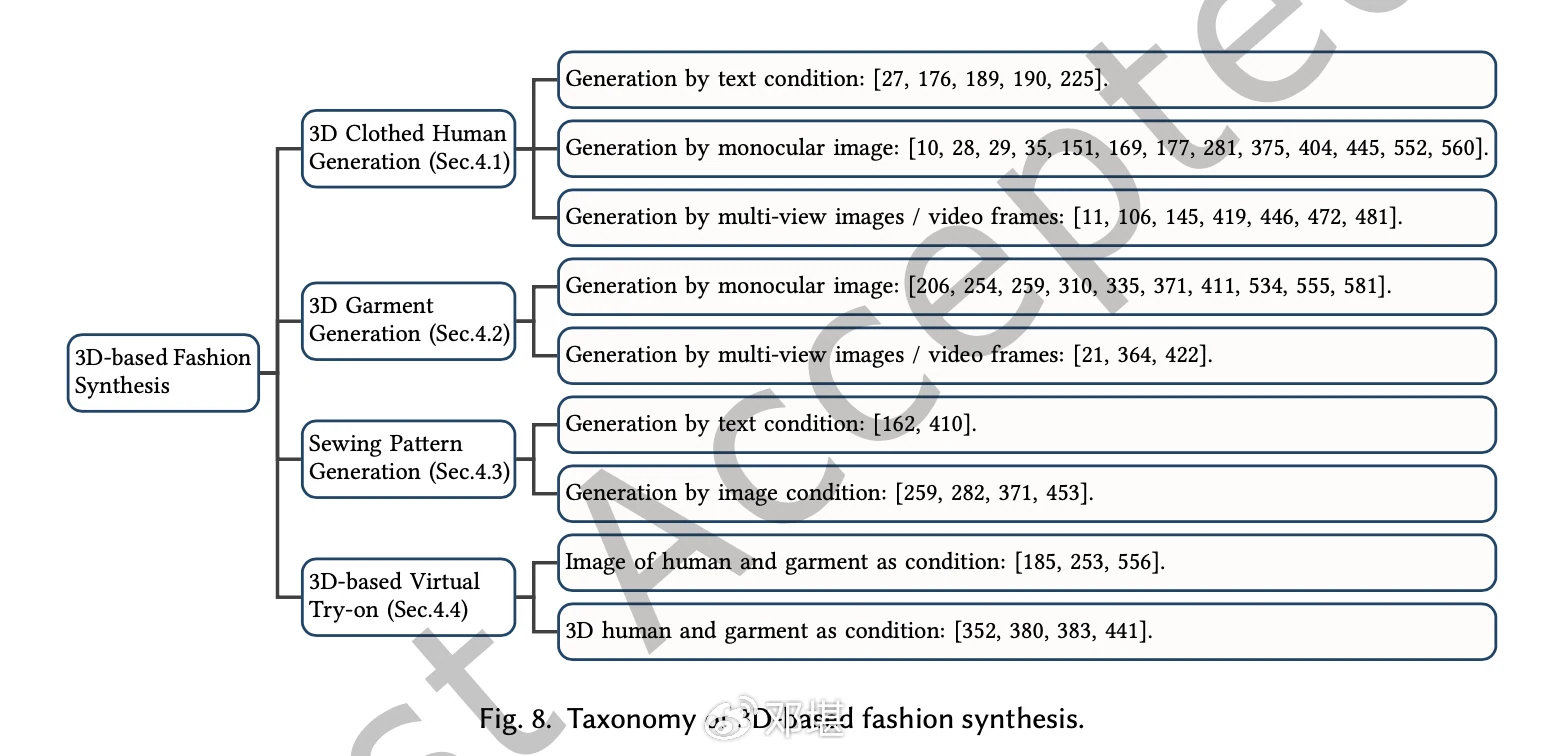
图8
4. 基于3D的时尚合成
根据不同的输出,我们将基于3D的时尚合成分为3D着装人体生成(第4.1节)、3D服装生成(第4.2节)和缝制裁片生成(第4.3节)。此外,3D虚拟试穿(第4.4节)因其关注服装与人体之间的相互作用而备受关注。
3D着装人体生成涉及生成穿着服装的详细3D人体模型。相比之下,3D服装生成则是将服装作为独立或分层的元素创建在身体上,为内容创作提供多样化的3D资产。缝制裁片对于调整服装合身度和指导工厂中特定服装的大规模生产至关重要。它们在快速发展的时尚行业中扮演着关键角色,是制作逼真数字人体模型不可或缺的部分。
3D虚拟试穿旨在生成服装与人体和谐搭配的3D模型,同时保留合理的交互,如身体与服装[352, 383, 441]以及服装之间的碰撞[380]。此外,每项任务根据不同的输入进一步细分,如图8所示。此外,不同3D时尚合成任务的评估指标在第4.5节中总结。
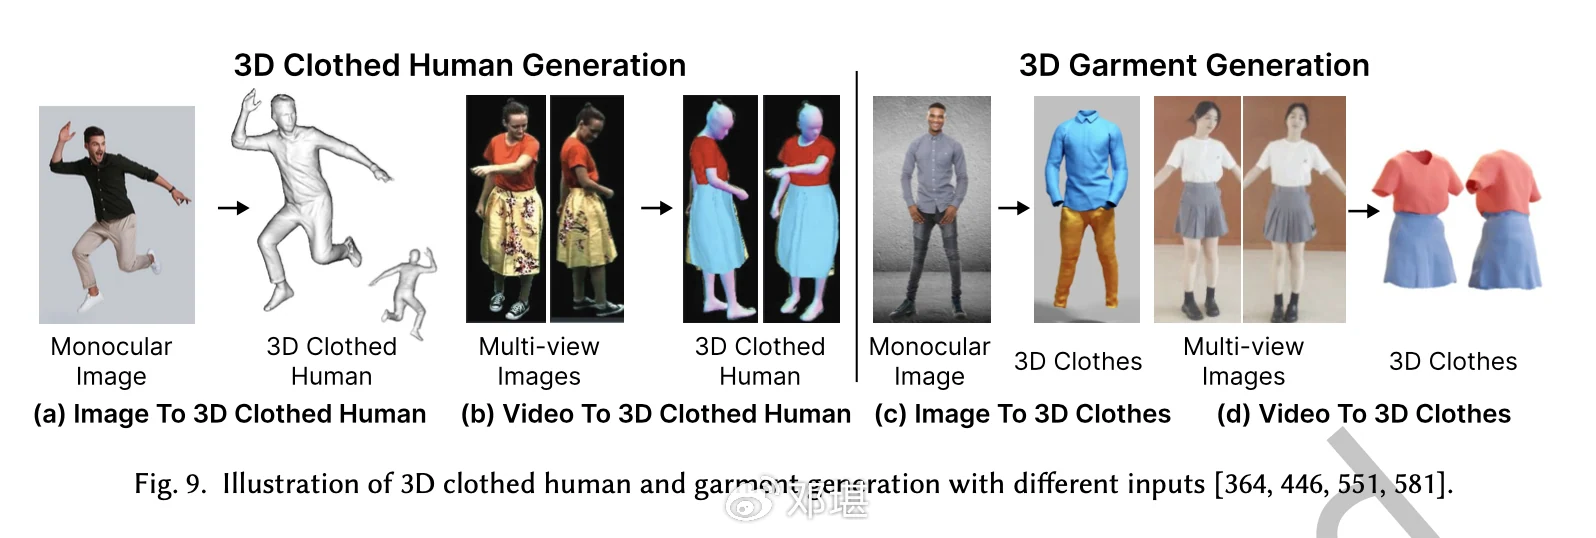
图9
4.1 3D着装人体生成
4.1.1 方法
与3D人体生成[447]不同,3D着装人体生成涉及从各种输入(如文本描述[27, 176, 189, 190, 225]、单目图像[28, 29, 35, 151, 169, 177, 259, 281, 375, 404, 445, 513, 552, 560]和多视角图像(视频帧)[11, 106, 145, 419, 446, 472, 481])生成穿着服装的详细3D人体模型,如图9(a)和(b)所示。这一过程旨在准确生成不仅包括人体形状和姿势,还包括身体上服装的几何形状和纹理。在此背景下,3D着装人体生成通常将人体和服装视为一个整体的3D模型。
传统的建模人体方法通常依赖参数化模型,如蒙皮多人线性模型(SMPL21)[305]生成基本人体形状。这些模型可以通过网格顶点的自由形式变形增强,引入变化以模拟服装对几何形状的影响。这种方法已有多种实现,以捕捉着装人体的更精细细节[10, 243, 316]。Octopus[10]从语义分割图像重建包括SMPL参数的3D形状以及服装和头发。类似地,Lazova等人[243]从单张图像重建3D虚拟形象,但专注于推断SMPL模型的UV空间中的纹理和几何形状。CAPE[316]采用条件MeshVAE-GAN训练学习SMPL模型上的服装褶皱变形,将服装类型作为附加条件。它能够为不同体型和姿势绘制服装样本。
新兴方法通过集成隐式函数表示[28, 375]和立体视觉[177, 472]实现了显著提升,以实现高保真重建。PIFu[375]提出了一种像素对齐的隐式函数,将图像像素与相应3D对象的全局上下文对齐。后续方法通过整合3D对齐特征[28, 177]和深度信息[404]改进了生成结果。例如,StereoPIFu[177]将立体视觉的几何约束与PIFu[375]的隐式函数表示结合,从校正的立体图像对中恢复着装人体的3D形状。而DIFU[404]采用了投影深度先验,其中包含通过2D编码器和3D编码器分别提取的像素对齐特征和体素对齐特征。
对于视频输入,MonoClothCap[472]从单目RGB视频中捕捉时间连贯的动态服装变形,无需预先扫描个性化网格模板。为解决提取服装语义和捕捉服装运动的不稳定性,Wang等人[446]提出了用于身体和服装的双层神经辐射场(NeRFs),并通过联合优化变形场和规范双层NeRFs跟踪服装和身体的密集变形模板。
4.1.2 基准数据集
表10展示了为3D着装人体生成设计的可用基准。THuman-2.0[521]和BUFF[533]是最常用的数据集。大多数数据集,如DeepCap[151]、People Snapshot[111]、DynaCap[150]、MonoPerfCap[484]提供SMPL模板,而LifeScans[10]提供了非刚性注册的SMPL+D,支持使用SMPL改变基础体型和姿势。此外,许多研究[122, 128, 177, 225, 243, 281, 342, 375, 480, 551]选择直接使用来自Renderpe ople和Axyz-design等平台的免费或购买的3D模型。
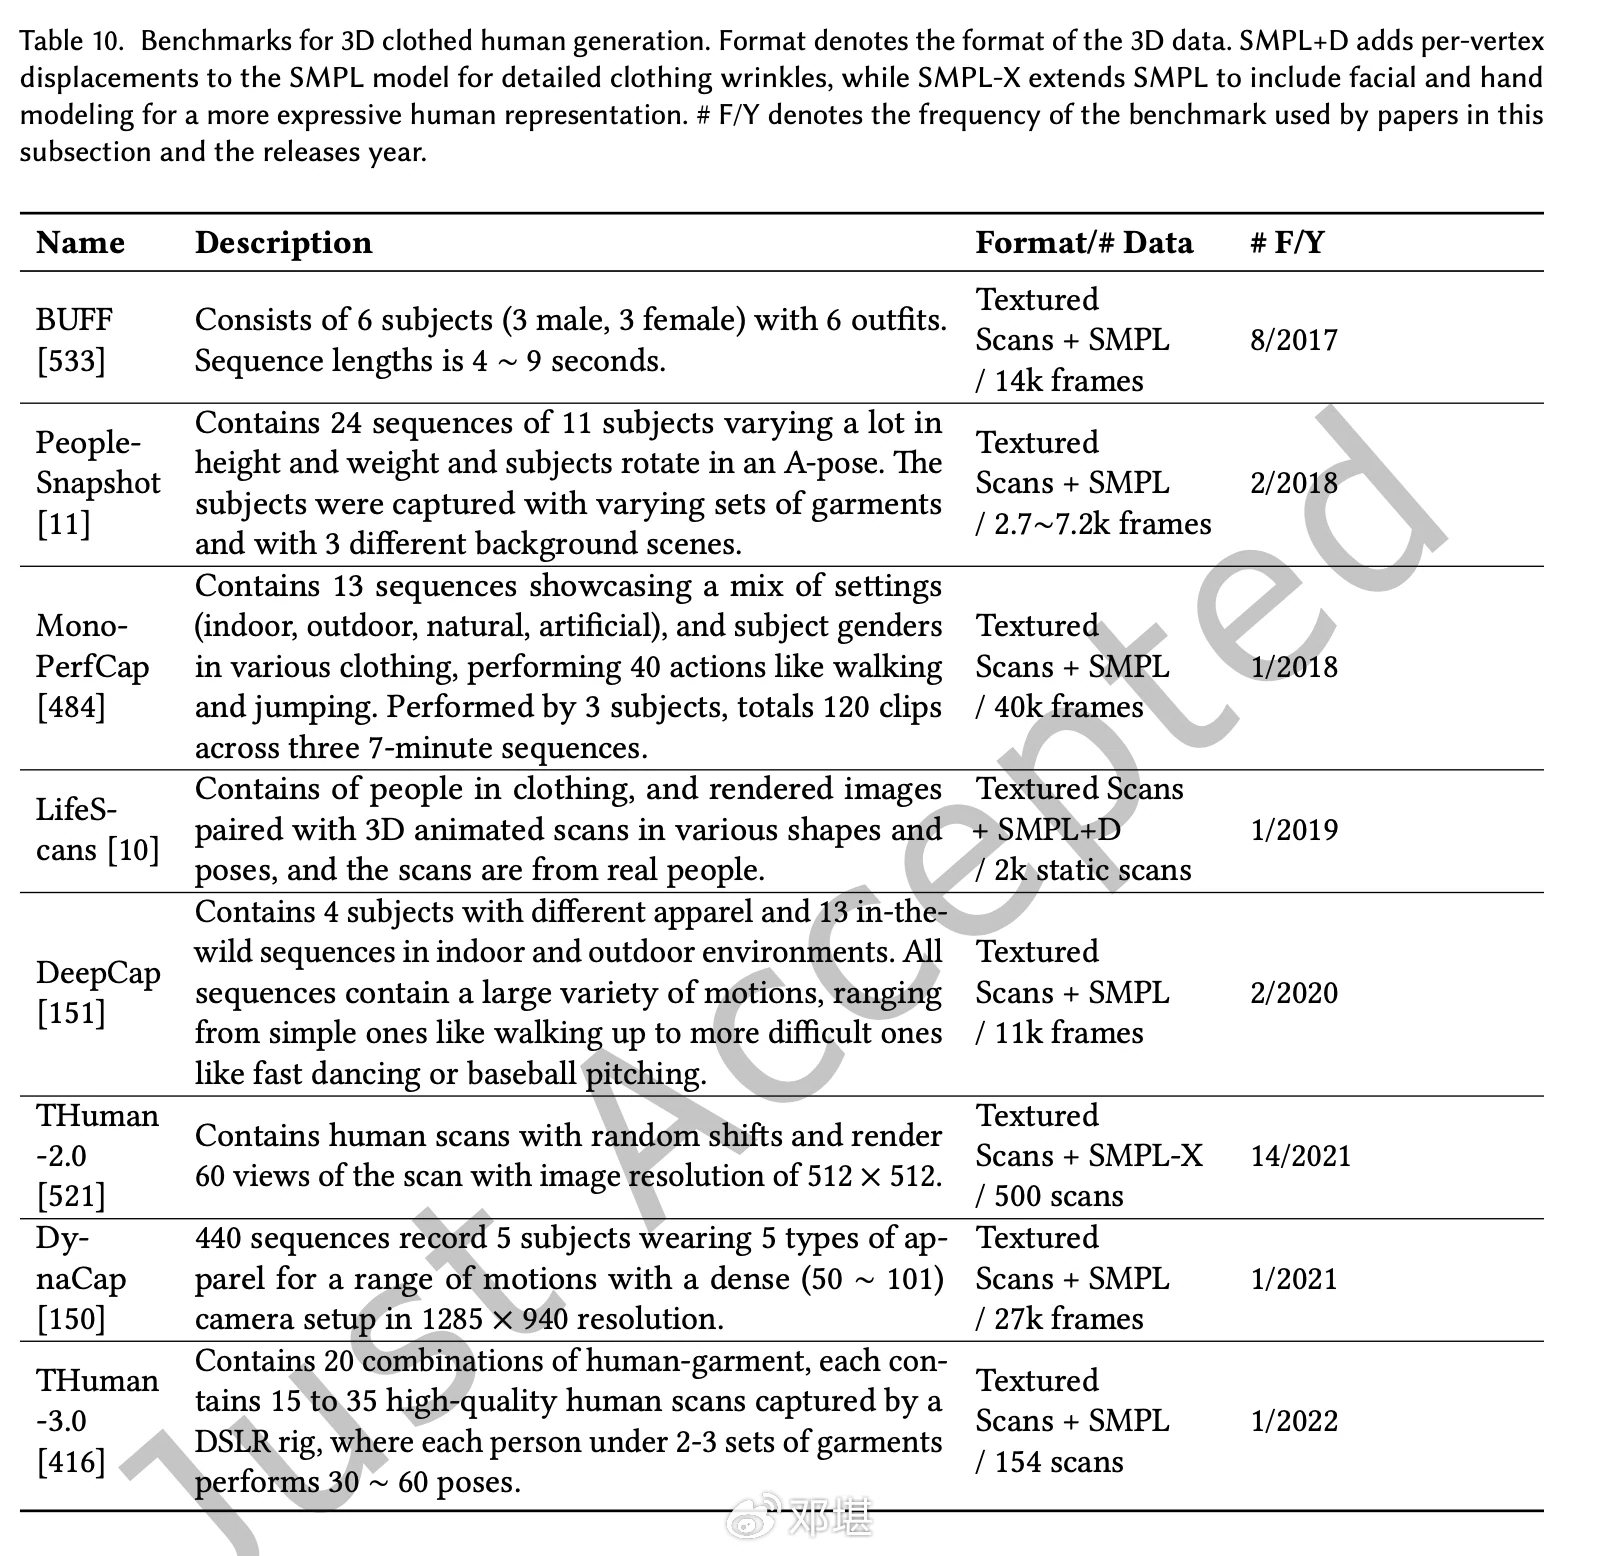
表10
4.2 3D服装生成
4.2.1 方法
与3D着装人体生成相比,将服装网格作为独立或多层身体元素创建为内容创作提供了多样化的资源,输入可以是单目图像[206, 254, 259, 310, 335, 371, 411, 534, 555, 581]或多视角图像(视频帧)[21, 364, 391],如图9(c)和(d)所示。对于单目图像输入,BCNet[206]从单一近前视角彩色图像重建服装和体型,基于SMPL的分层表示和独立的服装蒙皮权重。AnchorUDF[555]通过无符号距离场(UDFs)[60]建模开放式服装表面,利用像素对齐的局部图像特征和位于表面周围的锚点捕捉多样拓扑。ClothWild[335]实施了一种弱监督流程,以减轻训练数据集与现实世界数据集之间的领域差距。
现有方法要么假设服装几何的预定义模板(限制其适用于固定服装风格),要么生成顶点着色的网格(缺乏高频纹理细节)。为解决这些问题,xCloth[411]提出了一个框架,从输入的单目图像中共同学习服装表面的几何和语义信息,实现无模板的纹理3D服装数字化。
隐式方法在生成分离且拓扑一致的每件服装网格方面仍有局限。为解决这一问题,ReEF[581]通过将显式模板注册到从单张图像预测的隐式场中,重建拓扑一致的网格。对于多视角图像输入,MGN[21]提出了一种用于3D扫描分割和服装注册的流程,可以预测可分离的服装和规范姿势下的基础人体形状。REC-MV[364]优化了3D服装特征曲线和隐式有符号距离场(SDF),确保从视频帧中生成时间一致的服装。表11总结了最新方法的性能,数据来自[551, 552]。
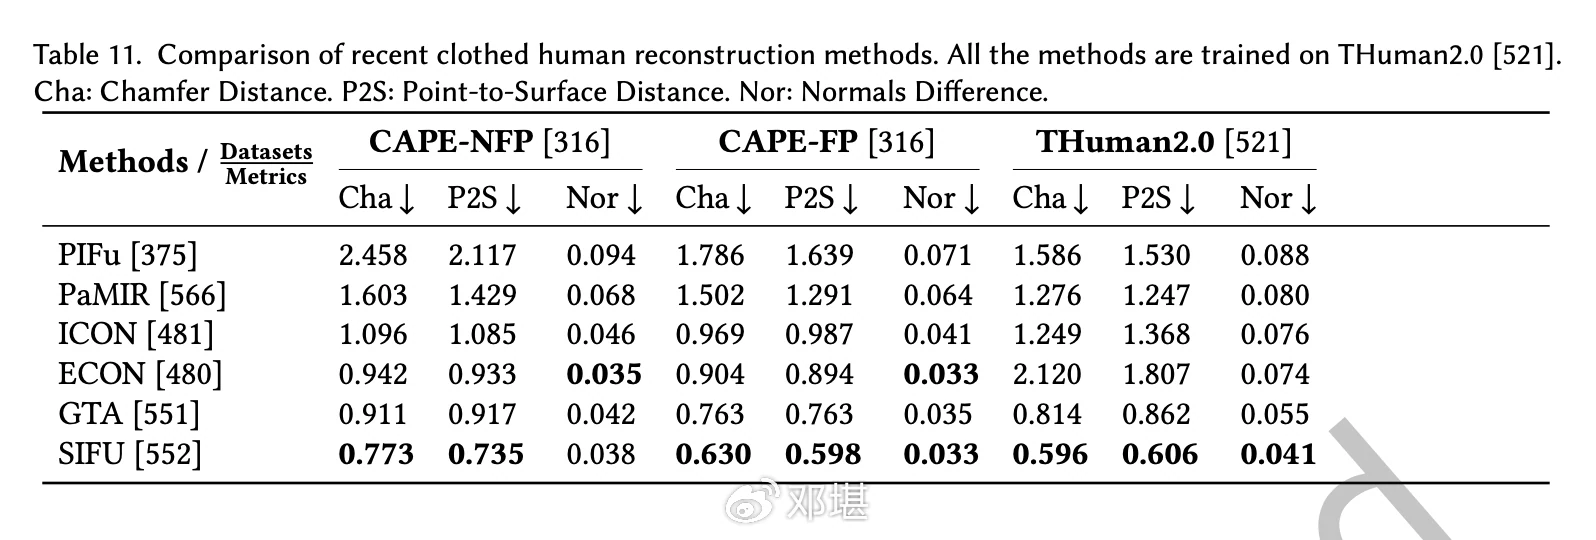
表11
4.2.2 基准数据集
3D服装生成与3D着装人体生成共享一些基准,例如xCloth(Zhang等人2019)使用THUman-2.0(Wang等人2021a),而其他(Yang等人2021a)使用People-Snapshot(Zhang等人2018b)。表1 2展示了仅包含3D服装实例的可用基准,这些更适合3D服装生成。
Digital Wardrobe(Wardrobe 2008)通过多网格注册扫描,使注册后的扫描可以重新摆姿势和重塑,从而支持进一步的数据增强。Deep Fashion3D(Liu等人2017)覆盖更多服装类别和更详细的注释,如多视角真实图像、3D特征线和3D身体姿势。考虑到涉及复杂变形(如人体-服装或服装-环境交互)的场景,GarVerseLOD(GarVerse 2016)收集了三个具有不同细节级别的基本数据库,以获得具有变形的高质量3D服装。一些研究人员(Kumar等人2021)由于缺乏具有不同服装和体型尺寸及姿势的公开数据集以及相应的彩色图像,选择构建私有数据集。
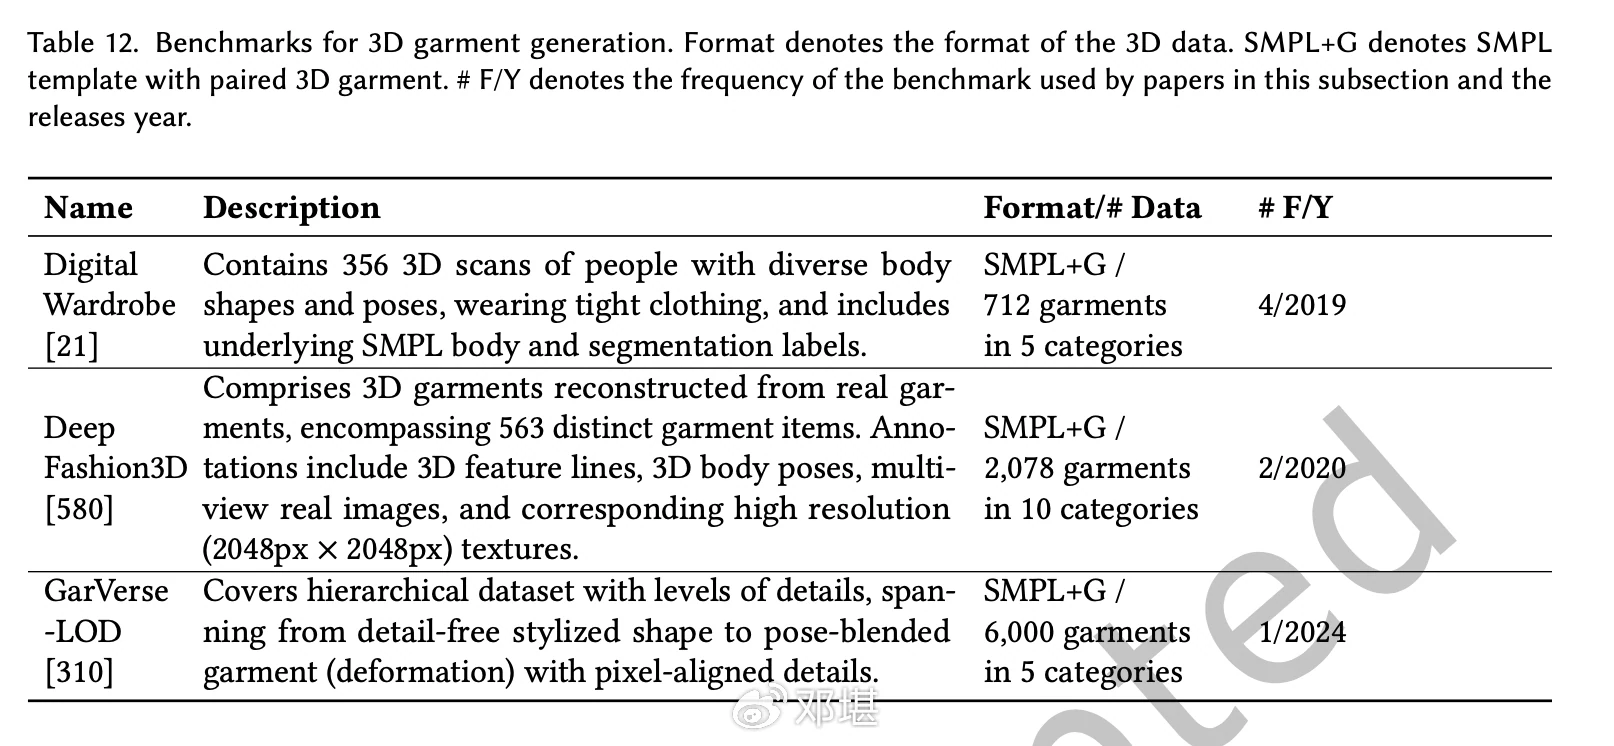
表12
4.3 缝制裁片生成
4.3.1 方法
缝制裁片指导工厂中特定服装的生产(时尚行业中立体剪裁的详细含义见A.3),在快速发展的时尚行业和创建逼真数字人体模型中至关重要,如图10(c)所示。缝制图案生成在从文本[162]或图像[3 7, 259, 282, 371, 453](如图10)以及3D扫描[136]中提取图案方面取得了显著进展。
缝制图案生成的早期研究依赖传统算法,如支持向量机(SVM)和随机森林(random forest)。Ch en等人[53]提出了可变形部件模型(DPM)检测器,通过判别性潜在SVM训练并结合随机森林分类器和模板匹配,专注于从穿着人体的3D网格重建缝制图案。
随着深度学习的逐渐兴起,也提出了数据驱动的方法。Wang等人[453]提出了一种结合DenseNet[18 7]和主成分分析(PCA)的流程,通过简单绘制指示所需的折叠图案,系统以交互速率估计相应的服装和体型参数。Goto等人[136]创新性地将基于二维图像的推断转换为三维几何上的服装图案类型估计。
近年来,生成式神经网络逐渐成为主流,代表性方法包括GAN和Transformer。Shen等人[391]使用统一的基于GAN的方法,适应各种服装拓扑和缝制图案,开发了服装模型的图像表示和规范化布料数据表示的可靠映射算法。Sewformer[282]采用两级Transformer网络,提高了缝制图案预测性能,并展示了在野外照片中的有效性。最近,SewingGPT[162]将缝制裁片量化为标记序列,并采用基于GPT的架构自回归生成标记,使用户能够在文本提示指导下生成高度多样化和高质量的缝制图案。
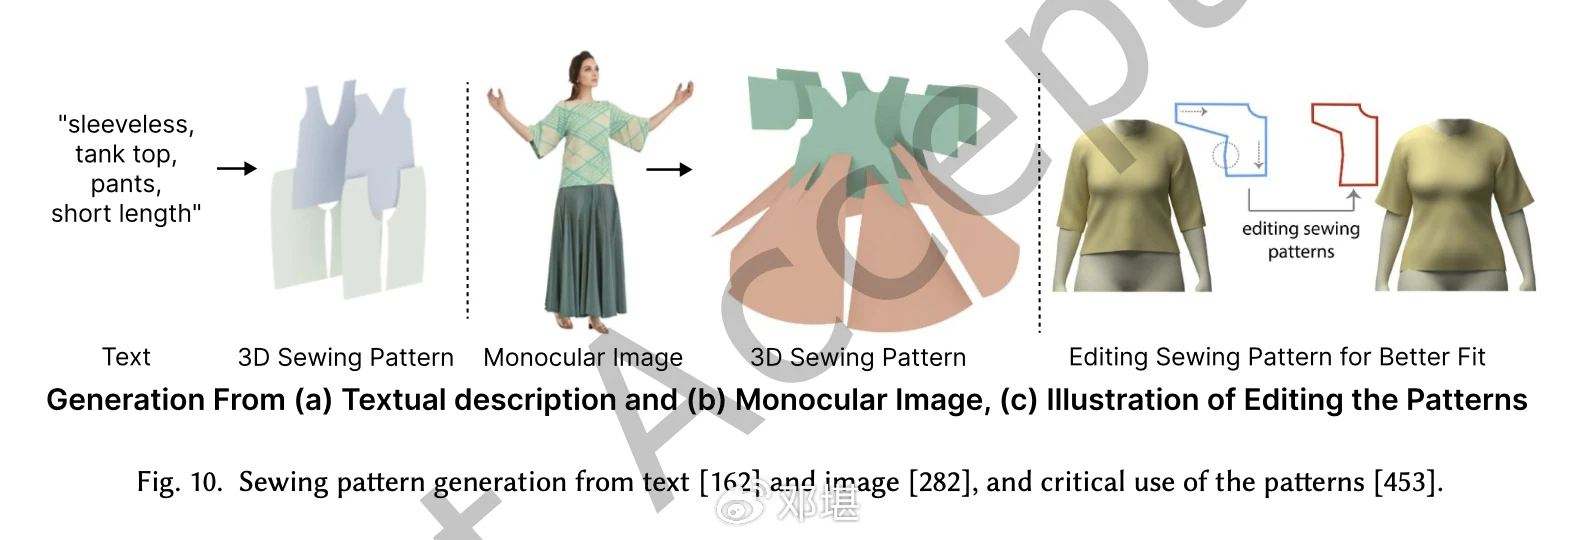
图10
4.3.2 基准数据集
缝制裁片生成的开源基准在表13中概述,如Wang等人[453]是首批包含缝制图案的数据集之一,而K orosteleva等人[235]是目前最受欢迎的数据集。然而,这些数据集未考虑实际服装中复杂的纹理和材料,仅描绘了静态T姿势人体模型上的服装,缺乏真实的人体纹理。这导致与现实世界图像存在显著的领域差距,可能限制模型的泛化能力。为此,SewFactory[282]扩展了缝制图案的种类,并在多样化人体形状和姿势上模拟服装,结合真实的服装纹理和材料属性,以更好地模拟日常人类照片。由于该领域缺乏高质量的公开数据,GarmentCodeData[234]提供了迄今为止最大的3D合成数据集,用于测量带有缝制图案的服装以满足这一需求。
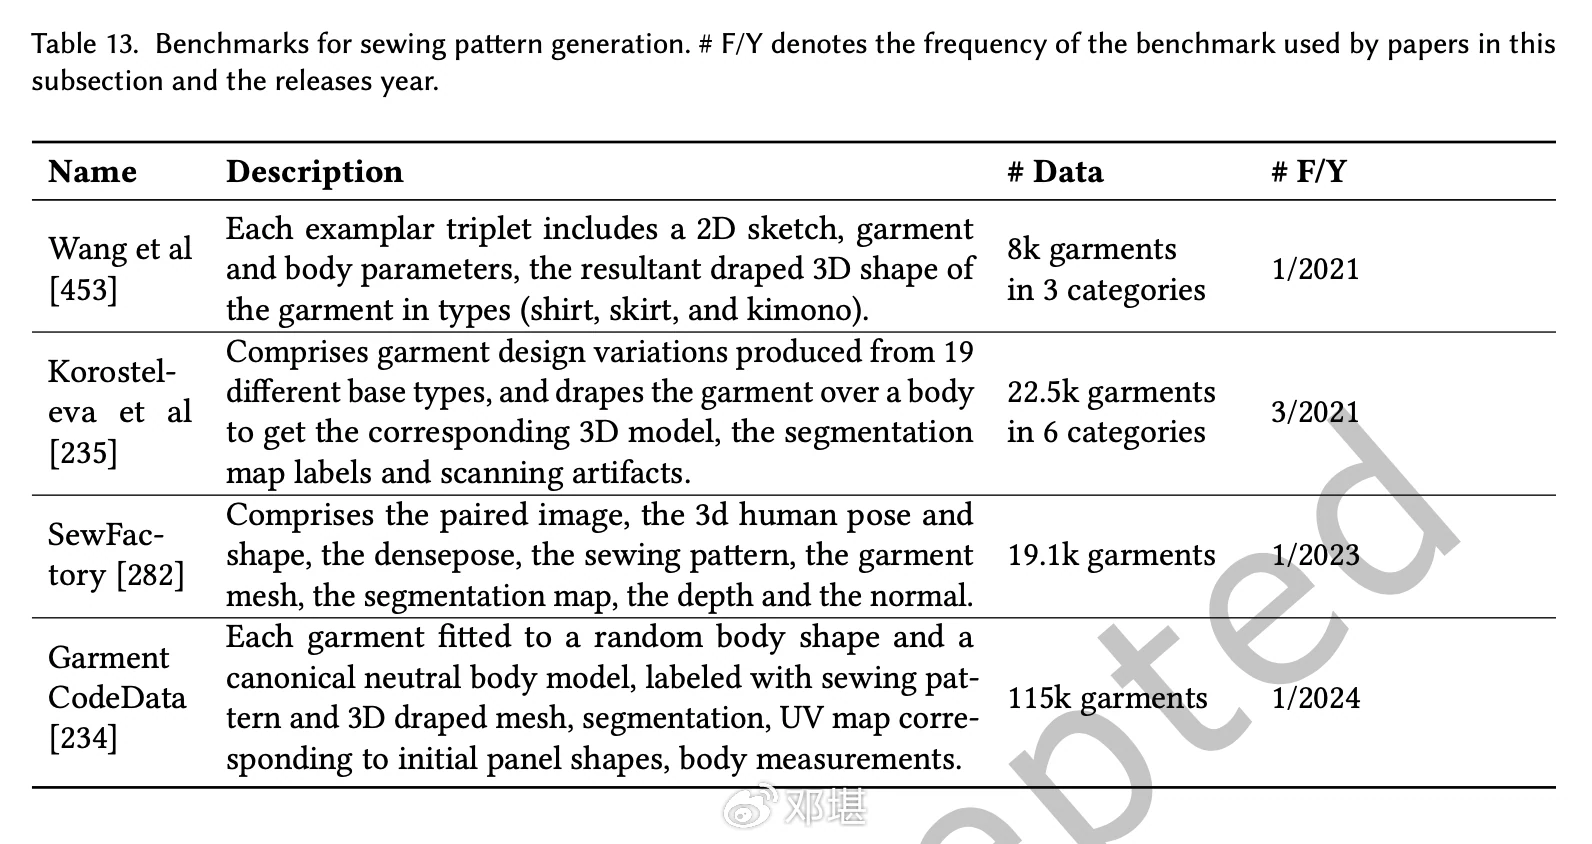
表13
4.4 基于3D的虚拟试穿
4.4.1 方法
3D虚拟试穿旨在从图像[185, 253, 556]或3D模型[352, 380, 383, 441]生成和谐的3D人体穿着服装,如图11所示。第一类输出将服装和人体视为一个整体的3D模型,而第二类则专注于保留合理的交互,如身体-服装[352, 383, 441]和服装之间的碰撞[380]。
从2D输入生成3D试穿结果,单目到3D虚拟试穿网络(M3D-VTON)[556]是首次尝试。M3D-VTON引入了一种自适应预对齐策略,以促进服装与参考人物图像的精确几何匹配,并利用可用的阴影信息与深度梯度约束引导网络捕捉几何变化。然而,固有的挑战如不自然的服装形成和不准确的3D建模仍然存在,导致纹理失真。为解决这些问题,后续方法引入了协作Transformer匹配块[185]或语义图预测网络[253]以获得更好的结果。
对于基于3D输入的方法,服装与身体之间的交互或碰撞是一个研究重点。Vidaurre等人[441]采用全卷积图神经网络管理具有任意网格拓扑的各种服装,并通过一种新颖的自监督策略微调回归器,惩罚身体-服装碰撞。Santesteban等人[383]生成避免与身体碰撞的3D服装配置,利用规范空间进行服装和自监督碰撞项确保无碰撞适配。为解决模拟分层神经场之间交互的挑战,提出了解耦分层神经场(ULNeFs)[380]来表示无碰撞的服装表面。ULNeFs通过变形代码参数化分层神经场以表示多个可变形表面,并引入了一种神经解缠投影算子,直接在分层神经场而非表面表示上工作。
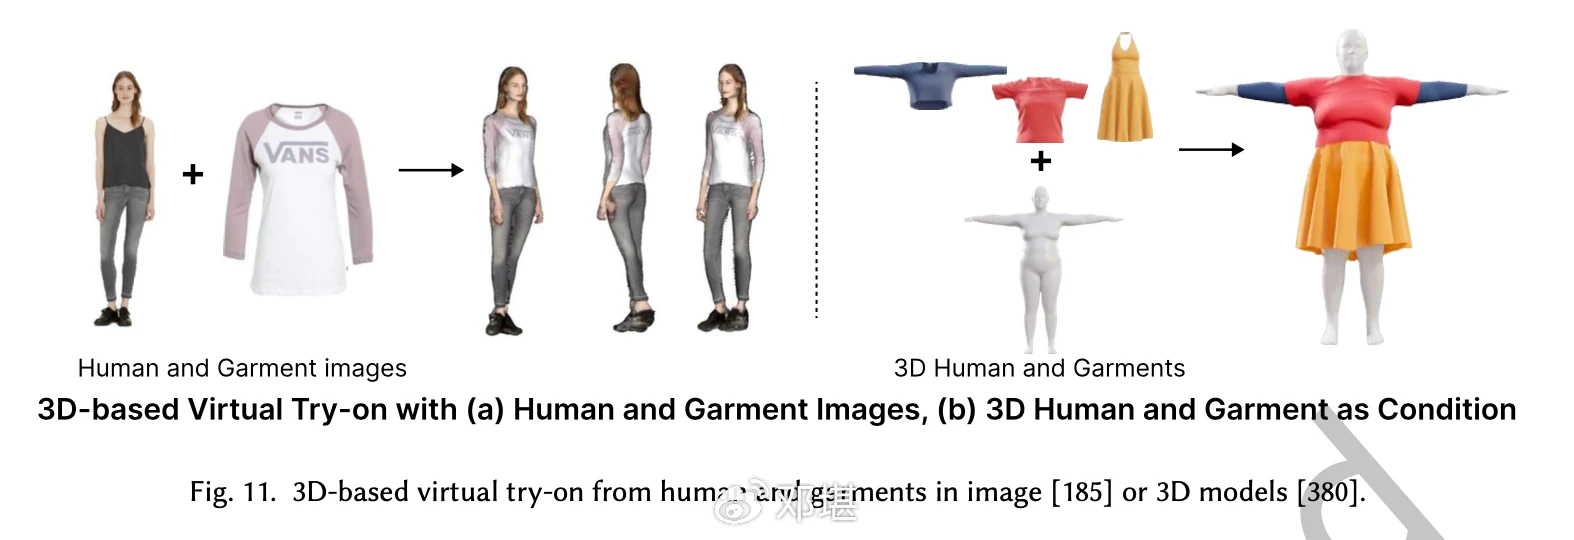
图11
4.4.2 基准数据集
从人体和服装图像生成整体3D试穿效果,MPV-3D(Wang等人2019)是唯一公开可用的数据集,包含6,566张服装-人物图像对(C,I),大小为512×320,其中每张人物图像关联深度图Df和Db。对于3D人体和服装的3D试穿,一些工作(Wang等人2019;Wang等人2020a)使用来自AMASS(Wa ng等人2019b)的不同形状的身体网格与来自TailorNet(Wang等人2020a)的服装来评估身体与服装之间的碰撞次数。
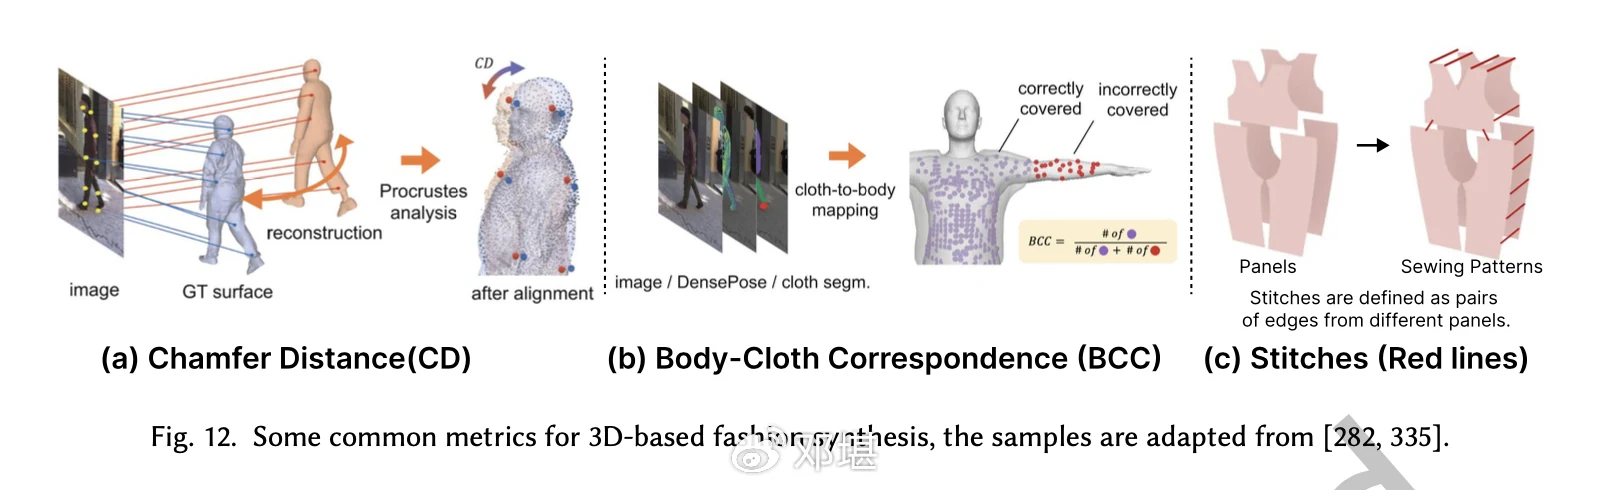
图12
4.5 评估指标
3D模型(如着装人体、服装和缝制裁片)生成的常见指标包括倒角距离(CD)(如图12(a))、点到表面距离(P2S)和法线差(Miller等人2008;Li等人2017;Zhang等人2015;Chen等人2017)。此外,优化时间评估生成效率,而PSNR、均方误差(MSE)和LPIPS评估3D模型的2D纹理质量。
对于3D服装生成,一些特定指标如身体-服装对应(BCC)(Wang等人2020a)测量在T姿势裸体上服装类型预测的准确性,仅关注3D服装预测,如图12(b)所示。法线重投影误差(NRE)(Wang等人2020a)评估重建表面与真实表面法线图之间的L2误差。地球移动距离(EMD)(Wang等人2 020a)和平均欧几里得距离(MED)(Wang等人2020a)也在应用Procrustes变换后计算输出与真实值之间的定量测量,后者旨在评估重建形状对真实值的保真度。
在生成缝制裁片的背景下,缝制服装的物理合理性通过监测发生互穿的网格面积百分比(也称为交叉)[81]来评估。这对于确保服装可以在不重叠或交叉的情况下构造至关重要。为了评估缝制服装的准确性,Wang等人[453]考虑了平均L2误差,包括服装的PCA基础和顶点位置,以及由SMPL参数和顶点位置定义的体型以及服装参数。这提供了缝制服装与预期设计匹配程度的见解。
此外,还计算了特定于面板和缝线的指标。缝线由来自不同面板的边缘对标识,如图12(c)所示。服装结构和关系细节的保真度通过几个指标评估:
(1)面板L2,通过预测和真实面板边缘参数之间的L2距离测量形状预测质量。
(2)旋转L2和平移L2用于旋转和平移误差。
(3)#Panel用于预测面板数量的准确性,
(4)#Edges用于每个面板内边缘计数的准确性。
(5)缝线的精确率、召回率和F1分数用于评估缝线检测的准确性,反映服装的关系细节。
由于缝合的两条边通常具有相似的特征(如方向和空间位置),Liu等人[282]基于边特征之间的相似性预测两条边是否形成缝线。
基于3D的试穿采用常见指标,如运行时性能(执行时间)和深度估计指标,包括绝对相对误差(Ab s.)、平方相对误差(Sq.)和均方根误差(RMSE)[556]。此外,测量预测网格与真实网格之间的Hausdorff距离[441],以及在[383]中测量的平均碰撞次数。
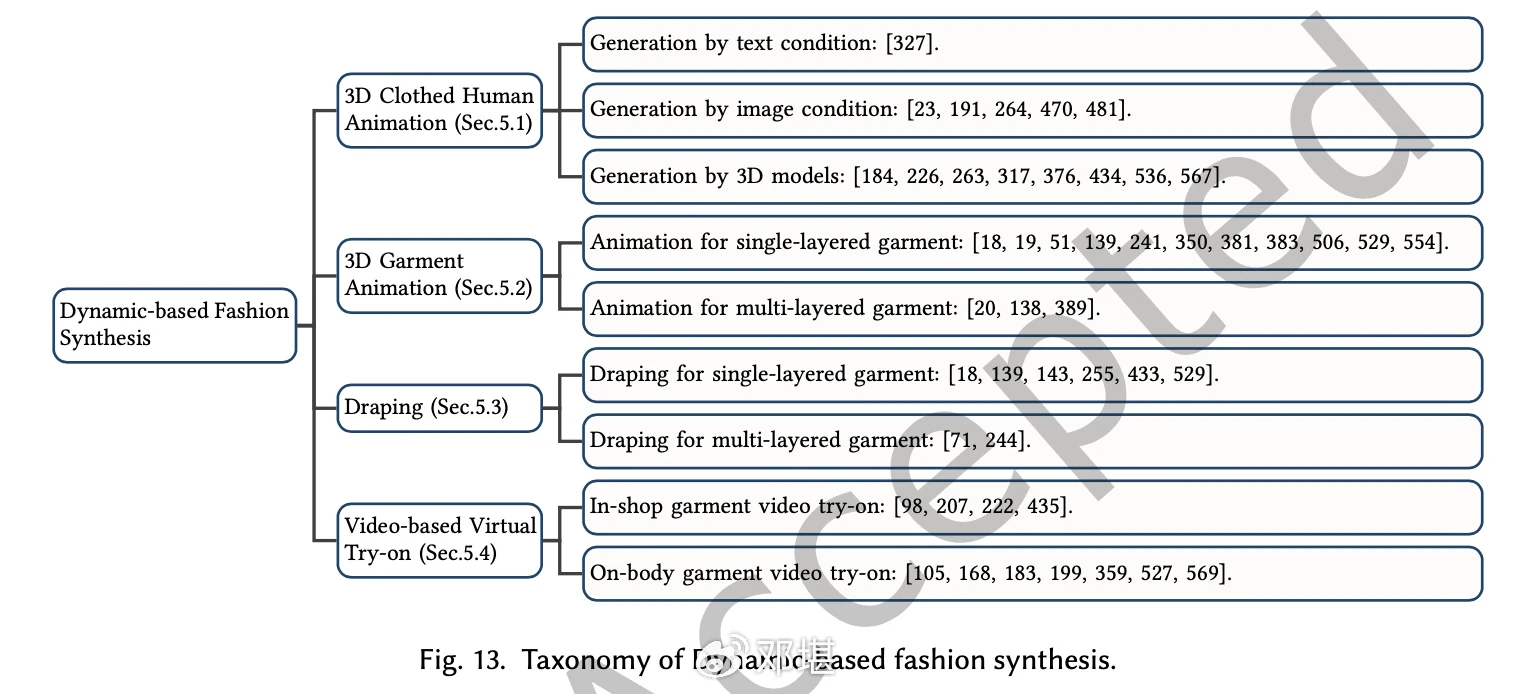
图13
5. 基于动态的时尚合成
3D着装人体动画(第5.1节)方法,尝试从不同输入生成可动画的着装虚拟形象;3D服装动画(第5.2节)是一项更精细的任务,专注于服装作为相对独立的资源,紧密跟随身体运动[51, 350, 554]和其他外力(如风[389]);立体剪裁Draping(第5.3节)专注于实现虚拟身体上逼真的服装模拟,这一任务涉及详细的调整和优化,以确保服装适配并以视觉上令人愉悦的方式垂坠。基于视频的虚拟试穿(第5.4节)旨在让参考视频中的人体模型穿着目标服装。此外,每项任务根据不同的输入进一步细分,如图13所示。除此之外,不同动态时尚合成任务的评估指标在第5.5节中总结。
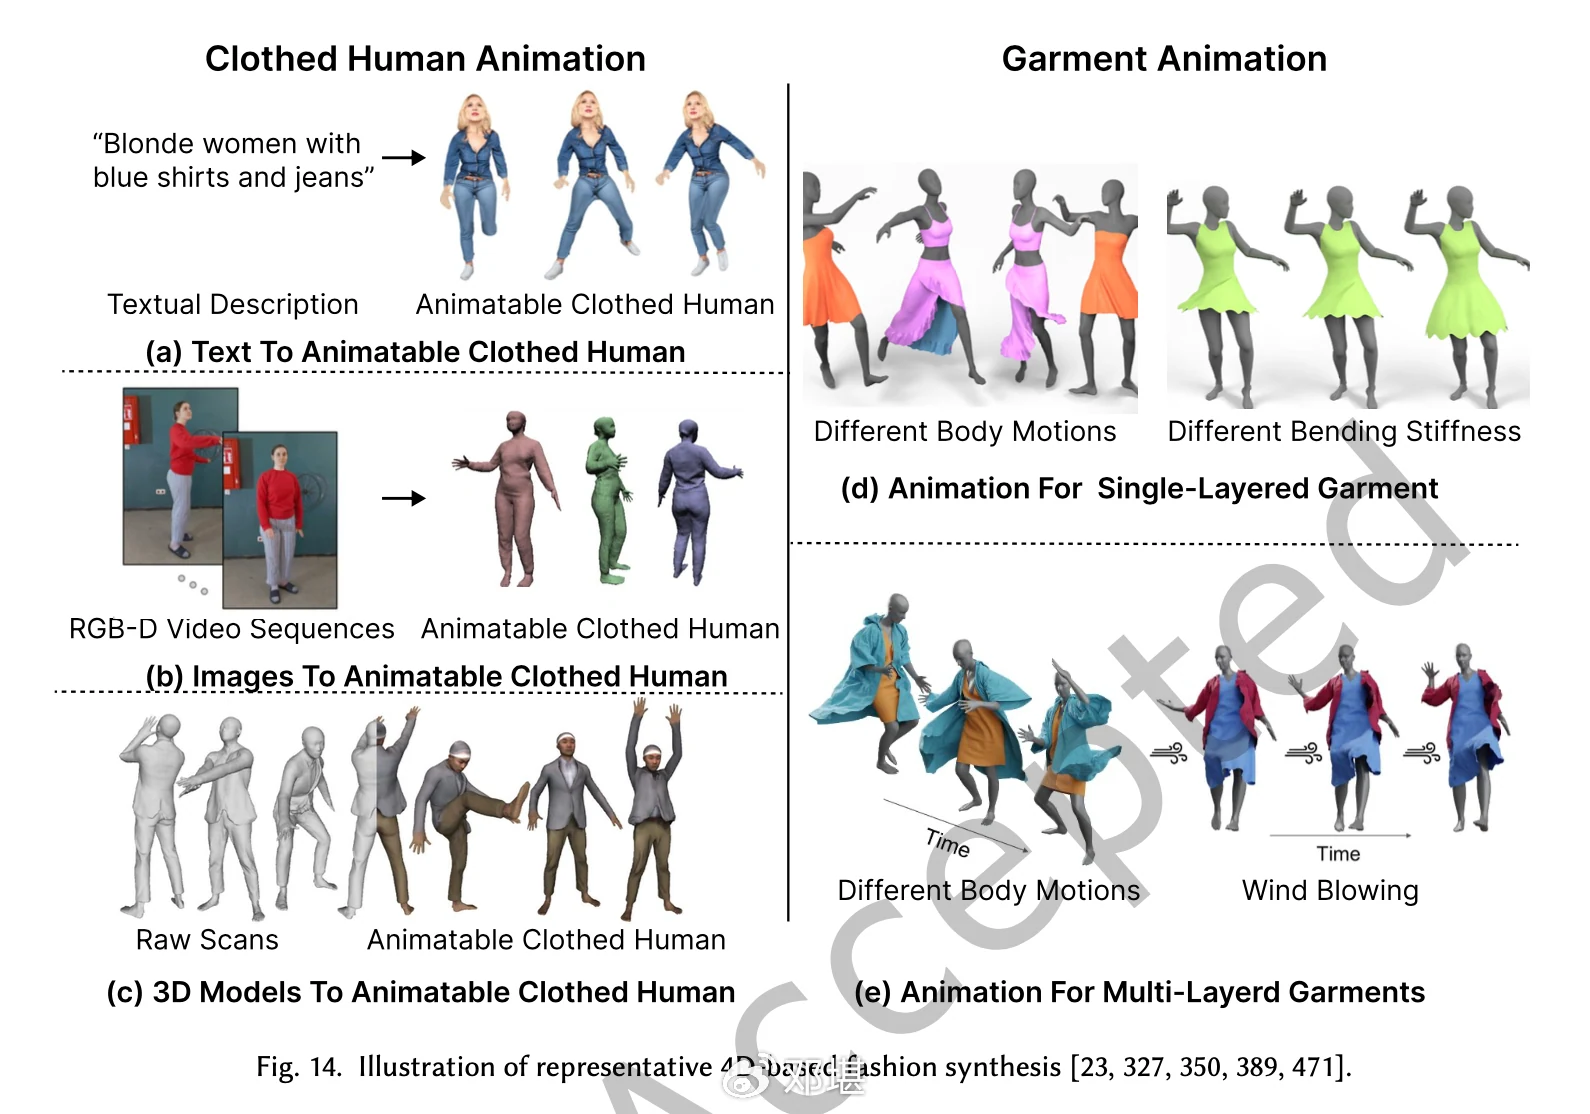
图14
5.1 3D着装人体动画
5.1.1 方法
着装人体动画方法尝试从不同输入生成可动画的着装虚拟形象,如文本[327]、图像[23, 191, 264, 36 3, 451, 481]和3D模型(静态扫描[317, 376, 434, 536]或点云[184, 226]),如图14(a)-(c)所示。
对于3D模型输入,SCANimate[376]开创了一个端到端框架,将原始3D着装人体扫描转换为可动画的虚拟形象。SCANimate可以直接从原始扫描中以弱监督方式学习姿势感知的参数化着装人体模型。生成的结果可以通过SMPL姿势参数动画化,产生逼真的姿势依赖变形和纹理。
POP[317]和CloSET[536]专注于从静态扫描生成可动画的虚拟形象,通过学习姿势依赖的服装变形并将其应用于各种身体姿势。Neural-GIF[434]通过一系列扫描推进这一技术,采用变形场建模非刚性效果,动画化新姿势中的着装虚拟形象。LaplacianFusion[226]通过从点云序列重建可动画模型进一步推进,展示了处理动态运动和通过调整人体姿势动画化模型的能力。
由于3D扫描比图像更难获取,许多工作将重点转向使用图像作为输入。可动画的着装人体重建(AR CH)[191]是一种学习到的姿势感知模型,从单一无约束RGB图像生成详细的3D全身人体虚拟形象。在利用单目深度图像方面,MetaAvatar[451]引入了一种元学习方法,快速生成可控的神经有符号距离场(SDFs),代表了简化虚拟形象创建流程的飞跃。给定一组图像,ICON[481]从每张图像估计详细的3D表面(法线),然后将这些组合成一个可动画的虚拟形象。
除此之外,遵循文本到3D方法[274, 358]具有更好的生成多样性,En3D[327]引入了一种零样本3D生成方案,能够为动画和编辑创建视觉上逼真的虚拟形象,并且它是在2D合成数据上训练的,不直接依赖任何现有的3D或2D资源。
5.1.2 基准数据集
一些着装人体动画工作[23, 191, 226]也将RenderPeople、BUFF[533]和CAPE[316]作为静态基准。而对于动态基准,Ma等人[317]使用物理模拟将服装覆盖在来自AGORA数据集[353]的3D身体上,这些身体用于动画化许多姿势。Xiang等人[470]选择使用来自AMASS[321]的运动数据,AvatarReX[56 7]选择DeepCap[151]进行比较。表14详细列出了其他着装人体动画的基准。
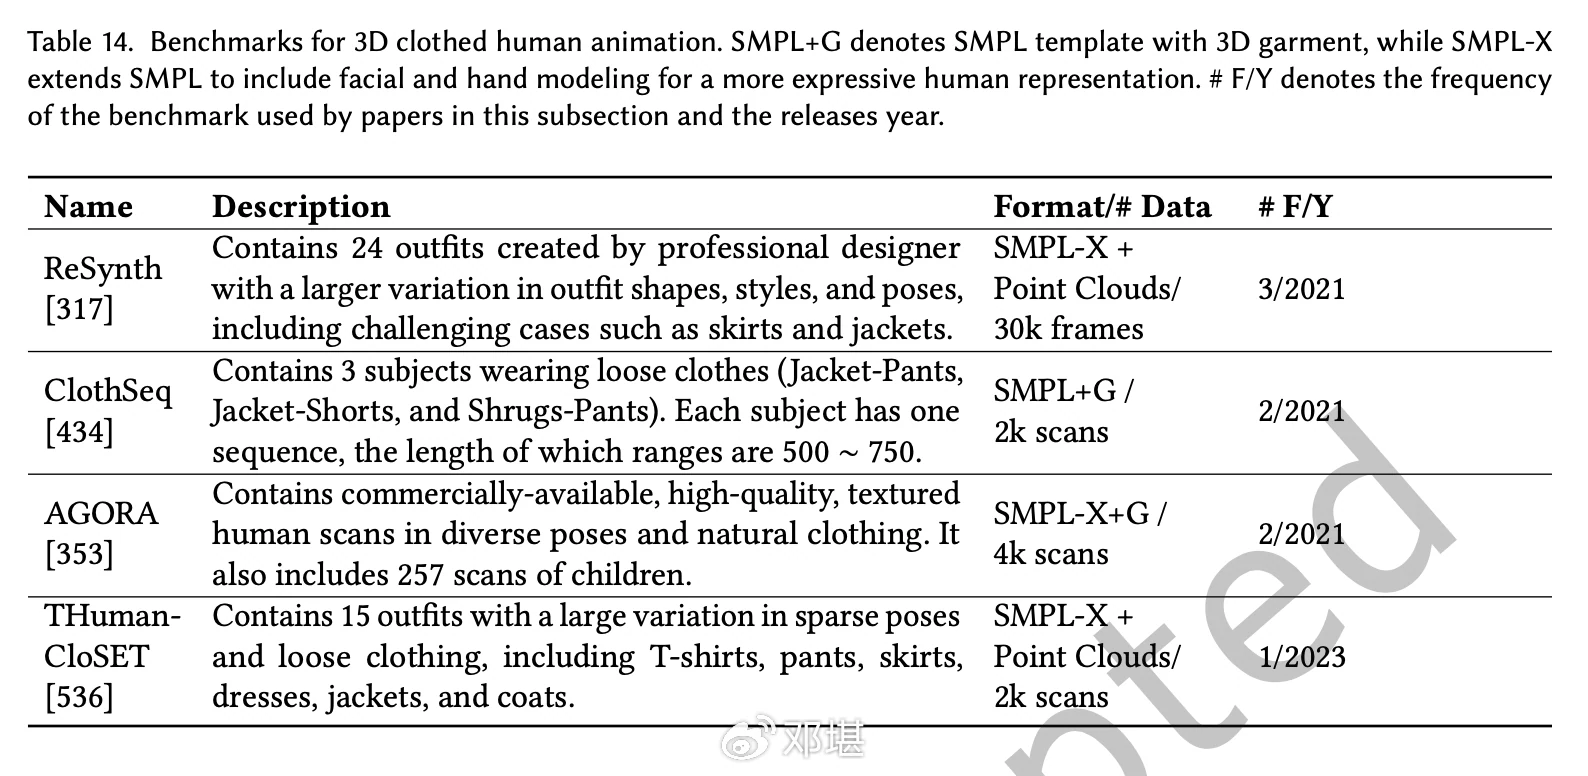
表14
ReSynth[317]旨在提供具有姿势依赖服装变形的动画。ClothSeq[434]引入了一些具有更复杂几何和拓扑的宽松服装。由于现有的姿势依赖服装数据集[21, 317]要么是相对紧身的服装,要么是通过物理模拟合成的服装,THuman-CloSET[536]引入了更多真实世界的服装(宽松服装)和具有挑战性的姿势。地理优化回归分析中的虚拟形象(AGORA)[353]包括高分辨率(4K)图像,带有不同姿势、年龄和复杂服装的人在复杂自然场景和自然光照下的真实3D身体和形状。
5.2 3D服装动画
5.2.1 方法
服装动画代表了一项精细复杂的任务,将服装视为相对于身体的独立资源,动态变化紧密跟随身体运动[51, 350, 554]和外部环境(如风[389])。此外,根据服装的复杂程度,动画可分为单层[18, 19,51, 139, 241, 350, 381, 383, 506, 529, 554]和多层服装[20, 138, 389],如图14(d)-(e)所示。
早期工作[241, 506]将统计模型与基于学习的模型结合,重建服装以进行布料动画。虽然基于学习的模型高效,但其性能依赖于高质量物理模拟(PBS)结果或扫描数据的大量数据集,这些数据获取成本高昂[381]。为减轻这种依赖性,PBNS[19]提出了一种自监督方法,对模型施加物理约束。
此外,DeePSD[20]能够动画化任何拓扑的服装,通过将服装映射为标准3D动画格式确保与图形引擎的兼容性。为从多视角视频生成高保真布料动画,Xiang等人[471]提出了一种方法,利用两层网格表示分别注册每个3D扫描与身体和服装模板,从而实现上身的明确表示。
专注于身体运动序列,VirtualBones[350]利用预测的骨骼变换促进服装形状插值,无需直接对齐服装动态与身体顶点。相比之下,AnchorDEF[554]采用一组自适应锚点分解服装变形,通过网格表面上的锚点引导刚性和非线性变换,从身体运动序列预测3D动画。针对多层服装模拟的局限性,Laye rsNet[389]在微物理系统中引入了逐粒子模型,并提出了一种新颖的注意力机制,利用物理系统的旋转不变性和可加性更好地建模外力。表16列出了最新方法的定量比较。
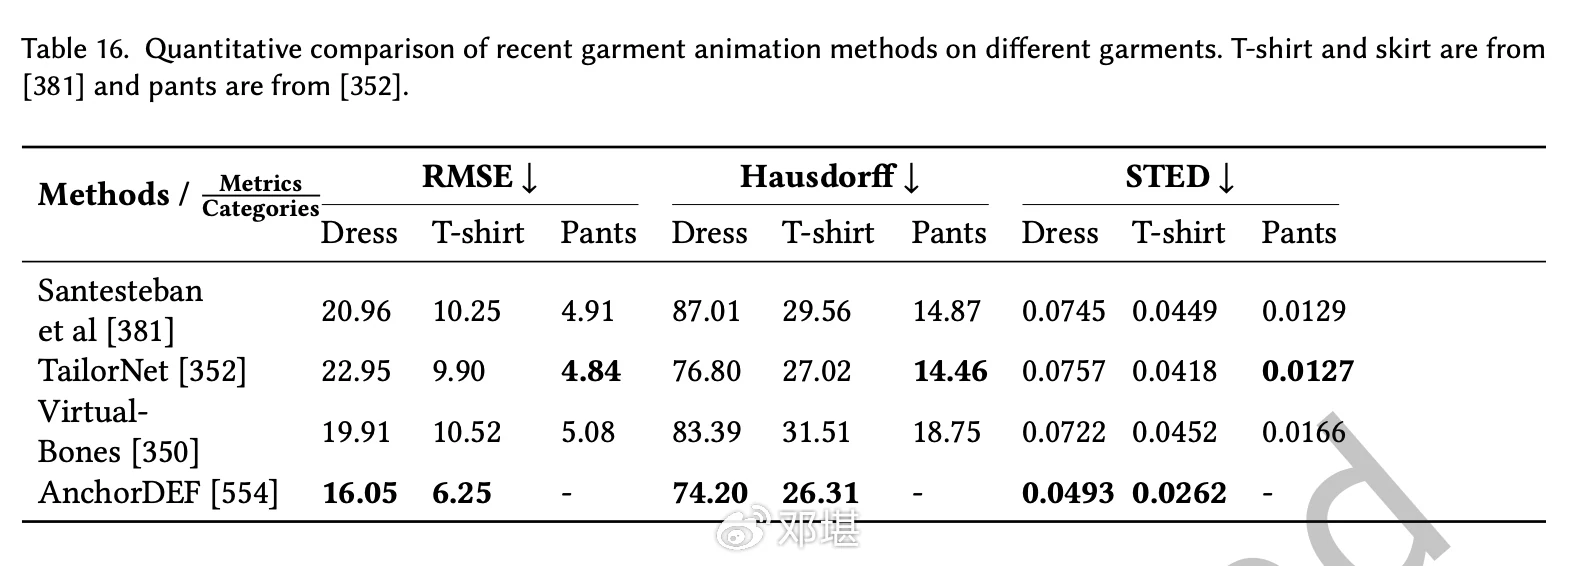
表16
5.2.2 基准数据集
许多工作[51, 241, 241]选择基于现有数据集(如[18, 235])构建私有数据集用于服装动画。此外,公开可用的服装动画基准收集在表15中。VTO[381]使用修改版的ARCSim[341]和从CMU运动捕捉数据库[67]转换到SMPL格式的序列生成。每个模拟序列存储为.pkl文件,包含SMPL的姿势和形状、唯一模拟服装的面和顶点。VirtualBones[350]和D-LAYERS[389]不仅提供更多不同的服装,还涉及显著影响服装模拟结果的更多模拟参数,如弯曲刚度、质量密度、时间尺度和随机采样的风。
CLOTH3D++[320]从Cloth3D[18]发展而来,是规模最先进的。然而,基于服装模板创建的服装仅是基础图案,与现实生活中的服装存在巨大差距。CLOTH4D[588]在数据集中引入了丰富且逼真的4D合成序列。此外,为提供标注注释并提供时间相关的扫描,4D-Dress[454]收集了各种人类受试者和服装,提供人类服装的语义标签、服装网格和SMPL-X适配。
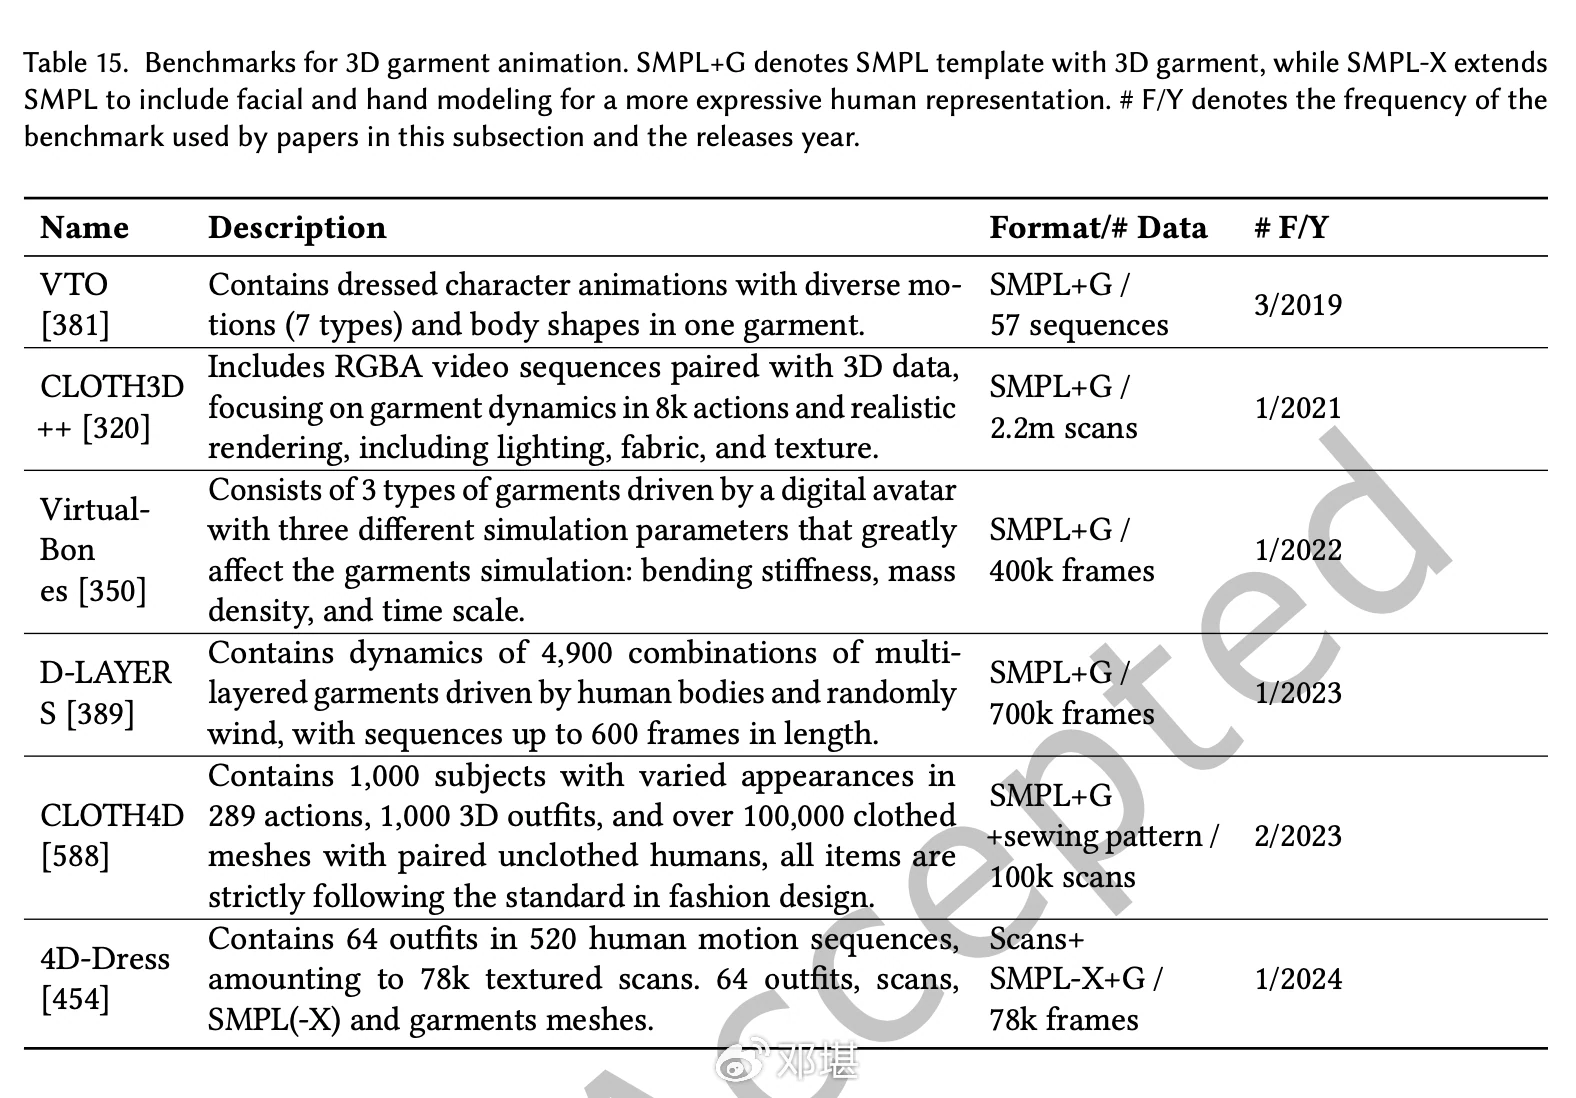
表15
5.3 立体剪裁
5.3.1 方法
立体剪裁的探索专注于在虚拟身体上实现逼真且合适的服装模拟,这些身体具有不同形状(尺寸)和姿势。这一任务涉及详细的调整和优化,以确保服装适配并以视觉上令人愉悦的方式垂坠,如图1 5(c)所示。它也可以分类为单层服装[18, 139, 143, 255, 433, 529]和多层服装[71, 244]的立体剪裁,如图15(a)和(b)所示。
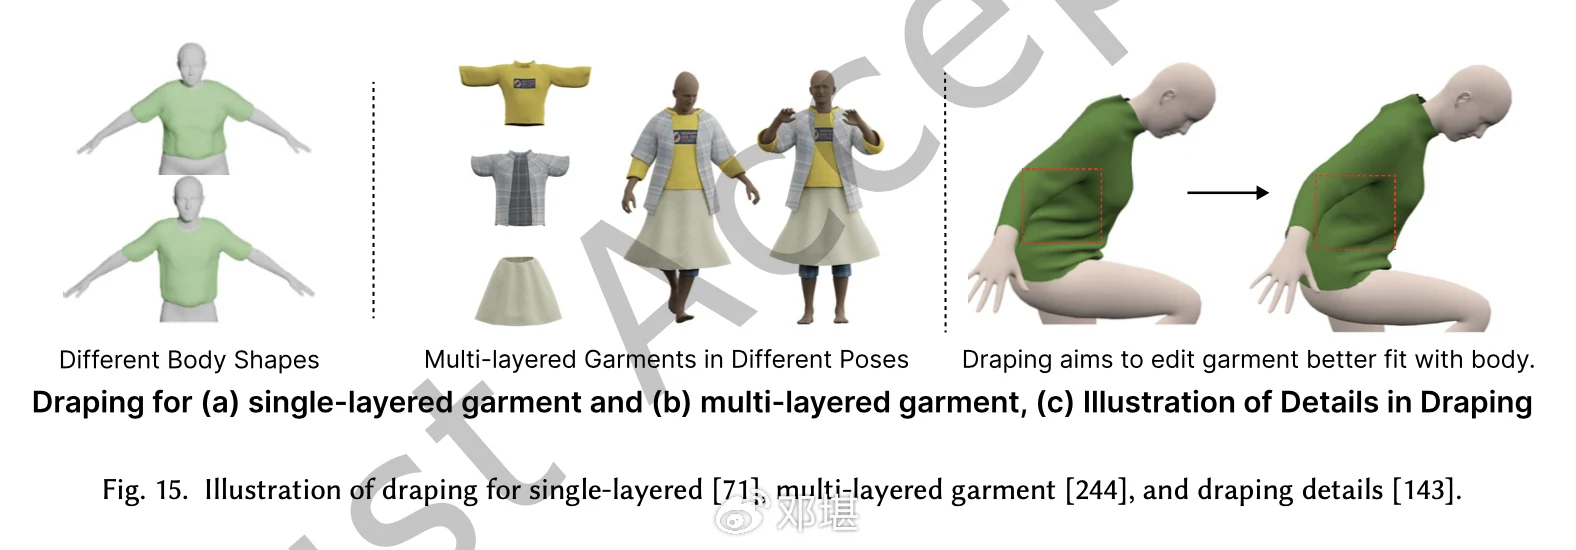
图15
对于单层服装的立体剪裁,基于点的方法[529]允许通过独立估计每个点的变形来变形具有任何拓扑和几何复杂度的服装。基于网格的方法提供了另一条途径,Sizer(Sizer等人2019)提出了一种模型,根据体型和服装尺寸参数估计和可视化着装效果。与完全监督的学习方法(Krizhevsky等人201 5;Krizhevsky等人2016)不同,DrapeNet(DrapeNet等人2017)是一种自监督学习方法。它展示了无符号距离场(UDFs)(Yang等人2018)在服装表示中的应用,并突出了其在从部分数据重建3 D服装方面的有效性。相比之下,HOOD(Hinton等人2014)采用了一种无监督方法,利用图神经网络预测服装动态,同时适应服装属性的各种变化。
对于多层服装的立体剪裁,SMPLicit(Miller等人2017)提供了一个统一框架,通过潜在空间表示不同的服装拓扑,满足广泛的服装需求。ClothCombo(ClothCombo等人2020)为每件服装创建特征嵌入,使用拓扑无关的网络。然后,基于GNN的立体剪裁网络将所有服装变形以适应目标体型和姿势,不考虑服装间的交互。
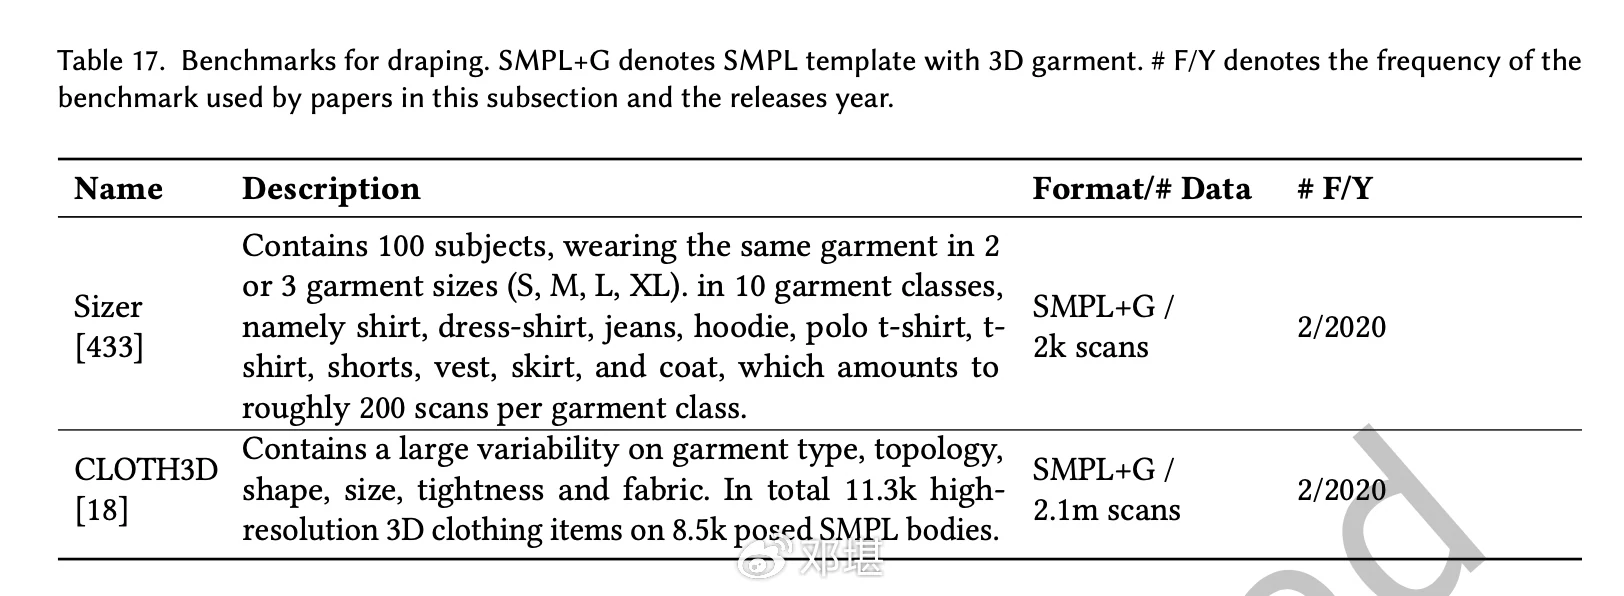
表17
5.3.2 基准数据集
立体剪裁的基准详见表17。CLOTH3D(Garments等人2019)中的服装为每个序列自动生成,随机化形状、紧密度、拓扑和面料,并调整为目标人体形状。这一过程为每个序列生成独特的服装。它包含超过7000个不重叠的序列,每个序列300帧,每秒30帧,总计210万个样本。此外,Sizer(Siz er等人2019)提供了具有服装尺寸变化的虚拟人物,并包含CLOTH3D(Garments等人2019)中未提供的真实布料变形。
5.4 基于视频的虚拟试穿
5.4.1 方法
与基于图像的虚拟试穿类似,基于视频的试穿也可以分为店内[98, 207, 222]和穿在身上[105, 168, 1 83, 199, 359, 527, 569]的方法,如图16所示。然而,当基于图像的方法直接应用于视频场景时,常导致连续帧之间缺乏流畅性[207, 569]。这一挑战促使开发了来自不同算法的视频特定技术,包括G AN[98, 359, 569]、扩散[168, 183, 222]、Transformer[207]和基于光流的方法[38, 105],旨在增强基于视频的虚拟试穿的流畅性和连贯性。
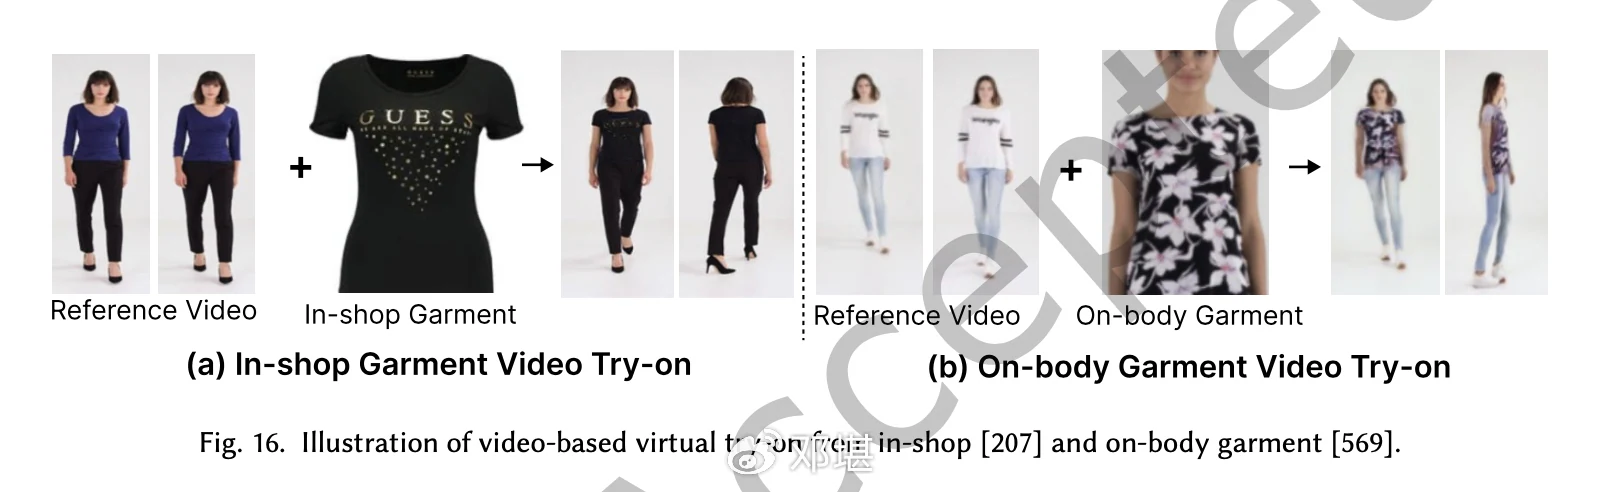
图16
传统方法通常使用多个网络预测关键中间值,包括光流、背景掩码和遮挡掩码,这些对于准确将目标服装变形到视频帧中的个体至关重要[98, 105, 207, 435, 569]。然而,这些预测的不准确性可能导致视觉伪影和错位。
为缓解这些问题,MV-TON[569]引入了一种试穿模块,采用姿势对齐和区域像素位移进行服装变形,以及一个记忆细化模块。ClothFormer[207]通过估计遮挡掩码解决光流不准确的问题,并利用帧间信息细化光流预测。尽管这些方法在行走运动场景中显示出显著前景,但在处理具有复杂人体运动的视频时面临挑战,这些视频在不受控环境中很常见。这是由于获取标记视频数据的高成本和显式变形技术在捕捉动态运动细微差别方面的固有局限性。
为克服这些挑战,WildVidFit[168]采用基于图像的控制扩散模型进行简化的一阶段方法,增强了预训练模型保持时间连贯性的能力,从而在基于图像的框架内实现更有效的视频试穿。
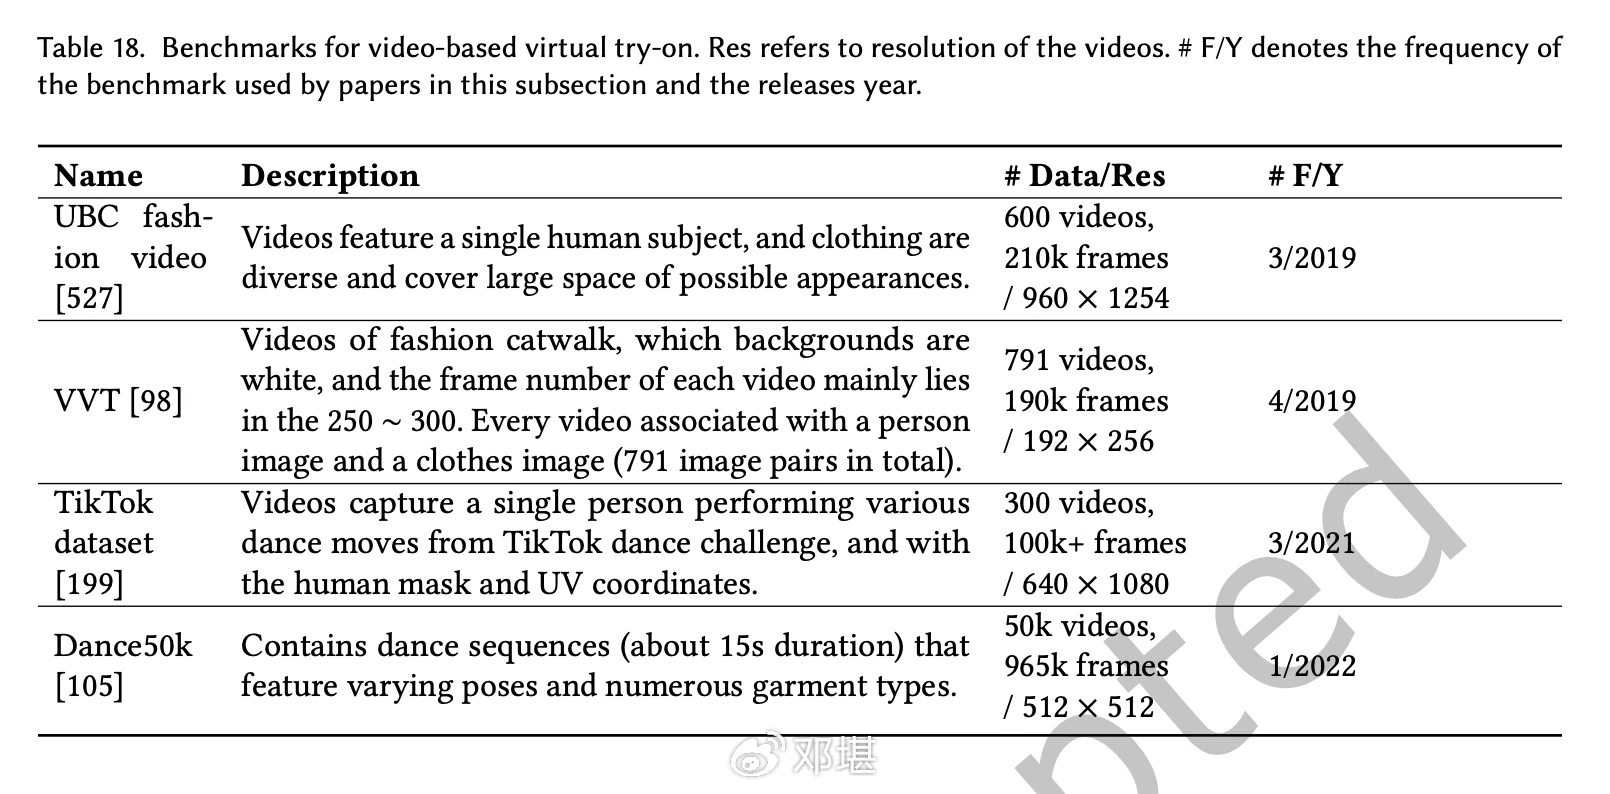
表18
5.4.2 基准数据集
基于视频的虚拟试穿也使用基于图像方法建立的基准,如DeepFashion[298]。此外,视频特定基准详见表18。UBC时尚视频[527]以单一人类受试者为特色,具有高分辨率和静态相机。最值得注意的是,这些视频提供了多样化的服装和纹理,涵盖了可能外观的广泛范围。UBC时尚视频[527]和VVT[98]都提供了店内服装图像,这对于虚拟试穿应用至关重要。相比之下,TikTok数据集[199]和Dance 50k[105]不提供店内服装图像。然而,它们提供了更复杂的动作和背景,更接近真实场景。由于它们的动态性和背景多样性,这些数据集对测试基于视频的穿在身上虚拟试穿方法的鲁棒性非常有价值。
5.5 评估指标
在本节中,我们讨论了不同动态时尚合成任务中使用的评估指标。对于3D着装人体动画,使用诸如交并比(IoU)、点到表面(P2S)距离和法线一致性等指标评估空间准确性和方向对齐。跟踪准确性使用平均(EPE)[23]评估,该指标测量跟踪的VICON标记与重建网格上对应点之间的3D L1距离。为了更彻底的定量分析,计算了扫描到网格距离(Ds2m)和表面法线一致性(Dn)[376],使用结果网格上的最近邻顶点确定平均L2范数。身份(ID)指标[34]评估多视角面部身份的一致性,而F分数[363](召回率和精确率的调和平均值)评估整体准确性。此外,对于感知研究,SCANimate[3 76]评估形状和变形的合理性分数。
在服装动画领域,指标包括均方误差(MSE)、均方根误差(RMSE)、结构相似性指数(SSIM)、顶点到顶点(V2V)距离、运行时性能和Hausdorff距离[350]。碰撞率,特别是服装层之间的L-碰撞和服装与人体之间的H-碰撞[389],提供了对虚拟环境交互的见解。布料质量的评估涉及诸如平均边缘伸长/压缩和相邻顶点法线之间的弯曲角度等指标[19, 20]。时空边缘差异(STED)[437]捕捉动态变化。
对于立体剪裁任务,使用一组常见于2D生成和3D重建任务的指标。这些指标包括计算时间、学习感知图像块相似性(LPIPS)、结构相似性指数(SSIM)、欧几里得距离(ED)、法线一致性(NC)和倒角距离(CD)。例如,ED是在考虑的网格对应顶点之间计算的。然而,仅ED并不能清楚地表明哪个结果更优,[20, 81, 255]的结果如图17(a)所示。因此,通过主观问卷补充人工评估以评估立体剪裁结果的质量至关重要。
基于视频的虚拟试穿任务利用了在基于图像的任务中常见的指标。此外,循环转移分数(CTS)[56 9]用于评估虚拟试穿方法的循环一致性水平。CTS的计算涉及在一个循环内的两步过程,利用Frech et初始距离(FID)评估每个循环的质量,如图17(b)所示。视频Frechet初始距离(VFID)[38, 9 8, 207]测量非配对设置中的视觉质量和时间一致性。此外,Frechet视频距离(FVD)[436]用于捕捉视频的时间连贯性,提供对虚拟试穿过程的全面评估。
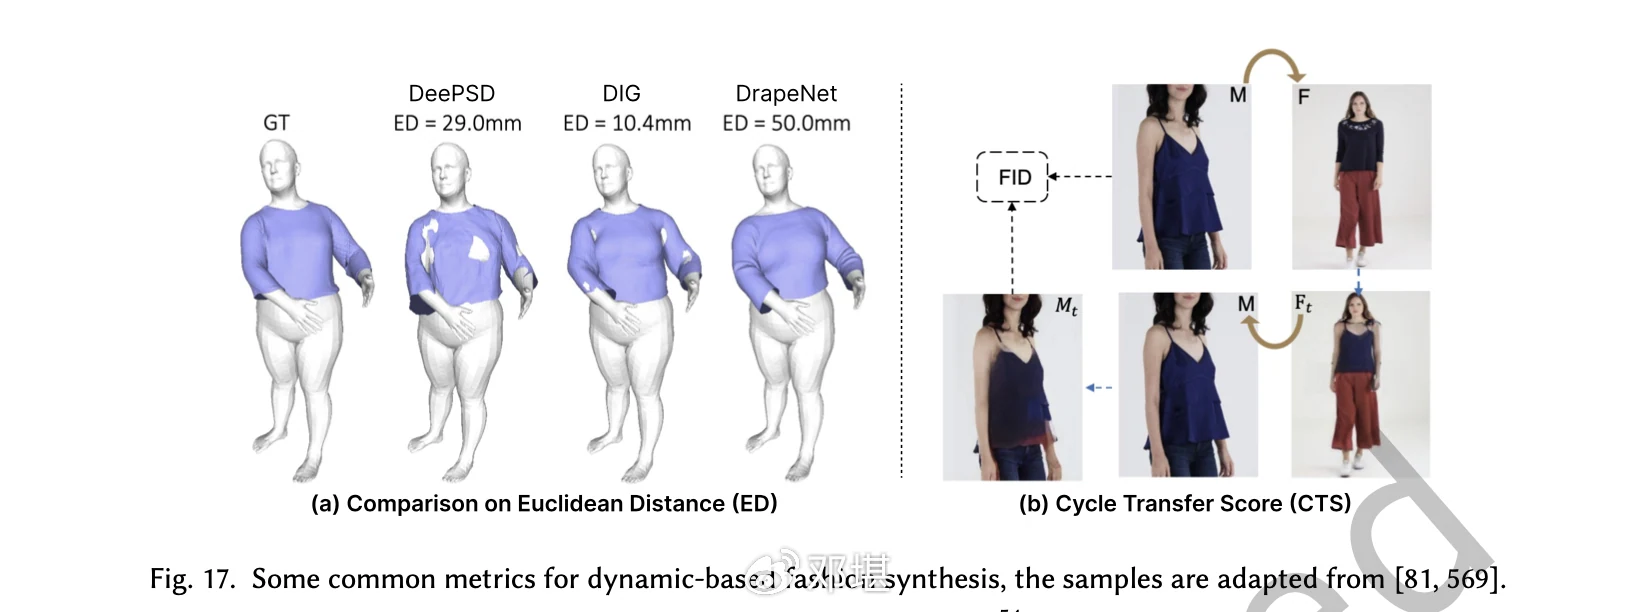
图17
6. 应用
为了弥合学术研究与行业实际应用之间的差距,除了我们对学术论文的回顾外,我们还扩展了关注该领域运营的公司和初创企业。基于多个主流GenAI应用排名,如57,58,59,60,61,我们使用“时尚”、“设计”、“服装”和“服饰”等关键词进行搜索,去重后获得了69个与时尚相关的GenAI应用。然后,基于本文中的四大类别(多模态时尚理解、基于图像、3D和动态的时尚合成),选择了前八个代表性案例。
6.1 多模态时尚理解
产品理解。Salesforce62推出了Marketing GPT和Commerce GPT,利用GenAI改变客户参与和购物体验。Marketing GPT支持在所有接触点进行个性化营销,而Commerce GPT提供定制化的购物旅程。这些创新旨在提高生产力,具有生成产品描述等功能,如图18(a)所示。
时尚代理。Zalando63正在其应用和网站上推出由ChatGPT驱动的时尚助手测试版,旨在使在线时尚发现和购物更加直观,如图18(b)所示。该助手将使用自然语言搜索Zalando的广泛产品范围,根据查询(如类型和特定位置的天气条件)提供个性化的服装推荐。
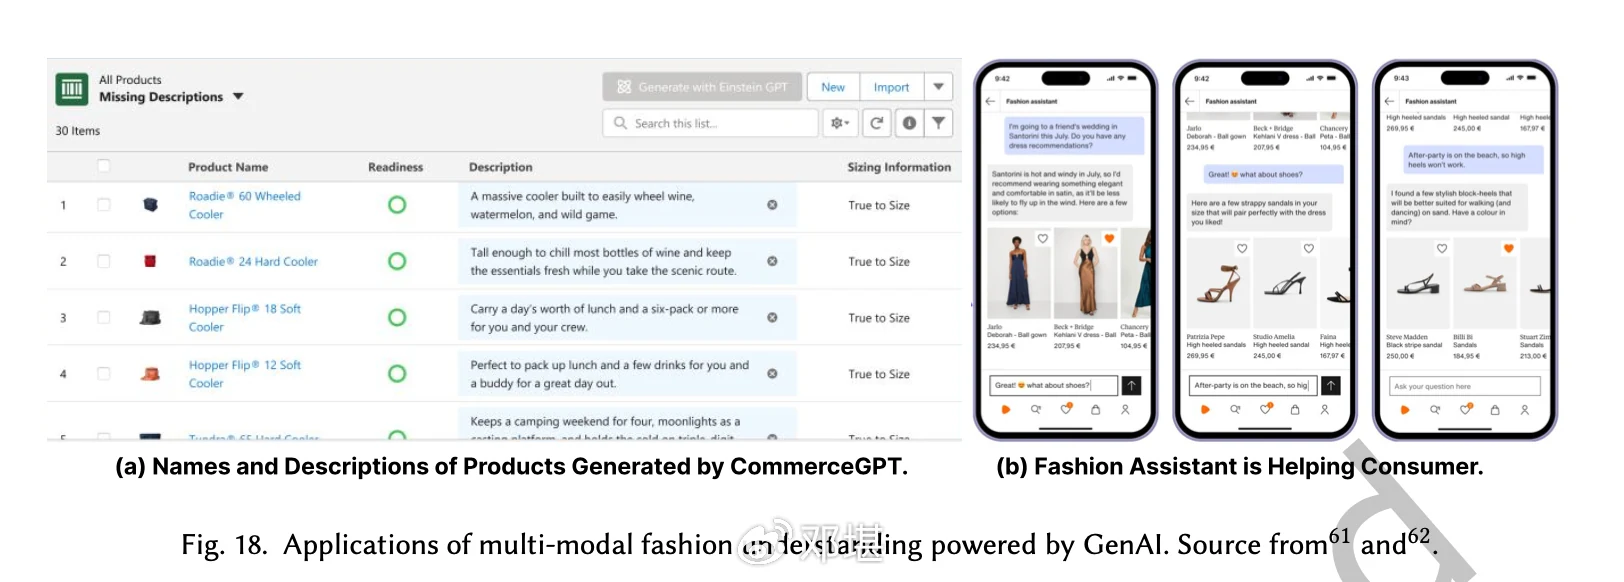
图18
6.2 2D时尚内容合成
服装设计。AiDA64是一种工具,使设计师能够在大约10秒内从情绪板、颜色选择和草图快速创建新的时尚系列。该平台通过提供速度、效率和灵活性显著增强了设计过程。如图19(a)所示,该系列是AiDA与设计师的合作成果,不仅简化了设计过程,还激发了创意团队的灵感。
图案设计。PatternedAI65能够创建独特且无缝的图案,如图19(b)所示。它支持从文本描述生成图案,设计用于纺织品和家居装饰等多种应用,提供高分辨率和SVG格式。
虚拟模特。Lataland.ai66允许用户详细定制虚拟形象,包括发型、体型和肤色,如图19(c)所示。该平台支持在这些模型上展示3D设计,增强了设计验证过程。
虚拟肖像。Portrait Studio Pro67提供AI生成的专业头像,允许客户通过上传自拍和选择所需风格接收多达240个头像,无需实体拍摄,如图19(d)所示。
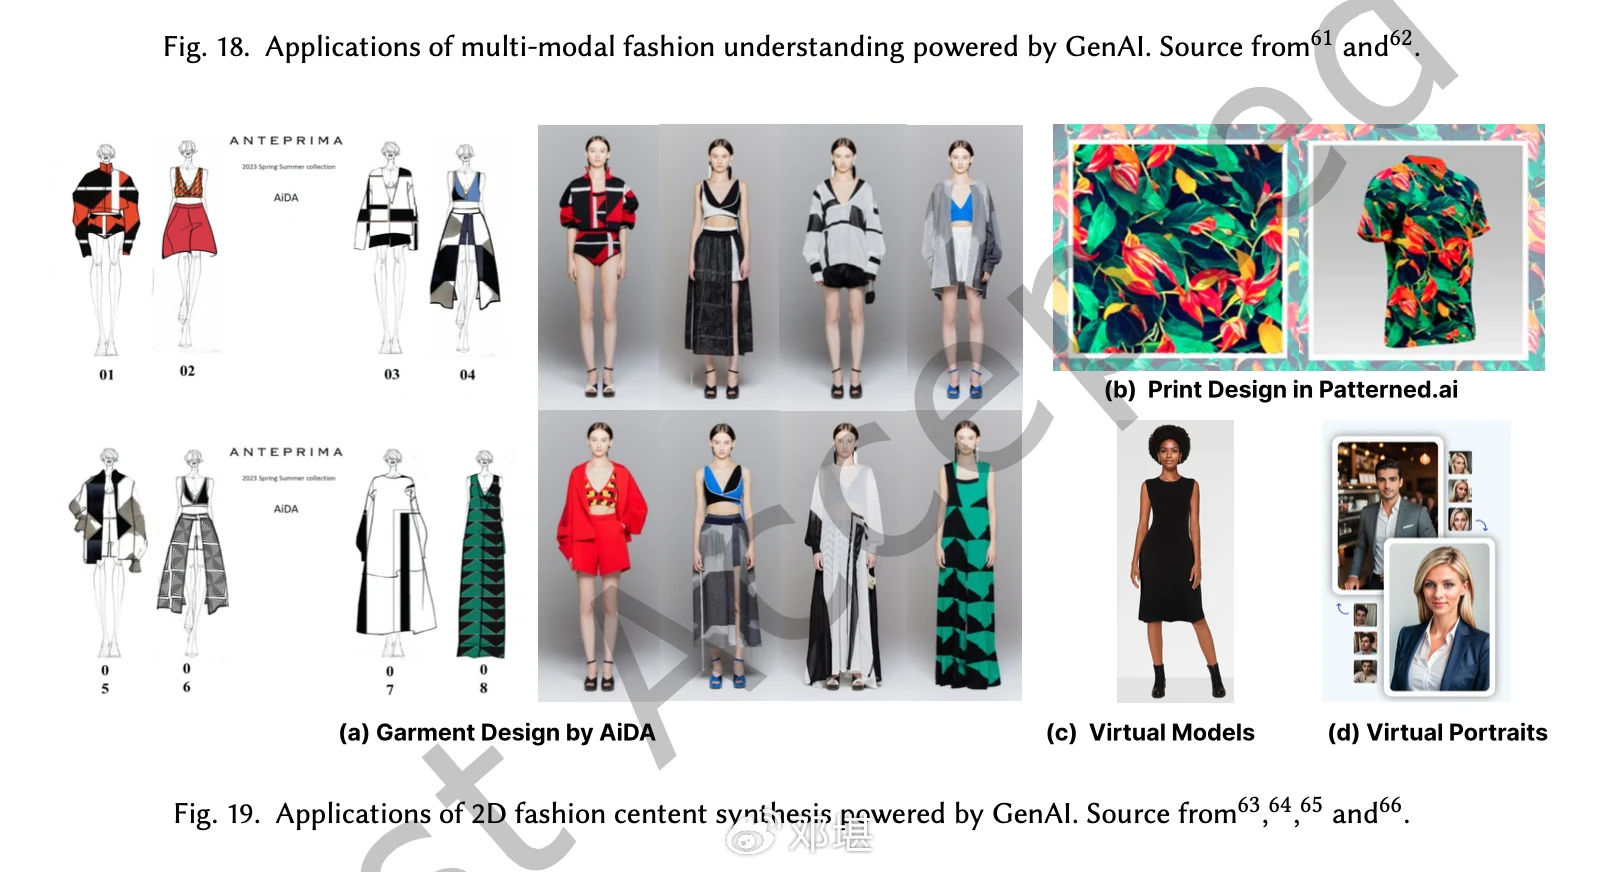
图19
6.3 3D/4D时尚内容合成
3D服装重建。3Dpresso68从视频中提取3D服装模型,如图20(a)所示。该技术简化了服装数字孪生的创建,促进了电子商务、虚拟试穿和数字档案中的应用,增强了设计过程和消费者购物体验。人体动作捕捉。Plask69提供了一种AI驱动的动作捕捉(mocap)动画工具,简化了从视频中提取人体动作的过程,如图20(b)所示。它设计用于快速原型设计和增强游戏、电影和虚拟现实等多个行业的3D工作流程。Plask使创建和集成动画到项目中变得高效且用户友好,支持全球超过10万创作者革新其动画和动作捕捉任务。
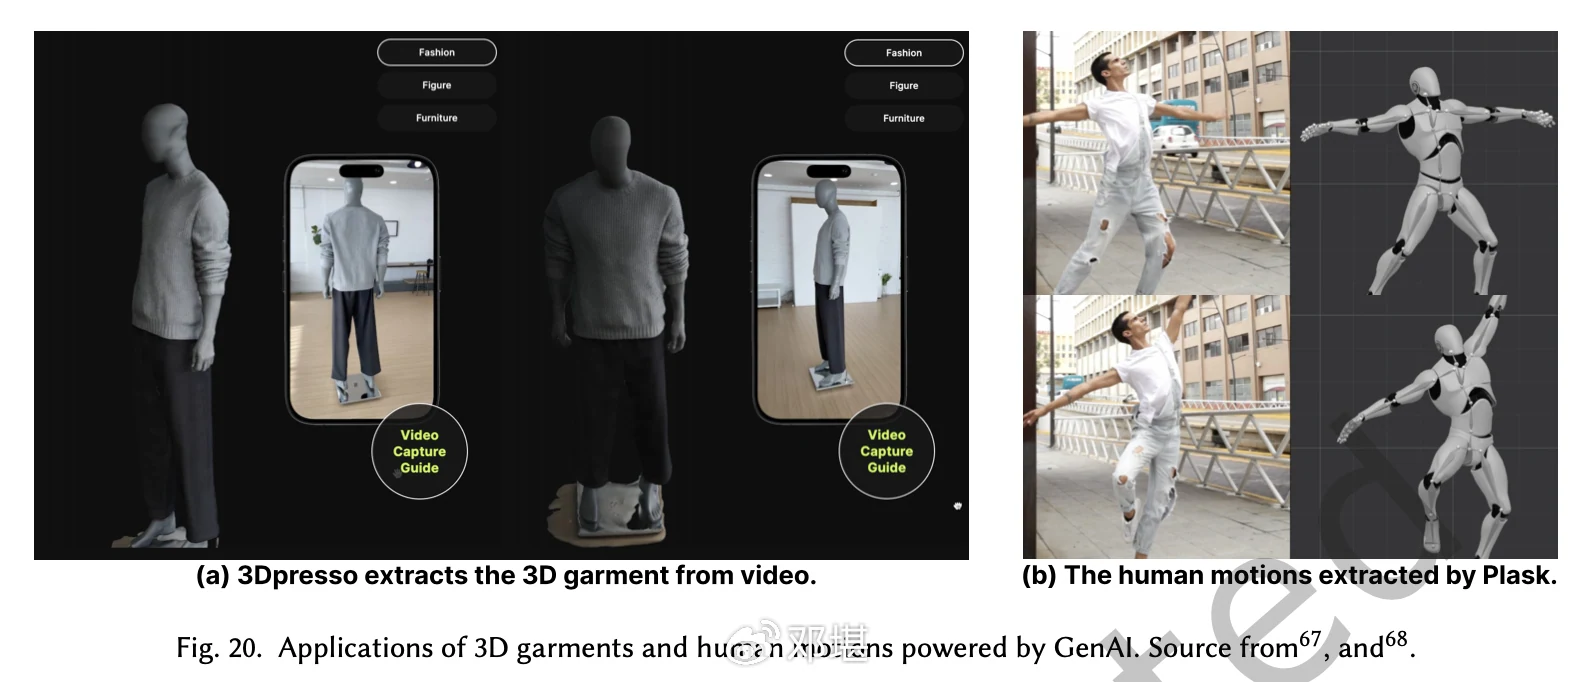
图20
7. 未来方向
7.1 挑战
对齐人类与AI的输入
GenAI的最新进展以“规模”为核心,在多模态特征对齐方面取得了重大突破,预计将影响时尚相关任务并提升当前成果。然而,将通用模型应用于特定领域不可避免地会带来许多挑战,时尚仍然是计算机科学中一个特别困难的领域。创建AI模型以协助时尚行业中的各种角色(如卖家、造型师、设计师和买家,详见A.3)可以现代化其基础设施并推动经济,但教会AI模型理解时尚仍面临重大挑战。主要原因在于人类和计算机系统输入的根本差异。人脑接收感官输入,通常是视觉、嗅觉、味觉、听觉和触觉,而计算机系统依赖摄像头、键盘和鼠标等硬件设备。现有AI技术的大多数成就基于集中、静态和分阶段准备的数据。相比之下,人类感知源于与外部物理世界的持续互动和反馈,以自我为中心不断更新和迭代。关于NeuroAI[128, 528]的最新研究提出了通过外部互动理解感知世界的想法,但相关研究仍处于起步阶段。
时尚感知与创作的专业能力
大型语言模型(LLMs)的出现引发了关于其能力和局限性的讨论[386]。尽管这些模型展示了令人印象深刻的能力,但它们往往难以捕捉时尚草图[86]和时尚图像中风格与内容微妙互动的细微差别[268],尤其是从专业角度来看。例如,图21的第一行展示了Maison Margiela Artisanal Collection 2024的造型,不同肤色和性别的例子。对于第一个造型,最先进的语言模型将服装描述为“一套黑色服装,包括一条高腰裤和一件在腰部系有黑色腰带的白色衬衫”。然而,男性并不穿在腰部系有白色衬衫,而是一件紧身胸衣。更专业的说法是,这种视觉灵感源自18世纪末和19世纪初。18世纪末,军官和花花公子会在外衣下穿类似的紧身胸衣以矫正体型。这种紧身胸衣的极端轮廓类似于紧身胸衣之王Mr Pearl或Fakir Musafar的风格。可以看出,现有模型试图更详细地描述,但内容缺乏实质,未能切中要点,这表明当前AI模型在特定领域达到专业水平存在巨大差距。时尚设计的创意并非随机,而是高度逻辑化的,每个元素的选择都服务于统一的主题。T台上的模特顺序、面料选择、服装轮廓和剪裁技术都贡献于这一内在逻辑。设计的精髓在于创造情感和新感知,这些都是当前AI模型难以实现的。
不完整或有偏见的算法
即使不优先考虑高端水平的“感知”,仅依赖时尚的视觉理解仍存在许多挑战。根据我们的理解,当前最先进的(SOTA)模型难以精确识别图像中的所有复杂时尚属性,并倾向于延续关于肤色和性别的某些偏见。我们尝试模拟时尚设计师如何从时装秀中汲取灵感,并将这些概念转化为新设计,通过将T台图像转换为关键词(文本),然后根据文本重新创建图像,如图21所示,标题在A.4中详细说明。例如,如图21的第3和第5列所示,长风衣和豹纹靴的存在导致模型错误地假设所描绘的个体为女性。此外,如图21的第4和第6列所示,模型忽略了黑人和亚洲人的肤色描述,默认生成了白人女性模型。这种偏见可能源于数据集的来源,主要来自西方在线购物平台。即使不考虑高级定制中的属性,识别模型在识别日常生活中常见属性(如彼得潘领或羊腿袖)时也常遇到困难,因为这些属性属于长尾分布。时尚领域中大量的属性为更高级别的任务(如兼容性学习、生成设计或3D/4D生成)引入了额外的挑战。
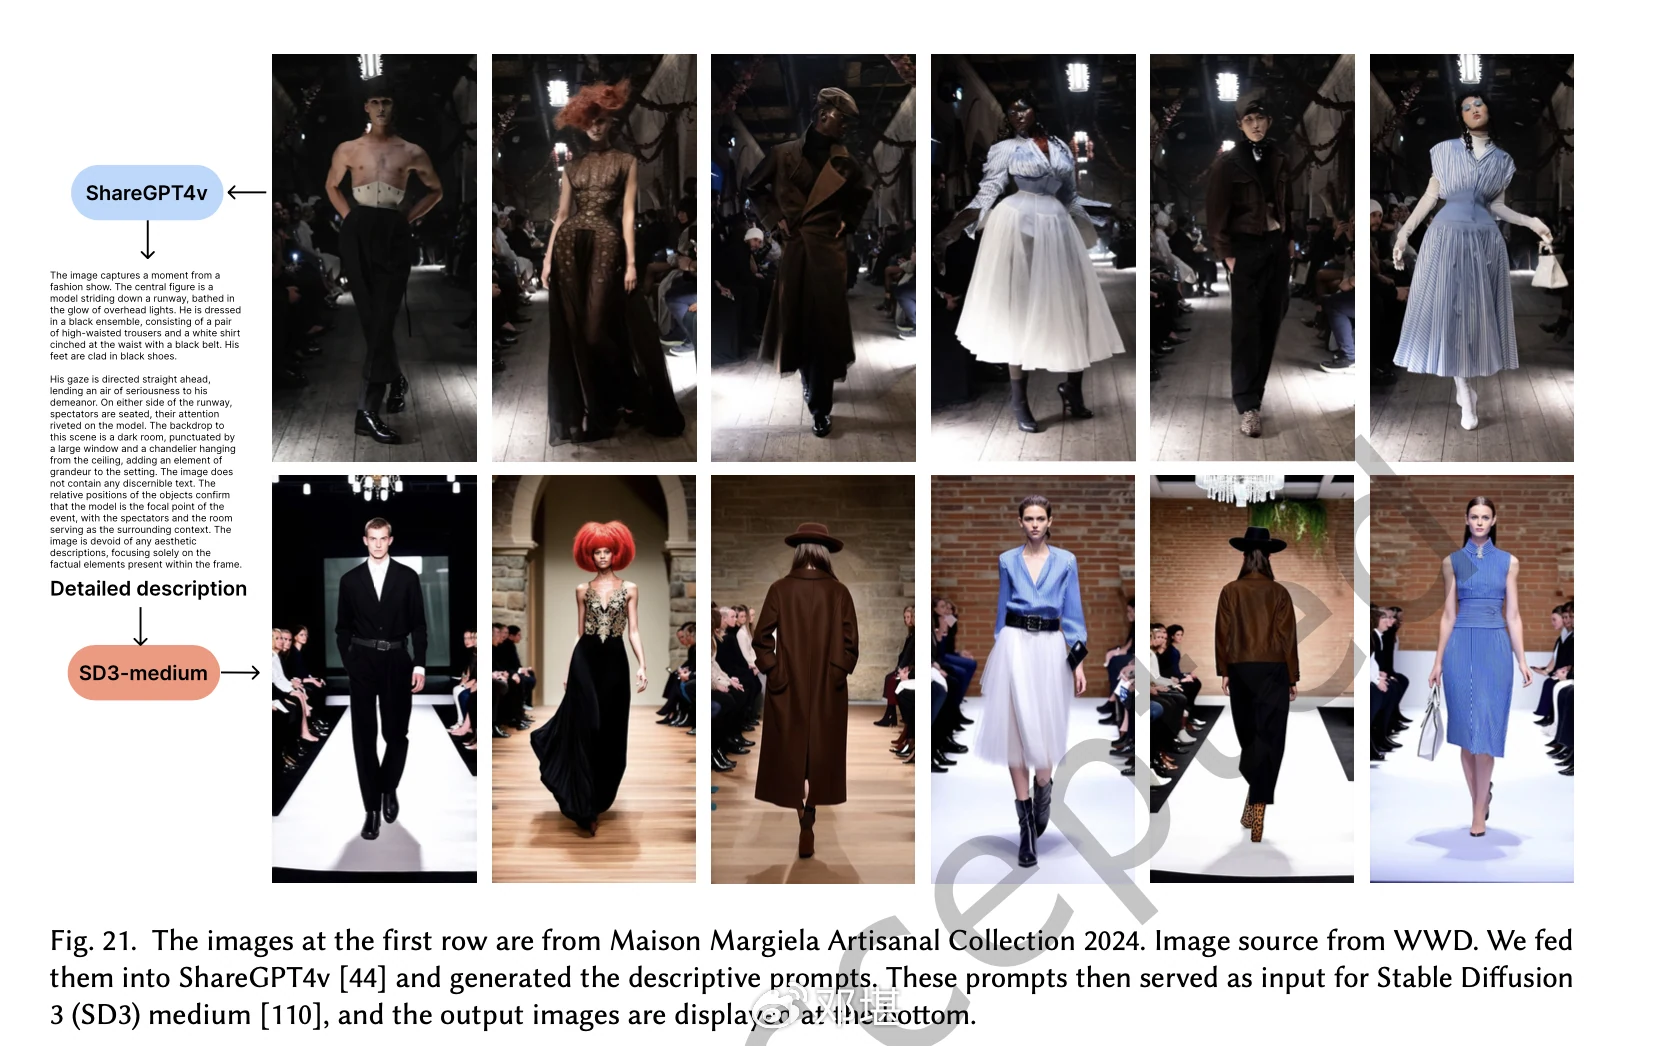
图21
更多模态与情境化。时尚超越了服装的外观,还包括纹理、动作和声音等元素。这在时装秀、广告和时尚单品穿着的场景中显而易见。这些元素传达了穿着者的个性和情感状态[107, 494]。多模态时尚理解不仅涉及文本和视觉数据,还包括音频、视频和3D模型。每种模态都有其独特的特征和维度(如2D图像、时间波形、3D网格)。通过整体方法捕捉和表达时尚的多方面特性具有挑战性。确保跨模态的一致性至关重要;例如,服装纹理的文本描述应与其视觉和触觉表示相匹配。此外,时尚单品通常带有无法直接从原始数据中观察到的情境和文化意义。整合这种级别的理解需要模型超越数据表示,进行抽象推理。
促进AI在时尚中的理性采用
时尚行业对AI持有不同态度。一些艺术家和公司,如CV dazzle70使用化妆品对抗面部识别算法,以及Dove抵制AI虚拟模特71,采取了谨慎或对抗的态度。然而,AI为许多没有专业设计背景的时尚爱好者提供了参与时尚活动的机会72。为了促进AI在时尚行业中的更理性采用,伦理考虑可能是重中之重。如何定义GenAI结果的版权所有权以及新时代艺术创作知识产权的法律修订需要各方仔细考虑。时尚品牌需要评估AI对隐私、文化敏感性和包容性的影响,并从相关倡议中吸取教训。此外,关注多样化和具有代表性的数据集可以减少偏见,使AI应用吸引广泛的消费者群体,包括那些因文化、宗教或健康原因遮脸的人群。负责任的AI需要通过所有利益相关者的参与,并承诺持续监控和评估。
数据与模型的正则化
另一个挑战是时尚数据和模型的正则化。主要困难在于识别哪些趋势被过度代表,哪些被代表不足。时尚趋势可能是季节性的且变化迅速,跟上它们非常困难。此外,时尚数据可能是稀疏的,尤其是对于新兴或小众趋势。在这种情况下正则化可能很棘手,因为信息有限。同时,如何避免收集的数据不被故意操纵,尤其是在时尚业务中应用预测或分析技术时。这里可以使用迁移学习等技术,利用数据丰富趋势的知识增强数据贫乏趋势的表示。同时,在模型训练中集成交叉验证以避免可能污染的数据。
7.2 未来方向
由于这主要涉及时尚领域内的细微知识而非技术进步,我们选择省略工业应用部分,转而从研究角度总结可能性。
知识增强的基础模型
如第7.1节所述,时尚领域最典型的挑战之一是缺乏专业领域知识。尽管在大量数据上训练,当前的基础模型仍因缺乏结构化知识而难以理解领域内的特定部分。设计针对特定领域的结构化知识系统有利于模型训练,是一种直接但成本高昂的方法。或者,利用网络剪枝和知识蒸馏[203]等技术为增强知识提供了潜在的解决方案。
语义理解与情境化
自然语言天然具有模糊性。在从通用模型过渡到垂直领域专用模型时,消除领域带来的语义模糊也是一个有价值的方向。一种解决路径是增强情境学习[102]和对相应领域数据的微调。在持续学习框架中,设计模型在交互中理解上下文的机制是一种更优雅的解决方案。
视觉生成模型的可控性
如前所述,许多研究聚焦于时尚领域的视觉生成。然而,除了优先考虑高质量和模式覆盖/多样性外,可控性成为更新GenAI实际应用中设计工作流程的关键因素[516, 539]。这主要源于设计的固有性质。设计师通常对他们期望的结果有清晰的愿景,通常源自早期灵感和研究。一旦构思过程完成,他们心中就有了一个精炼的概念。虽然当前的生成工具可以提供多样化的高质量灵感,但在支持详细修改同时保持设计与其余部分一致性方面往往不足。这一局限性严重阻碍了GenAI在设计领域的应用。
高精度3D时尚内容合成
可持续性长期以来一直是时尚行业的重要主题,促使人们不断尝试将基础AI和前沿技术结合。元宇宙、非同质化代币(NFTs)和数字ID等概念与时尚领域高度相关。这些创新与3D时尚内容的合成密切相关。如图22所示,左侧图像作为最新3D生成算法TRELLIS[473]和流行商业工具Tripo AI的输入。在图22(a)中,模特的面部被误解为场景,而在(b)中,手部的精细细节和裙子的薄层织物纹理难以准确重建。这突显了实现精确3D服装生成的持续困难。此外,薄层和多层复杂性在时尚情境中很常见[588]。此外,实现准确的纹理表示、捕捉服装运动动态以及复制精细设计元素(如孔洞、珠饰、亮片和层叠)进一步增加了复杂性。
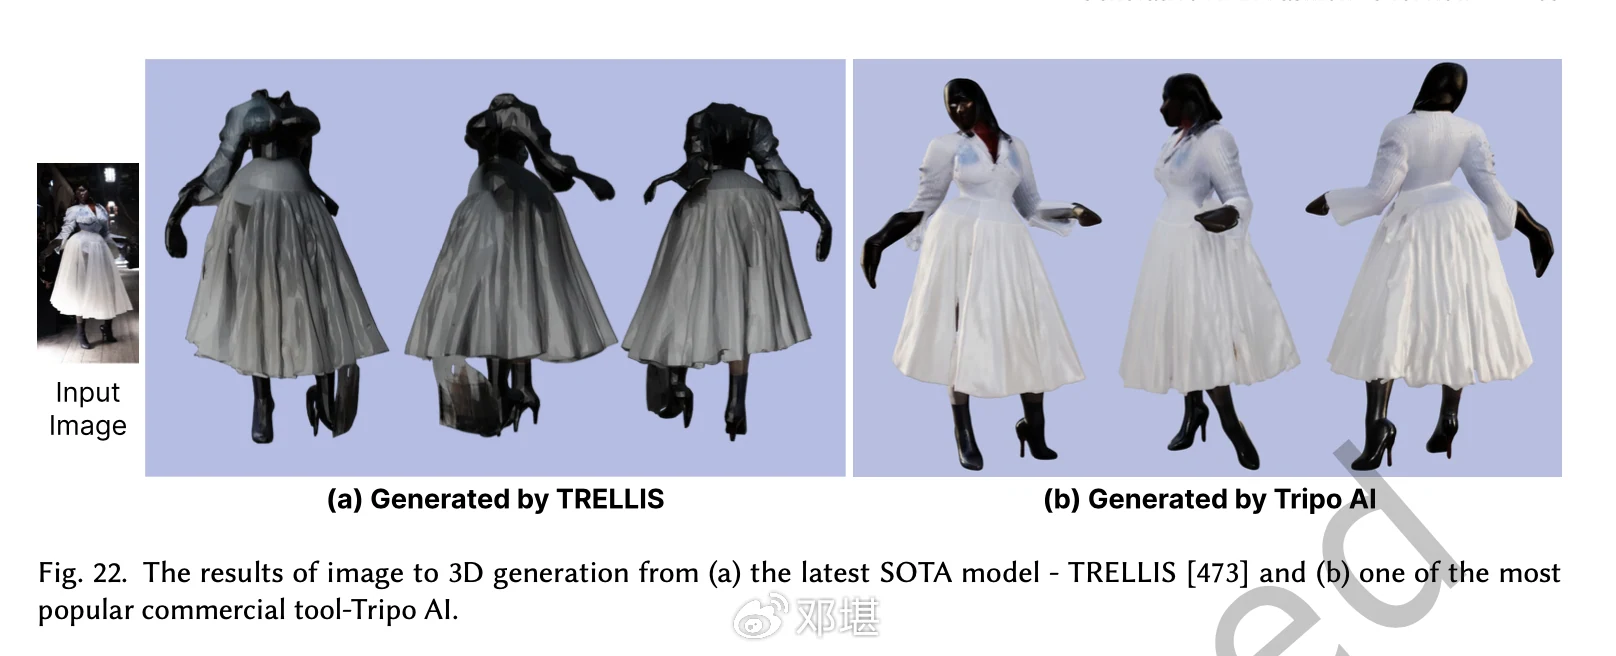
图22
合成数据构建
合成数据在解决GenAI应用中数据相关关键挑战方面发挥着至关重要的作用。这些挑战包括数据质量问题、缺乏足够数据点可能导致模型欠拟合,以及由于隐私、安全和监管限制导致的数据访问复杂性[307, 345]。在时尚领域,出现了一种利用渲染引擎创建合成训练数据的新兴趋势,越来越多的研究[18, 317, 352, 389, 588]利用渲染引擎为时尚领域创建合成训练数据。例如,TailorNet[352]使用Marvelous Designer 74生成用于服装预测任务的合成数据。CLOTH3D[18]利用强大的开源3D创作套件Blender 75模拟织物的物理特性。此外,D-LAYERS[389]通过在Blender中对服装施加不同方向和强度的风力作为力场生成合成数据。类似地,CLOTH4D[588]使用CLO3D 76为时尚领域创建合成数据集。这种将先进渲染技术集成到合成数据生成中不仅提高了训练数据的质量和数量,还为时尚设计和制造开辟了新的创新可能性。
知识产权保护
随着GenAI预计将应用于时尚的各个领域,研究AI抄袭检查器的潜力巨大。现有方法,如[112, 118,462, 568]中讨论的,将水印嵌入图像中,使其能够抵抗各种变换。这种方法可能对时尚品牌有益。通过将商标或唯一标识符嵌入图像中,品牌可以确保即使图像被修改,水印仍保持完整,从而保持可追溯性并实现所有权验证[112]。此外,引入使用对抗攻击的隐藏水印,如[532]所述,代表了一个有前途的研究方向。这一策略可以帮助防止未经授权的方未经许可使用公司资产进行模型训练。
GenAI中的模型崩溃
GenAI技术如SD3[110]和GPT-4[2]已经通过人类反馈强化学习(RLHF)[245]和直接偏好优化(DP O)[366]与人类进入反馈循环。在这种反馈循环中,如果AI模型依赖人类反馈进行训练,而这种反馈又受模型自身生成结果的影响,则可能出现递归训练情况。这种情况可能导致生成过于相似的样本,缺乏多样性——这种现象称为模型崩溃[398]。然而,人类智能的运作方式不同。许多经典的时尚设计融入了其他设计师作品中的元素。人类有能力借鉴他人的想法,并将其与个人风格融合以创造新事物。使GenAI模型能够模拟这种创造力是一个有趣的探索领域。
8. 结论
本工作对GenAI在时尚相关任务和应用中的表现进行了全面考察。在分析了470多篇论文和300多个应用后,我们确定了关键趋势和进展,重点关注四大类中的13项具体任务:多模态时尚理解,以及基于图像、3D和动态(视频和可动画3D)格式的时尚合成。此外,我们回顾了53个公开可用的基准和相关评估指标。GenAI显著增强了时尚行业的各个方面,包括时尚推荐系统、虚拟试穿、服装和图案设计。以下是一些要点总结:
多模态时尚理解:时尚图像属性识别的精度已达到90%的高点,但图像与文本之间的跨模态检索准确率仍落后于约70%[159, 160, 402]。在数据集方面,现有的跨模态时尚理解模型主要局限于文本-图像对。几乎没有时尚导向的模型尝试超越这一点,包括视频-文本和3D-文本等其他模态,这些对于更全面的时尚数据理解至关重要。
基于图像的时尚合成:时尚图像生成和编辑的最新进展使得控制细粒度属性(如纽扣数量[544])的生成成为可能。从单一上衣(纯白背景)的传统试穿结果变得越来越逼真。未来的研究重点将开始转向考虑更复杂的情况和涉及真实场景的任务,例如同时考虑上衣和下装[582],以及输入具有复杂背景(非纯白背景)的时尚图像[74]。大多数这些新任务伴随着新的数据集。
基于3D的时尚合成:当前3D着装人体模型、服装和缝制图案的状态尚未成熟,无法直接应用于时尚行业。然而,缝制图案发展迅速,尤其是随着GenAI的出现。例如,基于Transformer的模型现在可以直接从文本[162]或图像[282]生成图案。在数据集方面,有大量资源可用,包括数百万的3D服装数据[18, 320]和超过10万个开源的缝制图案数据[234]。
基于动态的时尚合成:当前的服装动画[350, 352, 381, 554]和基于视频的试穿[168, 207]方法通常需要预定义的身体运动序列,这些不如文本到图像或文本到3D生成结果灵活或多样。这一限制也是由于缺乏相应的数据支持。
我们的综述中提出的未来方向突出了GenAI在时尚领域的几个研究机会,包括需要:
1)通过领域特定知识增强通用基础模型;
2)提高语义理解和情境化能力;
3)增加视觉生成的可控性;
4)确保3D时尚合成的更高精度;
5)构建有价值的合成数据;
6)在时尚资产中实现知识产权水印;
7)防止模型崩溃。
随着GenAI的持续发展,我们预期时尚行业将进一步转型,技术将在时尚设计、生产流程和消费者体验中变得更加深度融合。
【鸣谢】
本文所述的工作得到了中国香港特别行政区研究资助局的资助(项目编号:理大/研资局项目PolyU 25 211424),并获理大大学启动基金部分资助(项目编号:P0047675)。
【参考文献】
[1] Fatma S. Abousaleh, Wen-Huang Cheng, Neng-Hao Yu, and Yu Tsao. 2021. Multimodal Deep Learning Framework for Image Popularity Prediction on Social Media. IEEE Transactions on Cogni tive and Developmental Systems 13, 3 (Sept. 2021), 679–692. https://doi.org/10.1109/TCDS.2020.3036690 Conference Name: IEEE Transactions on Cognitive and Developmental Systems.
[2]JoshAchiam,StevenAdler,SandhiniAgarwal,LamaAhmad,IlgeAkkaya,FlorenciaLeoniAleman,Diog oAlmeida,JankoAltenschmidt, Sam Altman, Shyamal Anadkat, et al. 2023. Gpt-4 technical report. a rXiv preprint arXiv:2303.08774 (2023).
[3]AlakhAggarwal,JikaiWang,StevenHogue,SaifengNi,MadhukarBudagavi,andXiaohuGuo.2022.La yered-GarmentNet:Generating Multiple Implicit Garment Layers from a Single Image. 3000–3017.[4]ParamAggarwal.2023.FashionProductImages(Small).https://www.kaggle.com/datasets/paramag garwal/fashion-product-images- small.
[5] Kenan E. Ak, Ashraf A. Kassim, Joo Hwee Lim, and Jo Yew Tam. 2018. Learning Atribute Repr esentations with Localization for
Flexible Fashion Search. In 2018 IEEE/CVF Conference on Computer Vision and Patern Recogniti on. 7708–7717. ISSN: 2575-7075.
[6] Kenan E Ak, Joo Hwee Lim, Jo Yew Tam, and Ashraf A Kassim. 2018. Efcient multi-atribute sim ilarity learning towards atribute-based
fashion search. In 2018 IEEE Winter Conference on Applications of Computer Vision (WACV). IEE E, 1671–1679.
[7] Kenan E Ak, Joo Hwee Lim, Jo Yew Tam, and Ashraf A Kassim. 2019. Atribute manipulation ge nerative adversarial networks for
fashion images. In Proceedings of the IEEE/CVF International Conference on Computer Vision. 10 541–10550.
[8] Afra Feyza Akyurek, Ekin Akyurek, Ashwin Kalyan, Peter Clark, Derry Tanti Wijaya, and Niket T andon. 2023. RL4F: Generating
Natural Language Feedback with Reinforcement Learning for Repairing Model Outputs. In Procee dings of the 61st Annual Meeting of
the Association for Computational Linguistics (ACL). Association for Computational Linguistics, Tor onto, Canada, 7716–7733.
[9] Ziad Al-Halah and Kristen Grauman. 2021. Modeling Fashion Infuence From Photos. IEEE Tran sactions on Multimedia 23 (2021),
4143–4157. https://doi.org/10.1109/TMM.2020.3037459 Conference Name: IEEE Transactions on Multimedia.
[10] Tiemo Alldieck, Marcus Magnor, Bharat Lal Bhatnagar, Christian Teobalt, and Gerard Pons-Mo ll. 2019. Learning to reconstruct
people in clothing from a single RGB camera. In Proceedings of the IEEE/CVF Conference on Co mputer Vision and Patern Recognition.
1175–1186.
[11] Tiemo Alldieck, Marcus Magnor, Weipeng Xu, Christian Teobalt, and Gerard Pons-Moll. 2018.Video based reconstruction of 3d
people models. In Proceedings of the IEEE Conference on Computer Vision and Patern Recognitio n. 8387–8397.
[12] Tiemo Alldieck, Mihai Zanfr, and Cristian Sminchisescu. 2022. Photorealistic monocular 3d rec onstruction of humans wearing
clothing. In Proceedings of the IEEE/CVF Conference on Computer Vision and Patern Recognition. 1506–1515.
[13] Eunsoo Baek et al. 2022. Defning Digital Fashion: Reshaping the Field via a Systematic Revie w. Computers in Human Behavior 137
(2022), 107407.
[14] Shuai Bai, Huiling Zhou, Zhikang Li, Chang Zhou, and Hongxia Yang. 2022. Single Stage Virtu al Try-On Via Deformable Atention Flows.
In Computer Vision – ECCV 2022: 17th European Conference, Tel Aviv, Israel, October 23–27, 202 2, Proceedings, Part XV. Springer-Verlag,
Berlin, Heidelberg, 409–425. https://doi.org/10.1007/978-3-031-19784-0_24
[15] Alberto Baldrati, Marco Bertini, Tiberio Uricchio, and Alberto Del Bimbo. 2022. Efective conditi oned and composed image retrieval
combining clip-based features. In Proceedings of the IEEE/CVF conference on computer vision an d patern recognition. 21466–21474.
[16] Alberto Baldrati, Davide Morelli, Giuseppe Cartella, Marcella Cornia, Marco Bertini, and Rita C ucchiara. 2023. Multimodal garment
designer: Human-centric latent difusion models for fashion image editing. In Proceedings of the IE EE/CVF International Conference on
Computer Vision. 23393–23402.
[17] Debopriyo Banerjee, Krothapalli Sreenivasa Rao, Shamik Sural, and Niloy Ganguly. 2020. Box rec: recommending a box of preferred
outfts in online shopping. ACM Transactions on Intelligent Systems and Technology (TIST) 11, 6 (2 020), 1–28.
[18] Hugo Bertiche, Meysam Madadi, and Sergio Escalera. 2020. CLOTH3D: Clothed 3D Humans.In Computer Vision – ECCV 2020
(Lecture Notes in Computer Science), Andrea Vedaldi, Horst Bischof, Tomas Brox, and Jan-Micha el Frahm (Eds.). Springer International
Publishing, Cham, 344–359. https://doi.org/10.1007/978-3-030-58565-5_21
[19] Hugo Bertiche, Meysam Madadi, and Sergio Escalera. 2021. PBNS: physically based neural si mulation for unsupervised garment pose
space deformation. ACM Transactions on Graphics 40, 6 (Dec. 2021), 198:1–198:14. https://doi.or g/10.1145/3478513.3480479
[20] Hugo Bertiche, Meysam Madadi, Emilio Tylson, and Sergio Escalera. 2021. DeePSD: Automat ic deep skinning and pose space
deformation for 3D garment animation. In Proceedings of the IEEE/CVF International Conference o n Computer Vision. 5471–5480.
[21] Bharat Lal Bhatnagar, Garvita Tiwari, Christian Teobalt, and Gerard Pons-Moll. 2019. Multi-gar ment net: Learning to dress 3d people
from images. In Proceedings of the IEEE/CVF international conference on computer vision. 5420–5430.
[22] Gaurab Bhatacharya, Nikhil Kilari, Jayavardhana Gubbi, Bagya Lakshmi V, Arpan Pal, and Bal amuralidhar P. 2022. DAtRNet:
Disentangling Fashion Atribute Embedding for Substitute Item Retrieval. In 2022 IEEE/CVF Confer ence on Computer Vision and Patern
Recognition Workshops (CVPRW). 2282–2286. https://doi.org/10.1109/CVPRW56347.2022.00253 ISSN: 2160-7516.
[23] Andrei Burov, Mathias Nießner, and Justus Ties. 2021. Dynamic surface function networks for clothed human bodies. In Proceedings
of the IEEE/CVF International Conference on Computer Vision. 10754–10764.
[24] Nadide Caglayan, Sule Itir Satoglu, and E Nisa Kapukaya. 2020. Sales forecasting by artifcial neural networks for the apparel retail
chain stores. In Intelligent and Fuzzy Techniques in Big Data Analytics and Decision Making: Proce edings of the INFUS 2019 Conference,
Istanbul, Turkey, July 23-25, 2019. Springer, 451–456.
[25] Akin Caliskan, Armin Mustafa, Evren Imre, and Adrian Hilton. 2021. Multi-view Consistency Lo ss for Improved Single-Image 3D
Reconstruction of Clothed People. In Computer Vision – ACCV 2020 (Lecture Notes in Computer Science), Hiroshi Ishikawa, Cheng-Lin
Liu, Tomas Pajdla, and Jianbo Shi (Eds.). Springer International Publishing, Cham, 71–88. https://d oi.org/10.1007/978-3-030-69525-5_5
[26] Shidong Cao, Wenhao Chai, Shengyu Hao, and Gaoang Wang. 2023. Image reference-guide d fashion design with structure-aware
transfer by difusion models. In Proceedings of the IEEE/CVF Conference on Computer Vision and Patern Recognition. 3524–3528.
[27] Yukang Cao, Yan-Pei Cao, Kai Han, Ying Shan, and Kwan-Yee K Wong. 2024. Dreamavatar:Text-and-shape guided 3d human avatar
generation via difusion models. In Proceedings of the IEEE/CVF Conference on Computer Vision a nd Patern Recognition. 958–968.
[28] Yukang Cao, Guanying Chen, Kai Han, Wenqi Yang, and Kwan-Yee K Wong. 2022. Jif: Jointly-aligned implicit face function for
high quality single view clothed human reconstruction. In Proceedings of the IEEE/CVF Conferenc e on Computer Vision and Patern
Recognition. 2729–2739.
[29] Yukang Cao, Kai Han, and Kwan-Yee K Wong. 2023. Sesdf: Self-evolved signed distance feld for implicit 3d clothed human reconstruction.
In Proceedings of the IEEE/CVF Conference on Computer Vision and Patern Recognition. 4647–4 657.
[30] Giuseppe Cartella, Alberto Baldrati, Davide Morelli, Marcella Cornia, Marco Bertini, and Rita C ucchiara. 2023. OpenFashionCLIP:
Vision-and-language contrastive learning with open-source fashion data. In International Conferen ce on Image Analysis and Processing.
Springer, 245–256.
[31] George Cazenavete, Tongzhou Wang, Antonio Torralba, Alexei A Efros, and Jun-Yan Zhu. 202 2. Wearable imagenet: Synthesizing
tileable textures via dataset distillation. In Proceedings of the IEEE/CVF Conference on Computer Vision and Patern Recognition. 2278–2282.
[32] Samit Chakraborty et al. 2021. Fashion Recommendation Systems, Models and Methods: A R eview. Informatics 8, 3 (2021), 49.
[33] Samit Chakraborty, Md Saiful Hoque, Naimur Rahman Jeem, Manik Chandra Biswas, Deepay an Bardhan, and Edgar Lobaton. 2021.
Fashion recommendation systems, models and methods: A review. In Informatics, Vol. 8. MDPI, 49.
[34] Eric R Chan, Connor Z Lin, Mathew A Chan, Koki Nagano, Boxiao Pan, Shalini De Mello, Oraz io Gallo, Leonidas J Guibas, Jonathan
Tremblay, Sameh Khamis, et al. 2022. Efcient geometry-aware 3d generative adversarial networks. In Proceedings of the IEEE/CVF
conference on computer vision and patern recognition. 16123–16133.
[35] Kennard Yanting Chan, Fayao Liu, Guosheng Lin, Chuan Sheng Foo, and Weisi Lin. 2024. R-Cyclic Difuser: Reductive and Cyclic
Latent Difusion for 3D Clothed Human Digitalization. In Proceedings of the IEEE/CVF Conference on Computer Vision and Patern
Recognition (CVPR). 10304–10313.
[36] Yu-Ting Chang, Wen-Huang Cheng, Bo Wu, and Kai-Lung Hua. 2017. Fashion world map: Un derstanding cities through streetwear
fashion. In Proceedings of the 25th ACM international conference on Multimedia. 91–99.
[37] Cheng-Hsiu Chen, Jheng-Wei Su, Min-Chun Hu, Chih-Yuan Yao, and Hung-Kuo Chu. 2024. P anelformer: Sewing Patern Reconstruction
from 2D Garment Images. In Proceedings of the IEEE/CVF Winter Conference on Applications of Computer Vision. 454–463.
[38] Chieh-Yun Chen, Ling Lo, Pin-Jui Huang, Hong-Han Shuai, and Wen-Huang Cheng. 2021. Fa shionmirror: Co-atention featureremapping virtual try-on with sequential template poses. In Procee dings of the IEEE/CVF International Conference on Computer Vision.
13809–13818.
[39] Huizhong Chen, Andrew Gallagher, and Bernd Girod. 2012. Describing clothing by semantic at ributes. In Computer Vision–ECCV
2012: 12th European Conference on Computer Vision, Florence, Italy, October 7-13, 2012, Procee dings, Part III 12. Springer, 609–623.
[40] Hung-Jen Chen, Hong-Han Shuai, and Wen-Huang Cheng. 2023. A survey of artifcial intellige nce in fashion. IEEE Signal Processing
Magazine 40, 3 (2023), 64–73.
[41] Hung-Jen Chen, Hong-Han Shuai, and Wen-Huang Cheng. 2023. A Survey of Artifcial Intellige nce in Fashion. IEEE Signal Processing
Magazine 40, 3 (May 2023), 64–73. https://doi.org/10.1109/MSP.2022.3233449
[42] Kuan-Ting Chen and Jiebo Luo. 2017. When fashion meets big data: Discriminative mining of best selling clothing features. In
Proceedings of the 26th international conference on world wide web companion. 15–22.
[43] Long Chen and Yuhang He. 2018. Dress fashionably: Learn fashion collocation with deep mix ed-category metric learning. In Proceedings
of the AAAI conference on artifcial intelligence, Vol. 32.
[44] Lin Chen, Jinsong Li, Xiaoyi Dong, Pan Zhang, Conghui He, Jiaqi Wang, Feng Zhao, and Dah ua Lin. 2025. Sharegpt4v: Improving large
multi-modal models with beter captions. In European Conference on Computer Vision. Springer, 37 0–387.
[45] Lele Chen, Justin Tian, Guo Li, Cheng-Haw Wu, Erh-Kan King, Kuan-Ting Chen, Shao-Hang Hsieh, and Chenliang Xu. 2020. Tailorgan:
Making user-defned fashion designs. In Proceedings of the IEEE/CVF Winter Conference on Appli cations of Computer Vision. 3241–3250.
[46] Lifang Chen, Enting Yu, and Honglian Cong. 2022. Feature fusion network for clothing parsing. International Journal of Machine
Learning and Cybernetics 13, 8 (Aug. 2022), 2229–2238. https://doi.org/10.1007/s13042-022-0151 9-5
[47] Qianqian Chen, Tianyi Zhang, Maowen Nie, Zheng Wang, Shihao Xu, Wei Shi, and Zhao Cao.2023. Fashion-GPT: Integrating LLMs
with Fashion Retrieval System. In Proceedings of the 1st Workshop on Large Generative Models Meet Multimodal Applications. 69–78.
[48] Wen Chen, Pipei Huang, Jiaming Xu, Xin Guo, Cheng Guo, Fei Sun, Chao Li, Andreas Pfadler, Huan Zhao, and Binqiang Zhao.
2019. POG: personalized outft generation for fashion recommendation at Alibaba iFashion. In Proc eedings of the 25th ACM SIGKDD
international conference on knowledge discovery & data mining. 2662–2670.
[49] Xu Chen, Hanxiong Chen, Hongteng Xu, Yongfeng Zhang, Yixin Cao, Zheng Qin, and Hongyu an Zha. 2019. Personalized fashion
recommendation with visual explanations based on multimodal atention network: Towards visually explainable recommendation. In
Proceedings of the 42nd International ACM SIGIR Conference on Research and Development in I nformation Retrieval. 765–774.
[50] Xin Chen, Anqi Pang, Wei Yang, Peihao Wang, Lan Xu, and Jingyi Yu. 2021. TightCap: 3D Hu man Shape Capture with Clothing
Tightness Field. ACM Transactions on Graphics 41, 1 (Nov. 2021), 9:1–9:17. https://doi.org/10.114 5/3478518
[51] Xipeng Chen, Guangrun Wang, Xiaogang Xu, Philip Torr, and Liang Lin. 2024. Parametric Line ar Blend Skinning Model for MultipleShape 3D Garments. IEEE Transactions on Visualization and Computer Graphics (2024).
[52] Xu Chen, Yufeng Zheng, Michael J Black, Otmar Hilliges, and Andreas Geiger. 2021. Snarf: Di ferentiable forward skinning for
animating non-rigid neural implicit shapes. In Proceedings of the IEEE/CVF International Conferen ce on Computer Vision. 11594–11604.[53] Xiaowu Chen, Bin Zhou, Feixiang Lu, Lin Wang, Lang Bi, and Ping Tan. 2015. Garment modeli ng with a depth camera. ACM
Transactions on Graphics 34, 6 (Nov. 2015), 203:1–203:12. https://doi.org/10.1145/2816795.28180 59
[54] Yanbei Chen, Shaogang Gong, and Loris Bazzani. 2020. Image search with text feedback by visiolinguistic atention learning. In
Proceedings of the IEEE/CVF Conference on Computer Vision and Patern Recognition. 3001–301 1.
[55] Wen-Huang Cheng. 2021. Fashion Meets Computer Vision. In Proceedings of the 1st Worksh op on Multimedia Computing towards
Fashion Recommendation. ACM, Lisboa Portugal, 1–1. https://doi.org/10.1145/3552468.3554360[56] Wen-Huang Cheng, Sijie Song, Chieh-Yun Chen, Shintami Chusnul Hidayati, and Jiaying Liu.2021. Fashion meets computer vision: A
survey. ACM Computing Surveys (CSUR) 54, 4 (2021), 1–41.
[57] Zhi-Qi Cheng, Xiao Wu, Yang Liu, and Xian-Sheng Hua. 2017. Video2shop: Exact matching cl othes in videos to online shopping
images. In Proceedings of the IEEE conference on computer vision and patern recognition. 4048–4056.
[58] Cheng Chi and Shuran Song. 2021. Garmentnets: Category-level pose estimation for garment s via canonical space shape completion.
In Proceedings of the IEEE/CVF International Conference on Computer Vision. 3324–3333.
[59] Patrick John Chia, Giuseppe Atanasio, Federico Bianchi, Silvia Terragni, Ana Rita Magalhães,Diogo Goncalves, Ciro Greco, and
Jacopo Tagliabue. 2022. Contrastive language and vision learning of general fashion concepts. Sci entifc Reports 12, 1 (2022), 18958.
[60] Julian Chibane, Gerard Pons-Moll, et al. 2020. Neural unsigned distance felds for implicit funct ion learning. Advances in Neural
Information Processing Systems 33 (2020), 21638–21652.
[61] Seunghwan Choi, Sunghyun Park, Minsoo Lee, and Jaegul Choo. 2021. Viton-hd: High-resolu tion virtual try-on via misalignment-aware
normalization. In Proceedings of the IEEE/CVF conference on computer vision and patern recognit ion. 14131–14140.
[62] Eunsuk Chong, Chulwoo Han, and Frank C Park. 2017. Deep learning networks for stock mar ket analysis and prediction: Methodology,
data representations, and case studies. Expert Systems with Applications 83 (2017), 187–205.[63] Xiaoya Chong, Qing Li, Howard Leung, Qianhui Men, and Xianjin Chao. 2020. Hierarchical vis ual-aware minimax ranking based on
co-purchase data for personalized recommendation. In Proceedings of Te Web Conference 2020.2563–2569.
[64] Zheng Chong, Xujie Zhang, Fuwei Zhao, Zhenyu Xie, and Xiaodan Liang. 2023. Fashion Matri x: Editing Photos by Just Talking. arXiv
preprint arXiv:2307.13240 (2023).
[65] Ayush Chopra, Rishabh Jain, Mayur Hemani, and Balaji Krishnamurthy. 2021. Zfow: Gated appearance fow-based virtual try-on with 3d priors. In Proceedings of the IEEE/CVF International Conference on Computer Vision. 5433–5442.
[66] Chien-Lung Chou, Chieh-Yun Chen, Chia-Wei Hsieh, Hong-Han Shuai, Jiaying Liu, and Wen-Huang Cheng. 2021. Template-free try-on image synthesis via semantic-guided optimization. IEEE Transactions on Neural Networks and Learning Systems 33, 9 (2021), 4584–4597.
[67] CMU Graphics Lab. [n. d.]. CMU Graphics Lab Motion Capture Database. http://mocap.cs.cmu.edu/.
[68] McKinsey Company. 2023. Generative AI: Unlocking the Future of Fashion.
[69] Charles Corbiere, Hedi Ben-Younes, Alexandre Ramé, and Charles Ollion. 2017. Leveraging weakly annotated data for fashion image retrieval and label prediction. In Proceedings of the IEEE international conference on computer vision workshops. 2268–2274.
[70] Enric Corona, Guillem Alenyà, Antonio Gabas, and Carme Torras. 2018. Active garment recognition and target grasping point detection using deep learning. Patern Recognition 74 (Feb. 2018), 629–641. https://doi.org/10.1016/j.patcog.2017.09.042
[71] Enric Corona, Albert Pumarola, Guillem Alenya, Gerard Pons-Moll, and Francesc Moreno-Noguer. 2021. Smplicit: Topology-aware generative model for clothed people. In Proceedings of the IEEE/CVF conference on computer vision and patern recognition. 11875–11885.
[72] Giuseppe Craparota, Sébastien Tomassey, and Amedeo Biolati. 2019. A siamese neural network application for sales forecasting of new fashion products using heterogeneous data. International Journal of Computational Intelligence Systems 12, 2 (2019), 1537–1546.
[73] Guillem Cucurull, Perouz Taslakian, and David Vazquez. 2019. Context-aware visual compatibility prediction. In Proceedings of the IEEE/CVF conference on computer vision and patern recognition. 12617–12626.