经过与从业者的交流和论文通读,结合自己的行业经验,把近期的思考做个总结。全文约5000字(深度阅读需20分钟,慎入),附录3000字(2024年虚拟试穿主要论文发布年鉴)
Part 1 ——从3D建模到生成对抗网络和扩散模型,简单回顾被GenAI(生成式人工智能)重新定义Virtual Try-on。
Part 2—— 开发虚拟试穿的技术人员,可能并不理解真正的时尚。消费者不满意的背后,真正的原因是什么?
Part 3—— 虽然模型的能力和计算成本依然存在障碍,但是虚拟试穿技术有望一年内实现商业化。分享几个免费试用的模型,以及我的测试结果(视频)。
附录:2024年扩散模型虚拟试穿的发展情况
我还是会怀念过去只能在实体店购买衣服的日子,亲手揣摩面料,亲眼分辨色彩和图案,更重要的是我并不那么信任标识,对于不同的设计和裁剪,亲身试一试偏离自己标准的尺码,也是造型的乐趣。尽管不是每家店的试衣间都可以享受到“尊贵”的体验,但能有一大堆衣服试穿这件事本身,可以说也是shopping不可缺少的体验,它满足了我们对自己身体与陌生风格的探索。如果这种体验还伴随着与同行好友和专业导购的社交闲聊,它就不只是简单的购物了。
我希望这样的购物方式能够复兴,不仅仅因为它是值得归还给消费者的美好体验,还因为这段拉长的“旅程”,能够繁荣生态的多样性,从而提高产业的抗风险能力。
但我不会因此反对虚拟试衣,科技进步带来生产和生活方式的革命,Virtual Try-on能够丰富线上线下的购物体验,而且我也相信,创新技术能够复制,甚至提高过去我们在实体店试衣间的乐趣。我想这也是虚拟试穿技术应该追求的方向。
PART1 | 虚拟试穿发展的回顾
虚拟试衣不是新鲜概念。在2016年“新零售”这个概念被提出来时,如何使用各种新技术提升消费者线上线下的体验,从而提高销售转化利率,成为零售商们的共识。那时,得益于游戏产业3D建模技术高速迭代,包括AR/VR 浪潮的兴起,市面上出现了大批虚拟试穿解决方案。大多采用摄像头和AR设备,从评估一条牛仔裤的合身度到测试脸上口红色号的颜色,虚拟试穿提高了购物的便利性。
事实证明,这些方法具有一定效果,将产品图像转换为 3D ,建立目标图像和纹理贴图之间的准确对应关系并实时渲染。它们努力实现物理真实感和多样性水平,在美妆、配饰,甚至家居产品方面表现突出,但碰到更为复杂的服装,面临着推理失真和计算时间较长的问题。在十亿种产品目录上,要求每款衣服具备 3D 数字孪生资产也是不现实的。服装试穿对于渲染效果显然也远远高于游戏玩家,恐怖谷效应让多数消费者和品牌公司退而却步。
能力和成本都没有到达应用标准,这样的技术迟迟无法大面积商业化落地,很多虚拟试衣项目销声匿迹了。
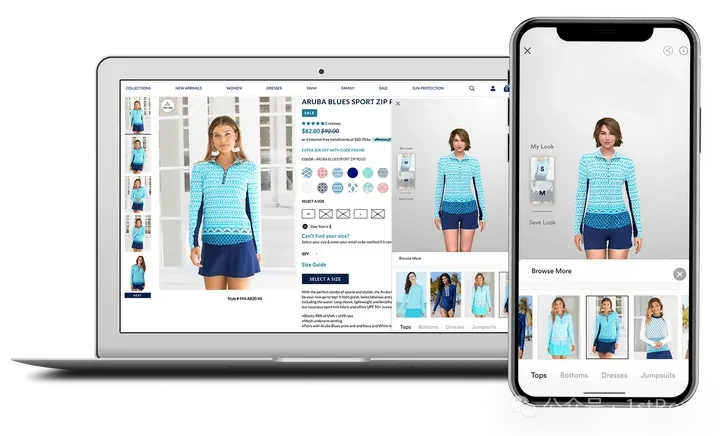
随着元宇宙概念的炒作,叠加疫情对消费场景的影响,重新点燃了这一需求,越来越多的技术公司和零售平台相继加快自己在虚拟试衣技术上的布局。随着GenAI(生成式人工智能)的发展,在2020年到2022年这段时间,虚拟试衣技术采纳深度学习方法,通过卷积神经网络 (CNN) 检测和分割不同的身体部位,利用基于流的生成对抗网络(GAN),训练从 2D 图像模拟产品的精确 3D 效果。
VITON 就 是 采 用 这 种 技 术 的 典 型 例 子 。 开 源 的 VITON-HD ( 论 文 地 址https://arxiv.org/abs/2103.16874)高分辨率数据,对于此后能够训练合成高质量图像的虚拟试穿模型具有重要的推动作用。得以快速生成照片级逼真的内容,使零售商能够在不同的环境和情境中可视化产品。对于最终用户来说,可以以浏览器应用程序、移动应用程序甚至实体商店中的数字屏幕的形式体验虚拟试穿。
这些早期方法通常涉及两步过程。首先,使用精确的变形( warping )模块来调整服装商品的形状,以匹配所需的轮廓。随后,部署 GAN 驱动的生成器,将重塑的服装集成到目标模特图像上。基于 GAN 的方法,只能试穿单件服饰,而且在很大程度上取决于初始 warping阶段的拟合程度,同时GAN 生成的图像质量也并不令人满意。
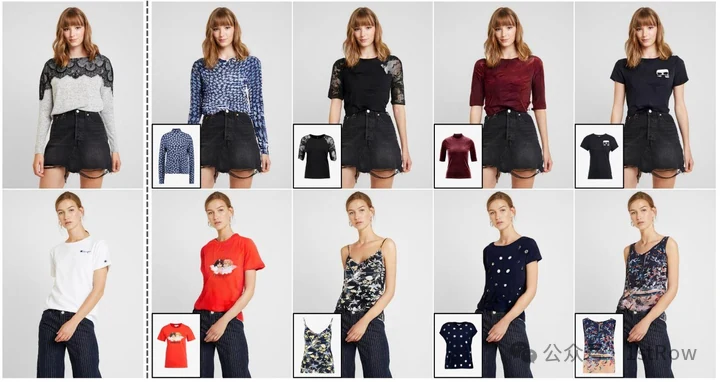
VITON-HD展示的效果
2022年的上半年,迎来了扩散模型(Diffusion)的第一个出圈震撼:OpenAI的DALLE-2横空出世,至年底,Stable Diffusion开源公布,扩散模型在大众层面真正开启了图像领域的AIGC时代。扩散模型被认为能掌握 3D 世界的细微差别,生成一定程度模拟3D的几何和物理意识。它被引入到虚拟试衣技术中,使得效果大大提升,尤其是在试穿的真实感、贴合度和光影效果方面。
时间来到2023 年 6 月 ,谷歌迈出了大胆的一步,发布了 TryonDiffusion(论文地址https://arxiv.org/abs/2306.08276 )。和华盛顿大学共同开发的这一项目是首款全部利用扩散模型的技术方案,通过两个UNet(一种深度学习模型)的结合,创造了一个名为Parallel-UNet的架构。放弃服装warping 模块,巧妙地处理了严重的遮挡、各种姿势和身体轮廓的变化,以高分辨率的清晰度,细致地保留了服装的细节。这一创新标志着与传统方法GAN的重大背离,为此后虚拟试穿方案奠定了路基。
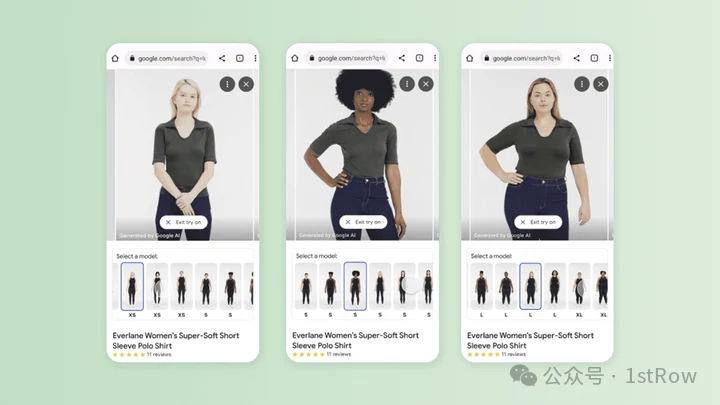
Google TryonDiffusion
同 时 期 , 来 自 意 大 利 团 队 的 LADI-VTON ( 2023 年 5 月 论 文 地 址https://arxiv.org/abs/2305.13501 )利用反推组件,将服装视觉特征映射到 CLIP 标记嵌 入 空 间 ; 中 国 交 通 大 学 的 DCI-VTON ( 2023 年 8 月 论 文 地 址https://arxiv.org/abs/2308.06101 )将变形的衣服与与衣服无关的人物图像相结合,并添加噪声作为扩散模型的输入;以及韩国团队的StableVITON(2023年12月 论文地址https://arxiv.org/abs/2312.01725)采用以未变形的服装为条件的 ControlNet 模型进行试穿;都是为了弥合传统基于 GAN 的方法与扩散模型之间的差距,利用扩散模型将warping 模块生成变形的服装与参考模特的图像无缝集成。
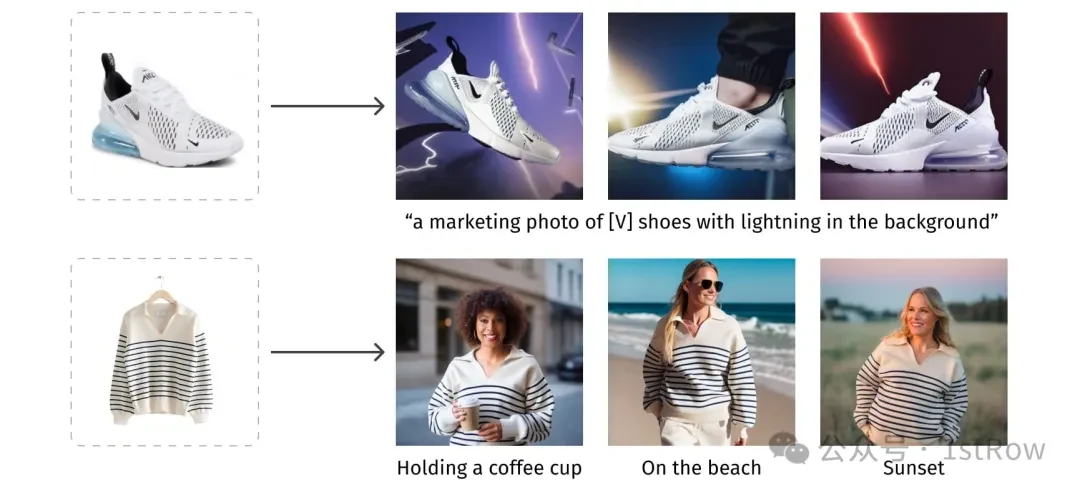
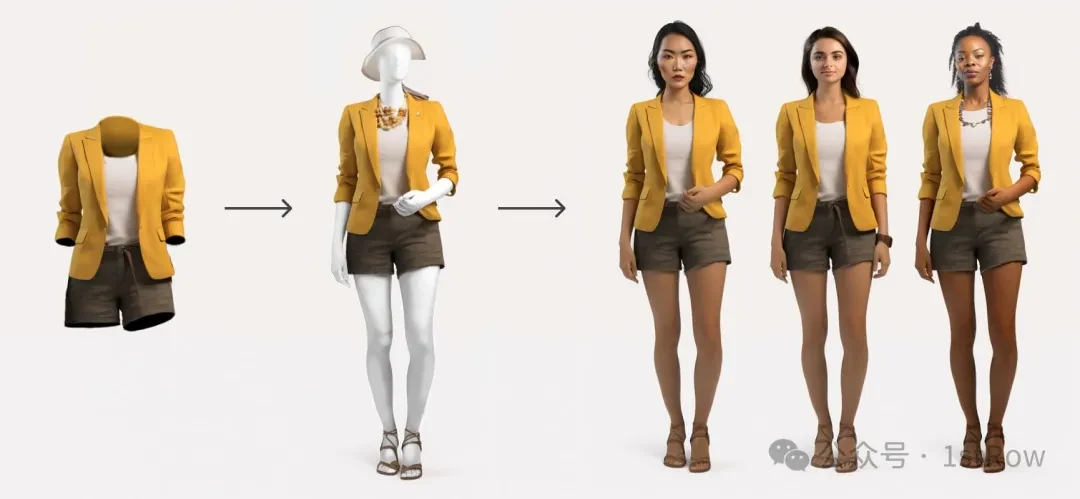
虚拟试穿技术也可用于加快品牌营销内容的创建速度
PART2 | 开发虚拟试穿的技术人员,可能并不理解真正的时尚
对于一般消费者,试穿解决尺寸合体的风险。然而,当我们一旦离开售卖大众服装的商超体系,以及走基础款路线的一些快时尚连锁,转到“时尚Style”这个语境下,对试穿的定义也许就会有所不同。带有设计感的时尚服饰,不仅仅是关于身高三围的简单数字问题。
“In Style”的个性化需求超越了合身性,甚至有时会刻意“牺牲”合身性。它同时跟每款设计的美学意图,材料、颜色、廓形的综合表现,以及消费者对该设计的理解都息息相关。电商的发展促使厂商已经努力在使用统一标准的尺码系统,但在不同地区,不同品牌,甚至同一品牌不同系列之间,还是普遍存在尺码偏差。然而,对于设计和美学要求高的消费者来说,“高模拟度的尺寸”可能只是一个伪需求,或者说不是提高转化率的核心节点。
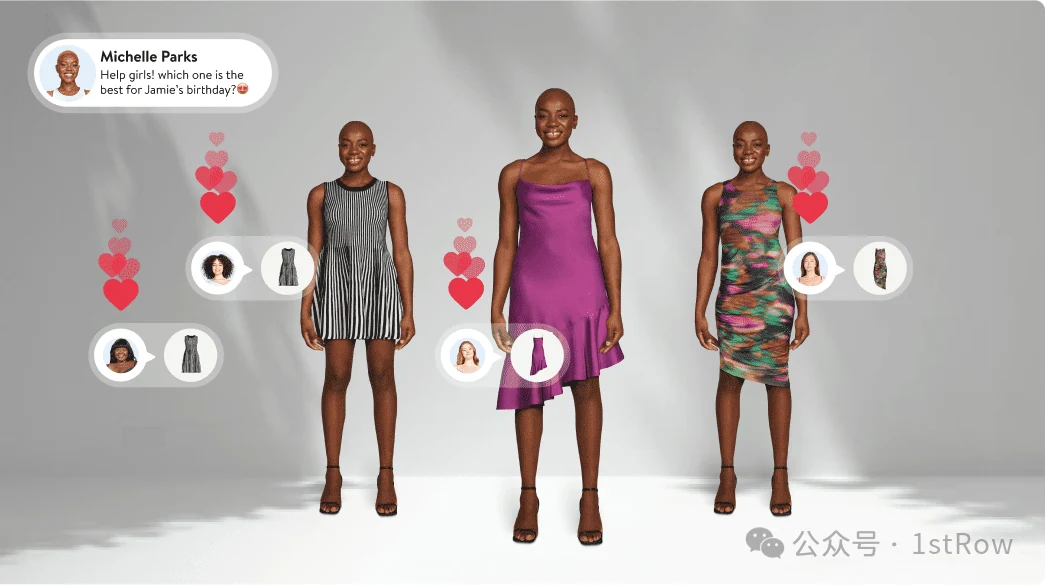
2024年9月沃尔玛Shop with Friends 虚拟试衣间已推出自有品牌 Scoop 的秋季时装专注尺码的技术公司开发者也许忽视了一个真实的“难题”。追求时尚的女性消费者,绝大多数时候不是只穿单件,而且也总是层层叠叠(Layer)。Style 的核心是关于Mix &Match,购买决策很大程度上取决于如何搭配,甚至妆容、发型和环境都会带来影响。另外,我们也几乎很少穿一个品牌的total look,但不同品牌间的跨店搭配效果实现难度高,存在很多复杂的问题,比如不同厂牌之间的数据壁垒。
“Complete the Look” 是消费者非常现实的需求,也是当下线上线下普遍被零售商采纳的销售策略:通过推荐与客户已购买单品相匹配的互补商品来提升销售额。传统电商上,这些推荐会作为单独的商品显示在清单上,无法完全传达这些商品搭配在一起时的外观。通过生成式人工智能可以创建结合不同推荐产品的虚拟试穿逼真图像。视觉丰富的演示让顾客可以在现实生活中想象完整的服装,从而对决策产生积极影响。
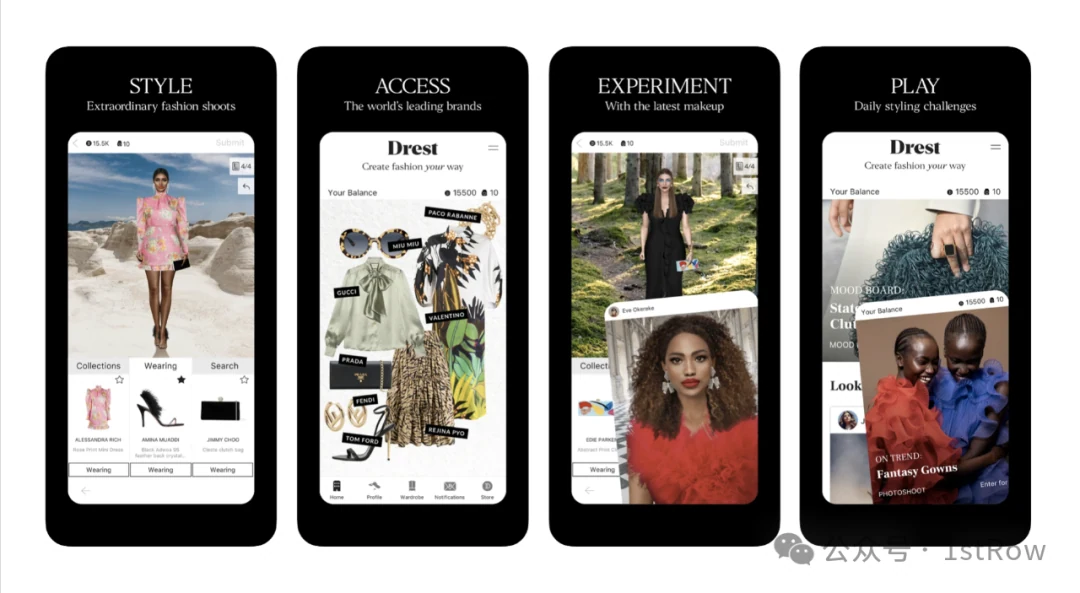
退货最大的原因是消费者脑中幻象与真实上身效果之间的偏差。“试衣效果”不是理性算法的结果,更多是预期管理。有线下零售店导购经验的朋友一定能理解这一点。过去科技公司穷尽其力去模拟真实的物理世界,但他们没有意识到消费者需要的只是看到那个幻象的“实际呈现”——几张她们可以在社交媒体分享的OOTD照片。
现在,基于扩散模型的技术路线,被认为无法避免的GenAI 幻觉问题最常被诟病。在试穿场景中扩散模型几乎只关注可视化效果,会不会反而成为创造消费者幻象的魔法棒?时尚,等于造梦,不是吗?与 3D 模型相比,GenAI 可在各种情况下提供更出色的高质量可视化效果。
尺寸问题短期内都不能不被AI完美解决,但使用更好的用户身材数据收集系统,结合各品牌私有技术包数据以及面料类型和拉伸规格等公共数据,为用户直接分配一个合适的尺码就可以,不需要可视化。在美国的一项调查数据显示,虚拟试穿最有帮助的三大用途尺寸排在最末,分别是“我可以看到款式是否适合我”(63%)、“我可以看到颜色是否适合我”(51%)和“我可以准确了解衣服的尺寸”(46%)。
尤其在中国这个奇特的电商环境下,离谱的女装80%退货率中,有多少是因为最容易拿来顶包的“尺码不合适”造成的呢?这里不讨论普遍存在的“虚荣尺码”,所谓“货不对版”,排除商家自己的版型和质量问题,这句话背后真正的心理是“这件衣服穿起来让我感觉不好”。这里提到的“感觉”,是模糊和抽象的幻觉。
PART3 | 虽然……,但是虚拟试穿技术有望一年内实现商业化
自从谷歌推出了Tryon Diffusion, 许多基于扩散模型的虚拟试穿证明了它们能够生成高质量和逼真的试穿图像,也落地了真实商业应用场景。但也正如Part2 指出的,当涉及到复杂试穿条件,以及消费者真正的试穿需求时,它们仍然面临着诸多挑战。
早期一些基于 GAN 的方法对“组合式试穿”进行了探索,采用循环生成模式实现顺序试穿。然而,当穿衣结果完全由试穿顺序决定时,对服装语义信息的理解不足,往往会导致结果不切实际,很难模拟组合试穿过程中每件服装的造型细微差别,例如上衣和下装之间、内衣和外衣之间的重叠关系。再比如,给定一张拉链外套的平铺服装图像,现有方法很难主控拉链开合的不同穿搭方式。
此外,很多扩散模型亦缺乏精确识别试穿区域的能力,使得它高度依赖于分割模型的精度。这在摄影棚外复杂场景中,以及面对特殊设计的服饰时,结果更加不令人满意,从而在训练过程中引入额外的噪音,这又导致了服装穿着方式的信息丢失。总之,需要改进的问题还有很多,包括鞋帽珠宝腕表等配饰,以及如何实现视频中的试穿。
2024年开始,大量的团队在此基础上,不断完善扩散模型的应用。按时间轴,我阅读了几乎所有论文,梳理了一下百花齐放的后续解决方案。技术细节不再展开赘述,大家感兴趣可以文末附录中链接的论文,就看看最终展示的效果吧。另外可以发现,几乎所有涉及电商业务的国际大型平台公司和主要的大学机构都纷纷发布了自己的论文。值得注意的是:无论是国内还是国际团队中,都出现大量华人身影。
这些模型和解决方案本质上的差异并不大,在某些领域的特色并没有为整体效果带来巨大飞跃。但我相信随着数据增加和算力提升,虚拟试穿技术实现商业化应该就在一年之内。从大厂对该赛道的布局来看,热情不亚于视频生成领域。有望在2C市场上诞生千万级的DAU产品。尤其是在中国这样一个巨大的电商消费市场,无论是把它作为导购工具还是一个纯娱乐的产品。
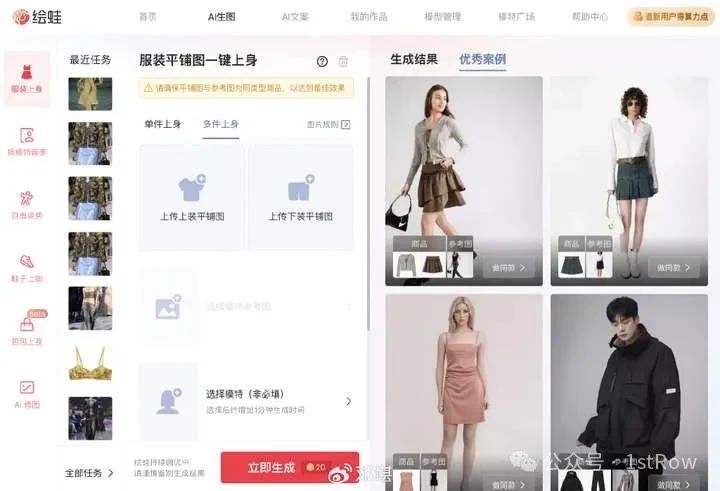
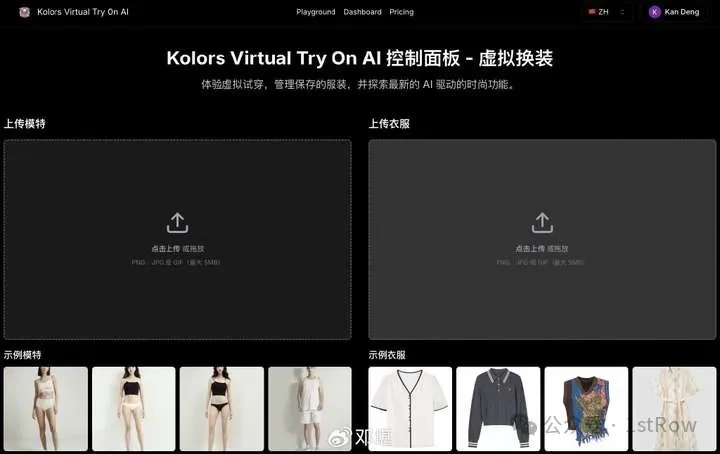
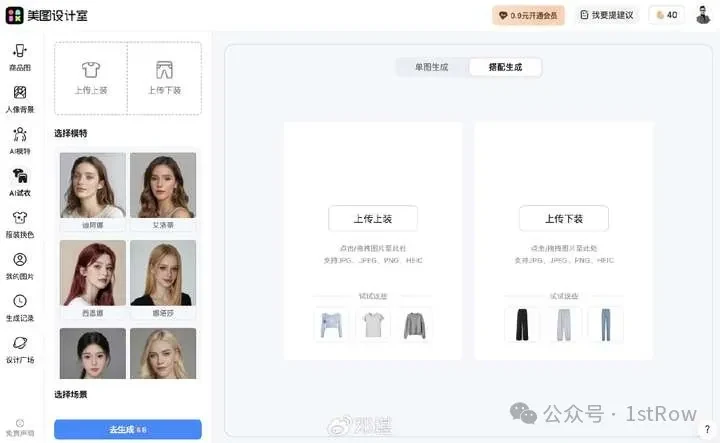
以下几款代表性产品供大家体验,它们都是把以上技术封装后推向市场的WebUI产品。我们测试了T台同款服装的实物搭配,并结合其他数字人、图生视频、文字语音等AIGC技术制作,模拟了一支时尚博主的穿搭视频。希望跟大家在评论区讨论试用效果。
邓堪 4
阿里_绘蛙AI_AI电商营销内容创作平台
快手_Kolors 虚拟换装
https://virtualtryon.net/zh/playground
美图-免费设计平面设计编辑软件
附录:2024年扩散模型虚拟试穿的发展情况
2024 年 1 月 24 日
(点击阅读论文 https://arxiv.org/abs/2401.13795v1)
Diffuse to Choose
亚马逊 / 即将开源
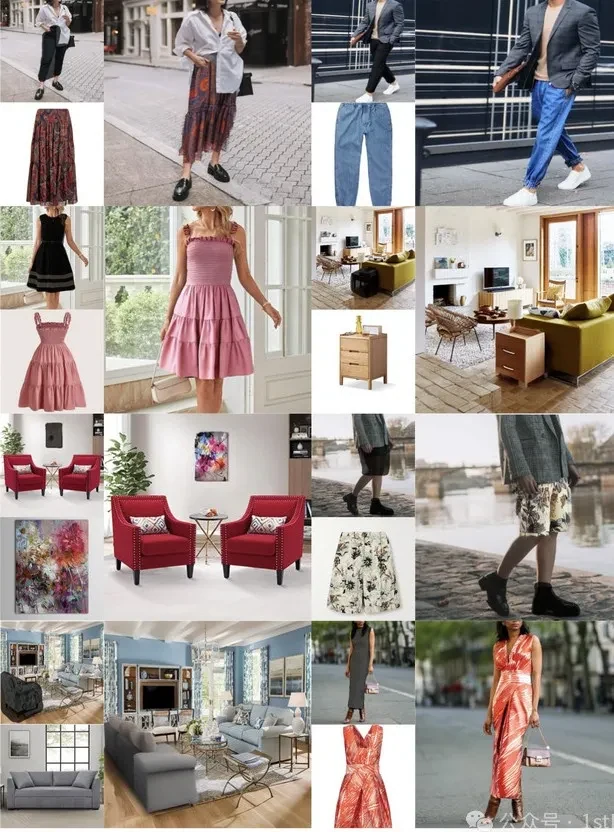
DTC是一种新颖的潜在扩散修复模型。为了在推理过程中处理任意遮罩形状(非预定义姿势的专业人体模型图像)和野外(非摄影棚内自然环境)示例,实现了一种掩码增强技术。将参考产品与周围环境和谐地融合在一起,同时保持产品的身份(不使用来自相似类别的产品的通用图像替换产品),且能够执行快速推理以促进数十亿产品和数百万用户的实时使用。
Diffuse to Choose
2024 年 3 月 4 日
(点击阅读论文 https://arxiv.org/abs/2403.01779)
OOTDiffusion
小i机器人 / 已开源
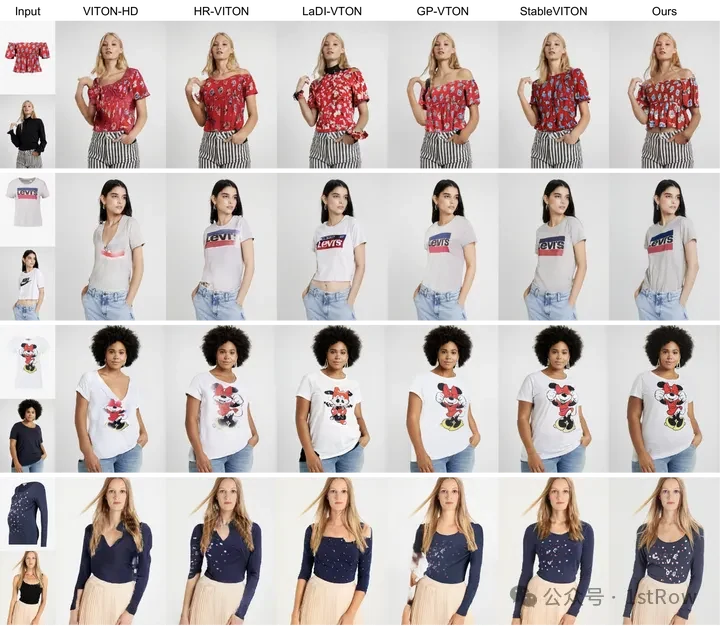
利用预训练潜在扩散模型,设计了一个服装 UNet 来学习服装细节特征。运用CLIP 对上身、下身、全身试穿应用的服装标签进行编码,提高系统的精确度和适应性。无需多余的扭曲过程,通过去噪 UNet 的自注意层中提出的服装融合,服装特征与目标人体精确对齐。在训练过程中引入了服装 dropout,能够通过无分类器的指导来调整服装特征的强度。4月发布的Magic Clothing 是OOTDiffusion的一个分支版本,专注于可控的服装驱动图像合成。开放测试:
https://huggingface.co/spaces/levihsu/OOTDiffusion and https://ootd.ibot.cn/
OOTDiffusion
2024 年 3 月 8 日
(点击阅读论文https://arxiv.org/abs/2403.05139 )
IDM-VTON
韩国科学技术研究院 / 已开源
基于样本的修复扩散模型进行虚拟试穿,无法精确保留服装的身份。IDM-VTON,使用两个不同的模块来编码服装图像的语义;给定扩散模型的基础 UNet,先从视觉编码器中提取的高级语义与交叉注意层融合,然后 从并行 UNet 中提取的低级特征与自注意层融合。此外,为服装和人物图像提供了详细的文本提示,以增强生成的视觉效果的真实性。开放测试:https://huggingface.co/spaces/yisol/IDM-VTON
IDM-VTON
2024 年 3 月 12 日
(点击阅读论文https://arxiv.org/abs/2403.07371 )
FIP-VITON
韩国科学技术研究院
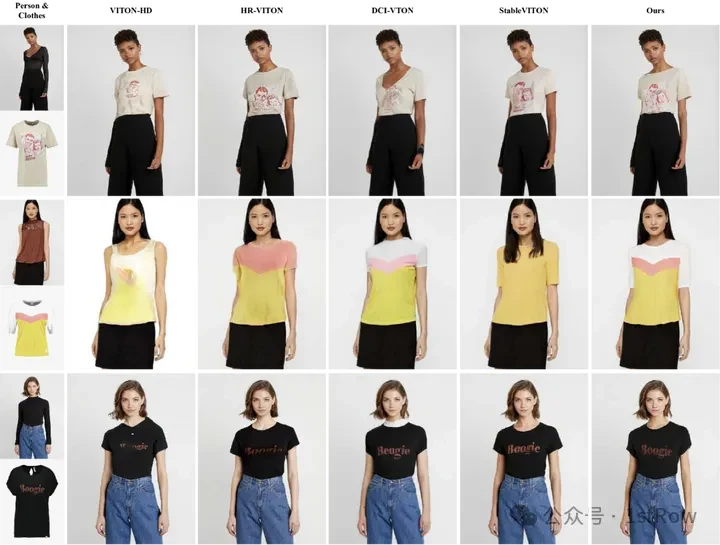
试图解决虚拟试穿期间服装纹理保存和用户特征保留的问题。所提出的网络包括两个主要模块 :一个将服装与个人特征对齐的扭曲模块和一个试穿模块,可以细化服装并生成缺失部分,并集成了遮罩感知后处理技术,确保个人身份的完整性。它展示了令人印象深刻的结果,推理速度比其他已有方案快了近 20 倍,定性评估中保真度极高。
FIP-VITON 2024 年 3 月 19 日
(点击阅读论文https://arxiv.org/abs/2403.12965 )
Wear-Any-Way
阿里巴巴
除了生成高保真结果外,还支持用户精确管理穿着风格。支持复杂场景中的单件/多件服装,以及模特到模特的试穿。为了使其可操作,提出了稀疏对应对齐,它涉及基于点的控制来指导特定位置的生成,提供了一种用于定制穿着风格的新颖交互形式。例如,它支持用户拖动袖子使其卷起,拖动外套使其打开,并利用点来控制上衣塞入下装的样式等。
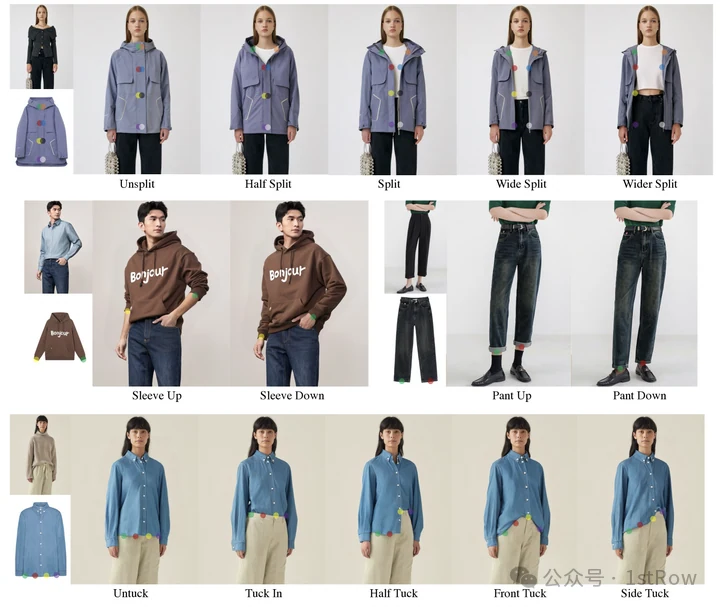
Wear-Any-Way
2024 年 4 月 22 日
(点击阅读论文 https://arxiv.org/abs/2404.14162)
FLDM-VTON
复旦大学
在三个主要方面改进了传统的潜在扩散过程。首先,将扭曲的衣服作为起点和局部条件,为模型提供忠实的服装先验。其次,引入了一种新颖的服装展平网络来约束生成的试穿图像,提供与服装一致的忠实监督。第三,设计了一种服装后验采样以进行忠实推理,进一步提高了模型相对于传统与服装无关的高斯采样的性能。
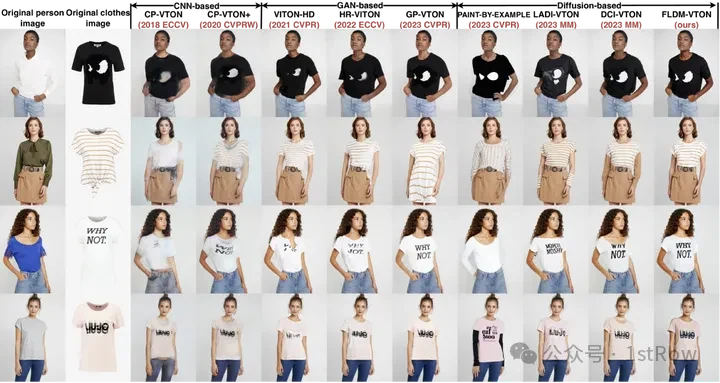
FLDM-VTON
2024 年 4月 26 日
(点击阅读论文https://arxiv.org/abs/2404.17571 )
Tunnel Try-on
阿里巴巴,华中科技大学
为了保持了服装的细节,合成平滑的视频,在输入视频中挖掘一个“焦点隧道”,提供围绕服装区域的特写镜头,以更好地保留服装的细节。为了生成连贯的动作, 首先利用卡尔曼滤波器构建了平滑的裁剪,并将隧道的位置嵌入注入到注意力层中,以提高生成视频的连贯性。还开发了一个环境编码器来提取隧道外的背景信息作为辅助线索。
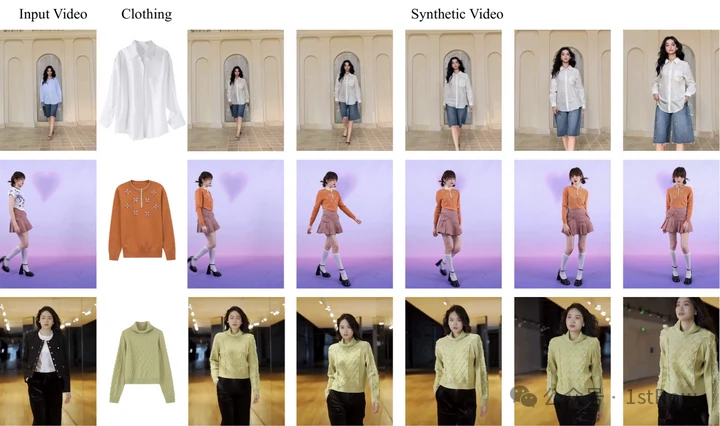
Tunnel Try-on
2024 年 4 月 26 日
(点击阅读论文 https://arxiv.org/abs/2404.17364)
MV-VTON
哈尔滨工业大学、北京大学 / 已开源
多视图虚拟试穿 ,使用给定的服装从多个视图重建穿衣结果。使用服装的正面和背面视图,提出了一种视图自适应选择方法,其中硬选择和软选择分别应用于全局和局部服装特征提取,确保服装特征大致符合人的视角。使用联合注意力模块来对齐和融合服装特征与人物特征。此外,收集了一个数据集 MVG,其中每个人都有多张具有不同视角和姿势的照片。
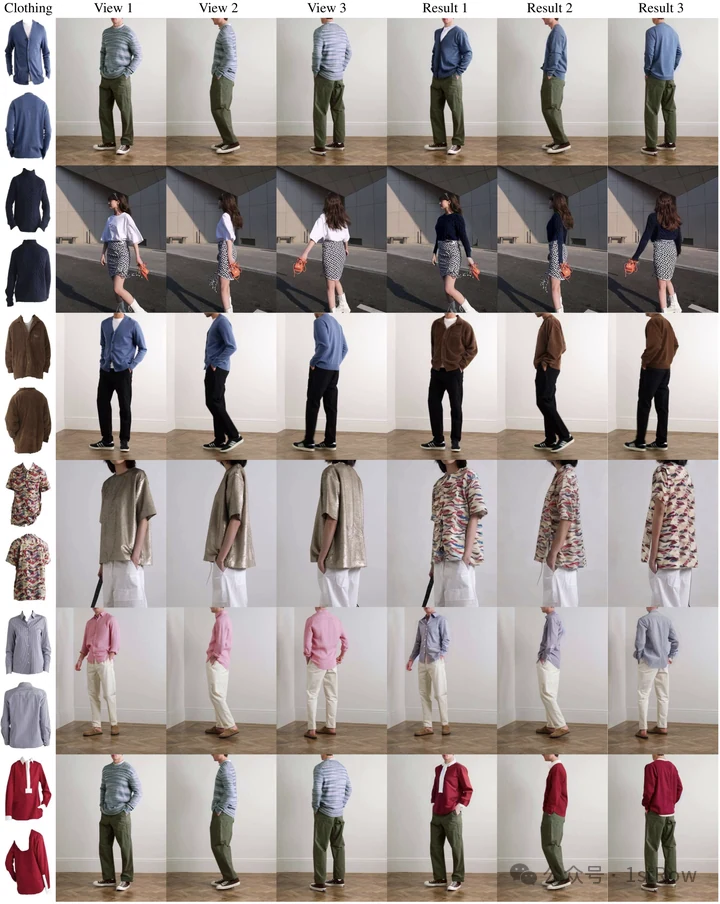
MV-VTON
2024 年 5 月 1 日
(点击阅读论文https://arxiv.org/abs/2405.00448 )
MMTryon
字节跳动,中山大学,清华大学
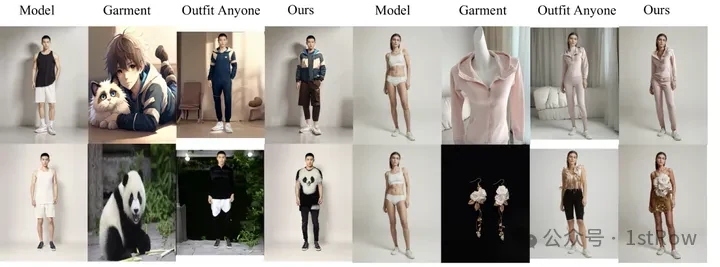
一种多模态多参考虚拟试穿框架,可以通过将文本指令和多张参考服装图像的信息结合起来,生成高质量的组合试穿结果。使用无需解析的服装编码器,并利用可扩展数据生成管道将现有的 VITON 数据集,转换为允许进行训练而无需任何明确分割的形式。这种复杂的策略有助于进行更精准和多样化的互动(例如拉合/开拉链、上装塞进/拉出等)。
MMTryon
2024 年 5 月 28 日
(点击阅读论文 https://arxiv.org/abs/2405.18172)
AnyFit
阿里巴巴,上海交通大学
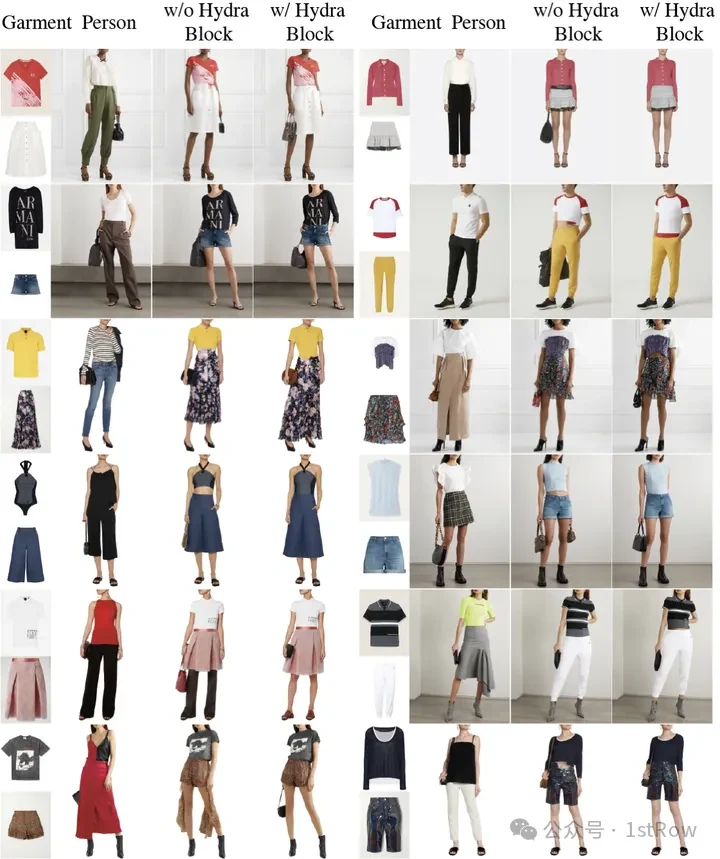
主要由两个同构的U-Nets组成,分别是HydraNet和MainNet,前者负责提取细粒度的服装特征,后者负责生成试穿图像。通过并行注意机制,有助于将多件服装的特征从条件编码分支注入主网络。通过合成多个模型的残差来发展其在不同设置中的潜力,还引入了自适应遮罩增强功能,以进一步增强服装的贴合度。它允许模型自主理解服装的整体形状,从而使模型摆脱了之前对服装遮罩提示的依赖。
AnyFit
2024 年 6 月 4 日
(点击阅读论文https://arxiv.org/abs/2406.02184 )
GraVITON
印度理工学院
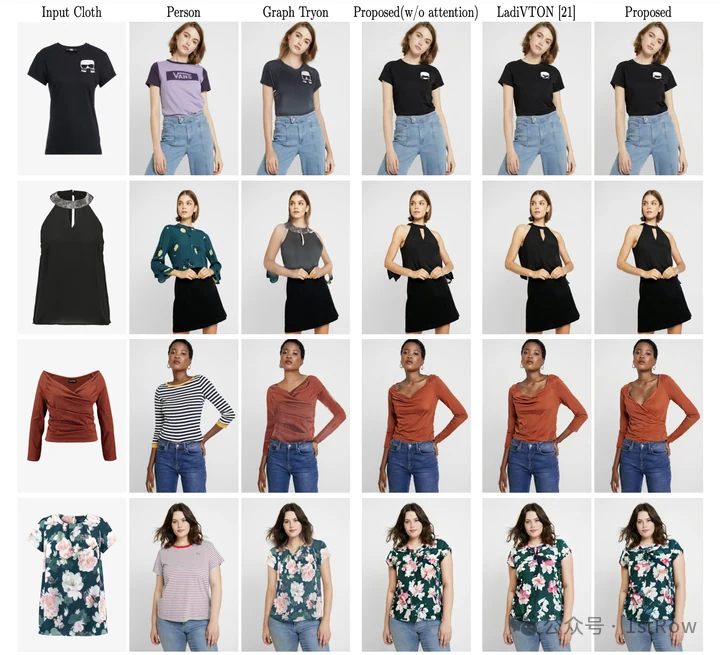
引入了基于图形的流变形模块 (GFW),该模块通过向源图和参考服装提供像素邻域背景来指导流变形。从而大大降低了服装模糊变形的不确定性,团队自称是第一个引入基于图形的服装变形技术的方案。提出了遮挡感知扭曲损失 (OWL),以便在真实服装出现自我遮挡的情况下实现完整的扭曲服装学习。
GraVITON
2024 年 7 月 15 日
(点击阅读论文 https://arxiv.org/abs/2407.10625)
WildVidFit
中山大学
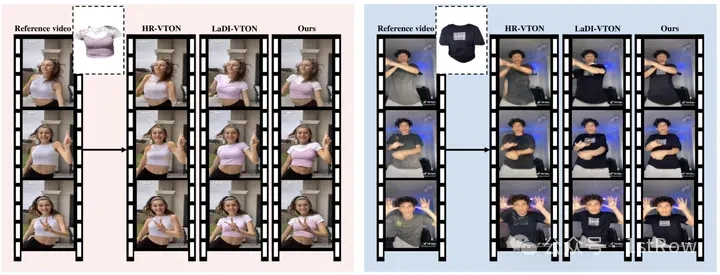
通过基于图像的控制扩散模型,在野外(非摄影棚的现实环境中)进行视频虚拟试穿。以特定的服装和人物为条件,在静态图像而不是视频上进行训练。它利用预训练模型的扩散指导,包括用于改善片段平滑度的视频蒙版自动编码器,和用于在潜在空间中对相邻帧进行特征对齐的自监督模型。这种集成显著提高了模型保持时间连贯性的能力。
WildVidFit
2024 年 7 月 17 日
(点击阅读论文 https://arxiv.org/abs/2407.12705)
IMAGDressing-v1
腾讯,南京理工大学,武汉理工大学,南京大学 / 已开源
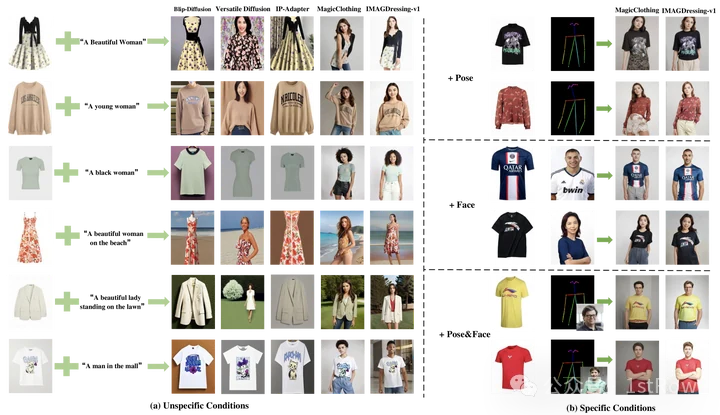
利用一个服装 UNet捕获来自 CLIP 的语义特征和来自 VAE 的纹理特征。提出了一个混合注意模块,包括冻结的自注意和可训练的交叉注意,将来自服装 UNet 的服装特征集成到冻结的去噪 UNet 中,确保用户可以通过文本控制不同的场景。它可以与其他扩展插件(如 ControlNet 和 IP-Adapter)结合使用,以增强生成图像的多样性和可控性。此外发布了交互式服装配对 (IGPair) 数据集,其中包含超过 300,000 对服装和着装图像,并建立了数据组装的标准管道。开放测试:
https://huggingface.co/spaces/feishen29/IMAGDressing-
v1 and https://sf.dictdoc.site/
IMAGDressing-v1
2024 年 7 月 21 日
(点击阅读论文https://arxiv.org/abs/2407.15886 )
CatVTON
美图,中山大学 / 已开源
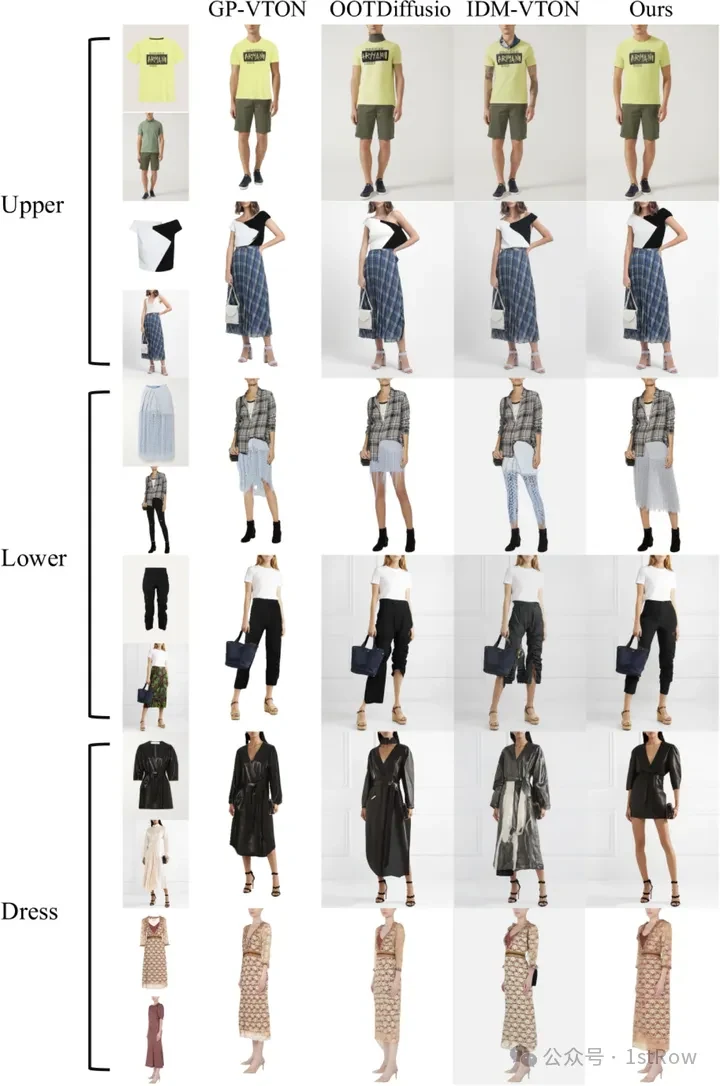
通过在输入上把人物、服装在通道维度拼接,在结构上摆脱了对额外的 ReferenceNet的依赖,跳过了对虚拟试衣来说没有显著帮助的文本交叉注意力,同时也不需要任何额外的图像编码器来辅助生成。从而克服了高训练和推理成本问题。通过 VAE 解码的图像可能会出现细节丢失和颜色差异,不准确的遮罩可能会严重降低结果。此外基于Stable Diffusion v1.5,预训练模型在包含NSFW内容的大规模数据集上进行,因此,可能会生成过于露骨的人像。开放测试:
https://huggingface.co/spaces/zhengchong/CatVTON and http://120.76.142.206:88 88/
CatVTON
2024 年 7 月 23 日
(点击阅读论文 https://arxiv.org/abs/2407.16224)
OutfitAnyone
阿里巴巴,中国科学技术大学
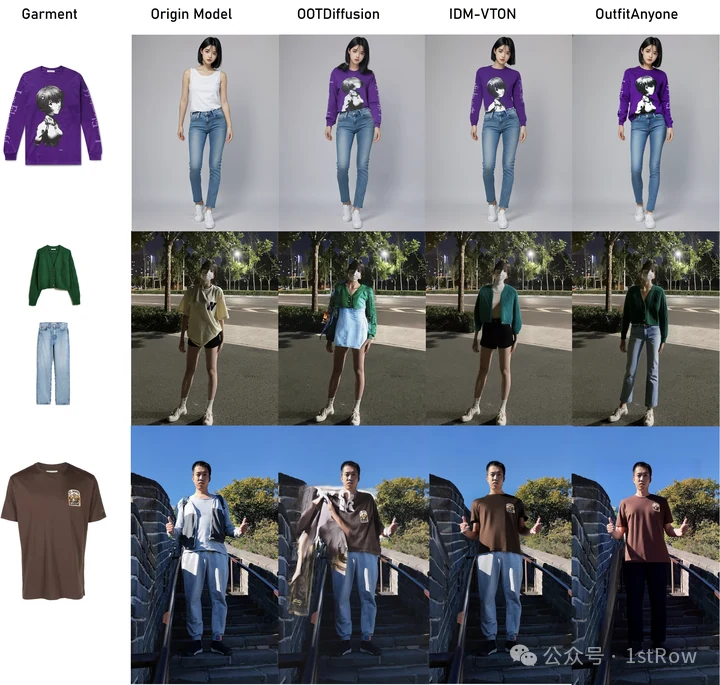
通过利用双流条件扩散模型,它可以细致地处理模特、服装和随附的文字提示的图像,使其能够熟练地处理服装变形以获得更逼真的效果。该架构分为两个不同的路径,独立处理模特和服装数据,最后合并在一个复杂的融合网络中。它包含两个关键组件:生成初始试穿视觉效果的零样本试穿网络,以及在最终输出图像中细化服装和皮肤肌理的后验 精 炼 器 。 开 放 测 试 :https://modelscope.cn/studios/DAMOXR/OutfitAnyone and https://huggingface.co/spaces/HumanAIGC/OutfitAnyone
OutfitAnyone
2024 年 8 月 12 日
(点击阅读论文 https://arxiv.org/abs/2408.06047)
BooW-VTON
阿里巴巴,天津大学
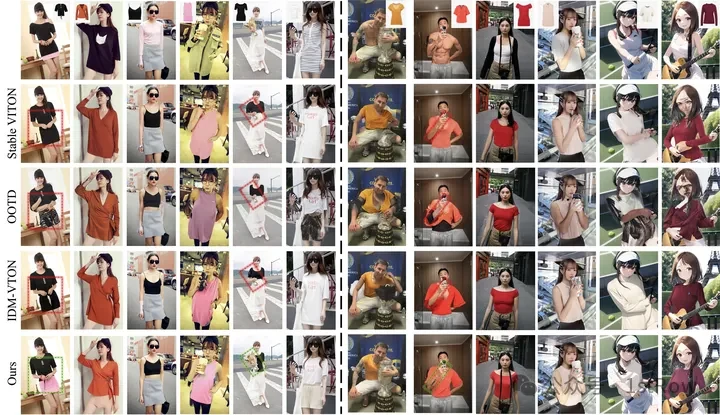
获取合适的遮罩蒙版对于扩散模型的试穿性能至关重要,该方案提出了一种新颖的训练范式,结合有效的数据增强方法,从野外场景中获取大规模未配对的训练数据,从而显著提高模型的试穿性能,而无需额外的修复蒙版。此外,试穿定位损失旨在定位更准确的试穿区域,以获得更合理的试穿结果。该方案只需要参考布料图像、源姿势图像和源人物图像作为输入。
BooW-VTON 2024 年 9 月 12
(点击阅读论文 https://arxiv.org/abs/2409.08258v1)
GarDiff
中国科学技术大学 / 已开源
模型在给定服装的基本视觉外观和详细纹理 (即高频细节) 的放大指导下触发以服装为中心的扩散过程。使用从参考服装的 CLIP 和 VAE 编码中得出的额外外观先验重塑预训练的潜在扩散模型。同时,以服装为中心的适配器被集成到扩散模型的 UNet 中,以追求与参考服装和人体姿势的视觉外观的局部细粒度对齐。专门设计了合成服装的外观损失,以增强关键的高频细节。
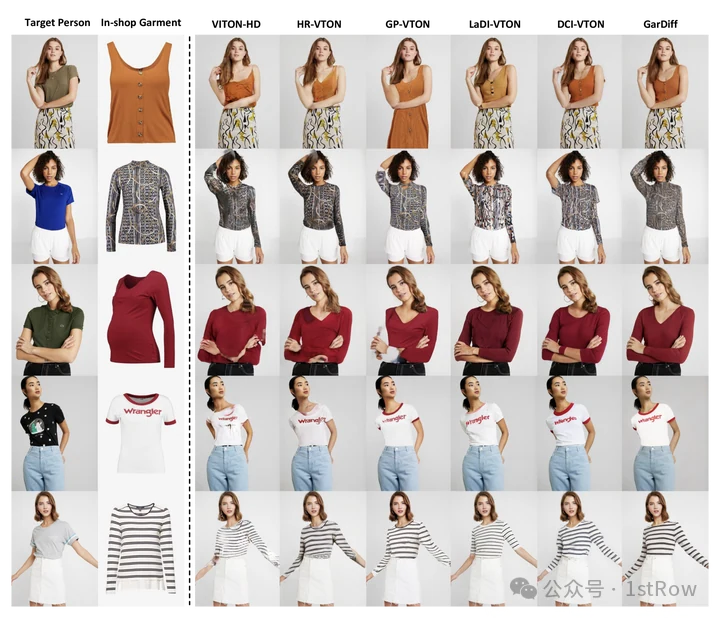
GarDiff
2024 年 9 月 22 日
(点击阅读论文 https://arxiv.org/abs/2409.14553)
GlamTry
斯坦福大学
是一种针对高端配饰的虚拟试穿技术,旨在解决在线零售环境中,消费者无法直接试戴珠宝、手表等配饰的问题。该研究使用特定于配饰的数据和网络架构,修改定制和重新训练了一个独特的模型。结果表明,与原始服装模型相比,即使使用较小的数据集,位置预测也得到了改进。
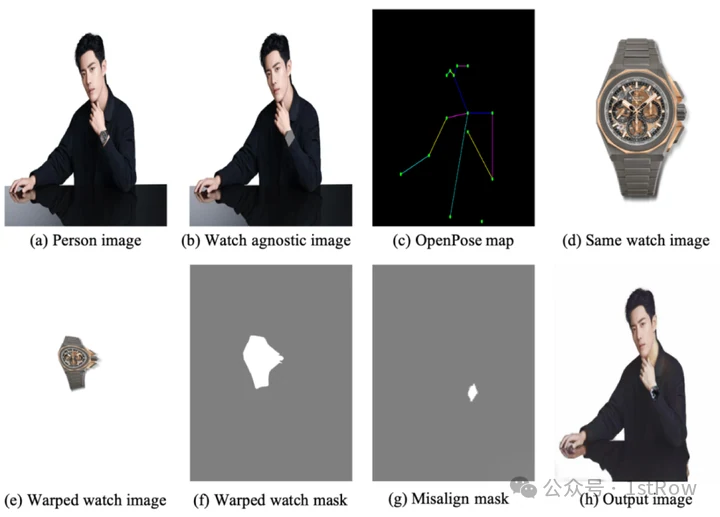
GlamTry