我为大家实测了当下“地表最强”视频模型的虚拟试衣能力,它们包括1⃣ 谷歌Veo 3.1、2⃣ 字节即梦Seedance 1.0、3⃣ MiniMax海螺*Hailuo 2.3、4⃣ 快手可灵 Kling 2.5、5⃣ 阿里通义*Wan 2.5、6⃣ 生数科技Vidu Q2。可以下滑跳过文字直接看测评视频。
【概述】 最近几个月,全球视频大模型的竞赛已经进入白热化阶段。从OpenAI的Sora2 到谷歌的Veo3.1,直到国产视频模型神仙打架,厂商们正不惜代价地“卷”向更长的生成时间、更强的物理模拟和令人惊叹的视觉真实感。这场AI生成视频的“狂欢”给所有行业带来了巨大的想象空间,时尚界也不例外。然而,当我们将目光从这些炫目的技术演示上移开,回归到时尚电商的真实业务场景(尤其是视频虚拟试穿)我们必须提出一个冷静的问题:这种对“视觉逼真”的极致追求,是否正在掩盖那个真正价值数十亿美元的商业痛点——退货?这篇笔记旨在穿透这场“狂欢”的迷雾,直指虚拟试穿的下半场。
除了卷“逼真度”,AI试衣的真正战场是“合身”与“合心”
我在10月的笔记生成式AI无法解决虚拟试衣尺码精准,难道回归最初的3D起点吗 谈到,2D技术在虚拟试穿场景中的不足,意味着该领域正向一个更高级的混合范式发展:3D几何建模和模拟技术负责提供尺寸、形状和合身度的“骨架”,确保物理和几何层面的准确性;生成式AI技术则负责填充视觉外观的“血肉”,提供照片级的真实感、丰富的细节和对复杂材质的表现力。
现在,我们对AI的幻想已经超越了基本的多模态,而是追求一个通用的“世界模型”。它是一个AI的 “想象力引擎” ,正试图不再仅仅学习像素的变化,而是学习更抽象的概念和实体,被称为懂得世界如何运作的模拟器。简单来说,就是让AI系统在头脑中“想象”或“预测”行动会带来什么后果,而无需在现实世界中一一尝试。回到我们虚拟试穿场景中,我们努力克服的挑战似乎迎刃而解。但是,从李飞飞教授团队上周发布的产品#Marble可以看出,这条路依然漫长。
理想化的3D物理引擎或者AI世界模型,研究的方法多样,仍都处于早期阶段。在当前思考AI落地应用,务实的路径主要还是生成式模型。我的「数字时尚 」专栏过去有很多篇幅讨论了基于2D图像的AI虚拟试穿,但静态的二维图像不足以提供逼真的虚拟试穿体验。要真正了解一件衣服,人们需要以各种方式与之互动——“织物动态”(fabric dynamics)。我们不难想象消费者的这种需求,谁没有在试衣镜前转身和摆动呢?虚拟试衣需要360度仿真,且展示出行动中自己独特的风范。更不必说当前“视频为王”的社交媒体环境,它天然契合了消费者的内容消费习惯。近年来,尽管关于视频试穿的研究不多,但仍有业界人员致力于将2D图像试穿的经验复制到视频领域。一种被普遍采用且直接的方法,是将AI图像生成技术暴力地应用于逐帧处理视频,这种方法常常导致明显的人物撕裂、服饰视觉瑕疵和帧间闪烁,以及处理长视频序列的庞大计算需求。大家普遍认为:复杂服饰主体、摄像机运动、动态场景和多样化角色风格等不受限制的场景下,现有方法难以准确模拟真实的服装精细细节和褶皱,自然的光影效果,并保持时序一致性。
读完十几篇近两年的论文(❗ 见文末Notes)后,我还发现一个不能忽视的问题。在以上共识之外,研究人员也许是缺少行业和用户调研,并没有搞明白在真实的试衣场景中,提高销售转化率不仅仅依靠单件衣服的试穿效果。在一些中高端实体店中,也许你也有过这样的体验,店员会建议(提供)目标单品之外的其他服饰来组合完成试衣。也就是说,服装这种特殊的商品,在完整的搭配中更能激发消费决策。
至于虚拟试衣尝试解决的退货,更是我反复强调的,如果不解决尺码精准性(较大的身体变形,毕竟多数人并不拥有模特般的身材),AI试衣变成了非刚需的娱乐,而不能解决真正的实用需求。所以非常遗憾,几乎所有主流虚拟试衣研究长期以来既不解决“合心”(Styling,“满意度与转化”问题),也不解决“合身”(Sizing,“退换货与物流”问题)。这使其陷入了“功能”的尴尬境地——它既不是一个鼓舞人心的“营销工具”,也不是一个高效精确的“运营工具”。
尽管问题重重,仍应基于现实评估VVT
多模态时尚理解不仅涉及文本和视觉数据,还包括音频、视频和3D模型。这在时装秀、广告和时尚单品穿着的场景中显而易见。这些元素传达了穿着者的个性和情感状态,基于视频的虚拟试穿(Video Virtual Try-On, VVT)是实现这一目标的最佳GenAI技术——尽管暂时还达不到“合心&合身”这一时尚电商的真正刚需。顾名思义,VVT是以数字化的方式让特定消费者穿上目标服装,生成一个高度逼真、连贯的视频。与充当“模拟物理学家”的世界模型不同,VVT是“视觉导演”,追求的是画面的流畅和美感。
随着我们从图像发展到视频,不仅增加了对计算资源的需求,也削弱了以往用于学习的大型数据库的可用性。其中确保跨模态的一致性至关重要,例如服装纹理的文本描述应与其视觉和触觉表示相匹配。此外,时尚单品通常带有无法直接从原始数据中观察到的情境和文化意义。整合这种级别的理解需要模型超越数据表示,进行抽象推理。根据不同管线,我把VVT模式大致分为以下3类。
1、通过单个用户形象(平面照片)和目标服装的参考信息(商品图),通过语言描述视频画面来生成一段视频。部分研究将试衣视频生成模型逐帧地变形,使空间错位的服装图像适应人物,这种端到端方法严重依赖于稀缺的成对服装数据集,且未能有效利用高级视觉模型的先验知识。我认为最佳的方案是借助生图模型的成熟能力,先生成人物多角度面部肖像和A Pose虚拟试衣图,以此作为参考输入。已有基础大模型上线了多参考图生视频模块,具备原生能力,可能导致这些专业模型的研究失去价值,变成#苦涩的教训。
2、语言条件反射无法有效捕捉长时间和细微的动作,于是,使用示例视频作为参考,来指导新视频的制作。即上传一段用户实拍视频和服装的参考信息,以自回归、逐段的方式生成用户穿着目标服装并执行指定动作的高质量、时长可达分钟级的试穿视频。将关键帧试穿与视频 LLM 推理相结合,为视频生成提供丰富的外观和运动信息。实现完全个性化的动态模拟一致性。但是在输入视频包含摄像机运动、动态背景或复杂的人体动作时,很难同时保持视觉保真度和运动一致性。
3、实时的视频试衣。我们曾经在AR中有过类似的体验,但AR对柔性服饰的表现非常拙劣。通过摄像头实时追踪人体,AR以几何变形的方式尝试让预制的3D服装模型"套"在用户身上,跟随人体运动而扭曲、拉伸。AI视频则能绕开了复杂、昂贵的物理模拟,从结果上直接追求视觉的真实感,但每一帧、每一个patch的生成都是一次昂贵的计算 ,这与AR的毫秒级响应相去甚远。想象一下未来如果在视频通话中实时更换服装,是不是最具吸引力的模式。
【中场竞技】视频大模型虚拟试衣能力考核
采用上文的第1类模式:通过单个用户形象(平面照片)和目标服装的参考信息(商品图),通过语言描述视频画面来生成一段视频。Input用户照片包括脸部肖像和全身身材照,服装图为成套(含层次)搭配的商品集合,难度系数较高。但对于评判来说,显然这比上次涉及主观审美,更抽象的AI智能搭配测评可以来得客观一些。测评目标模型包括:1⃣ 谷歌Veo 3.1、2⃣ 字节即梦Seedance 1.0、3⃣ MiniMax海螺*Hailuo 2.3、4⃣ 快手可灵 Kling 2.5、5⃣ 阿里通义*Wan 2.5、6⃣ 生数科技Vidu Q2。(因为OpenAI严格的内容隐私政策,无法采用“真人”图片,不参与本次测试)
比赛规则还是一样,相同的提示词,单次不抽卡。模拟试衣场景中普通消费者的通用指令,不做场景定制,故不考核模型的指令遵循、人物演技和运镜等专业能力。鉴于*号标记的模型只有首尾 帧 生 视 频 功 能 , 比 赛 分 两 轮 , 第 一 轮 直 接 采 用 V e o ,Seedance,Kling,Vidu视频模型的多参考图功能,第二轮全员入场,首先通过图生图输出首帧,然后再输入视频模型。在本次挑战赛中,让我们的百变数字人Jessy(身高166cm)以中等偏胖的形象出镜。生成式AI天然存在黑箱,所以是的,测试结果存在一定的随机性。
❗ 关注公众号,后台留言「VVT」自动获取本轮测试大模型提示词。
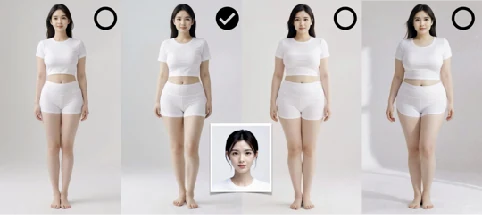
第一轮:秋冬造型(考察多层次搭配的理解能力和服饰一致性)
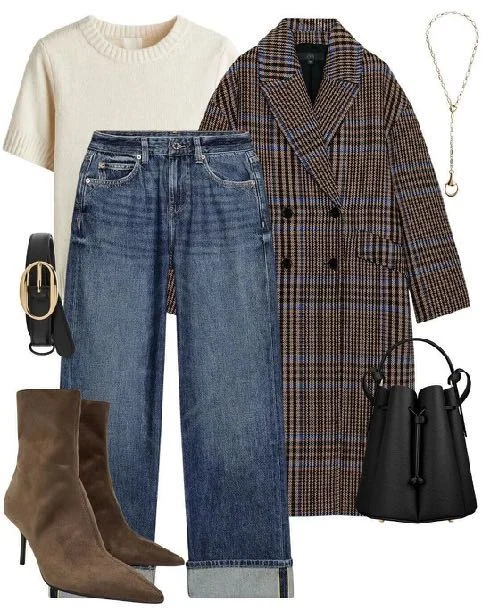
⬇ 新发的Vidu Q2表现惊喜。除了在牛仔裤版型和鞋面材质上有瑕疵,总体还原度很高。把人物放在户外环境中的策略也加分不少,训练用的数据集很接地气,但人物特征时序一致性还有待提高。
⬇ 自带声效和剪辑的Veo 3.1,只有fast版支持多图且只限16:9格式。尽管画风高级,但丢失了长外套的一致性,并“幻想”了一个假袖设计。由于隐私保护政策严格,无法迁移用户身份特征。
⬇ Seedance1.0只有mini版支持多图参考,同样丢失了外套和短靴的特征。在手袋环节大翻车,优点在于较好的保留了人物特征。
⬇ 目前Kling1.6支持多图参考,并可自由设置BGM。也许是算法聚焦了脸部特征,导致其他元素一致性几乎完全丧失了。
第二轮:沙滩造型(重点考察穿着方式理解和身型还原能力)
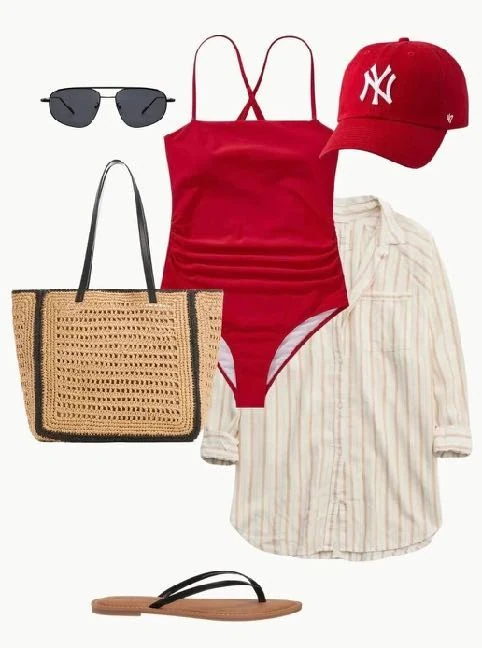
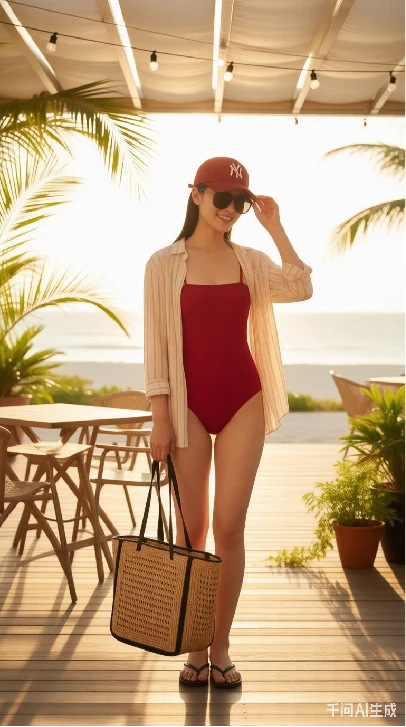
⬇ Seedream 4.0 + Seedance 1.0 Pro。由于Seedream系统默认每次输出多张图片,这里首帧图我做了次四选一。正如上次测试中它的生图表现:比较稳定。除了丢失眼镜,将泳装的背吊带放在了胸前,还自动做了“廋腿”美化。多数模型都忽视了身材多样性,存在过度美化(比如瘦身),这将关联严重的AI伦理问题,现象背后则意味着训练数据的非公平性。在Seedance的视频中,面部时序一致性降低,但沙滩留下脚印非常惊艳,体现了“世界模型”对行为结果的理解。
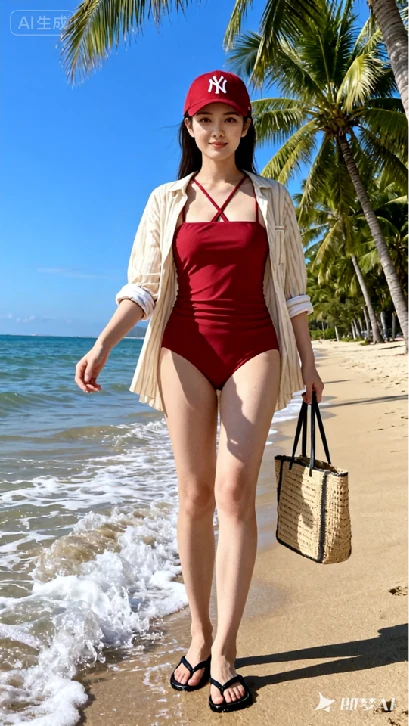
⬇ Nano Banana + Veo 3.1 Quality。生图中服饰还原度非常高,但谷歌逐渐加强了真人肖像限制,本例中,墨镜淡化了这个问题,此外较好地保留了人物丰满微胖的身型。但NB抢到的“得分”在后期Veo生视频时丢了:“神转身”中衬衫衣领前后状态不符,缺少对物理规律的理解。虽然运镜和氛围的确很美。
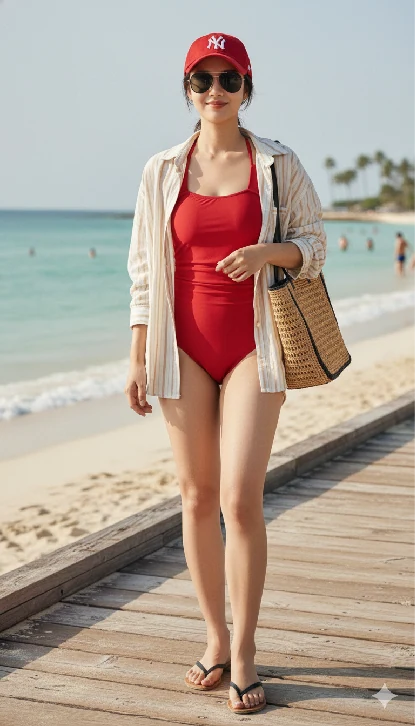
⬇ Qwen3 max image + Wan 2.5。生图环节中规中矩,虽然勉强将服饰一件不漏穿上了,但质感有形无神,AI味比较浓。而在视频环节力挽败局,人物动感和摄影运镜表现出色,BGM也恰到好处。如果把首帧图底子换成高质量图片,或成为本场MVP。
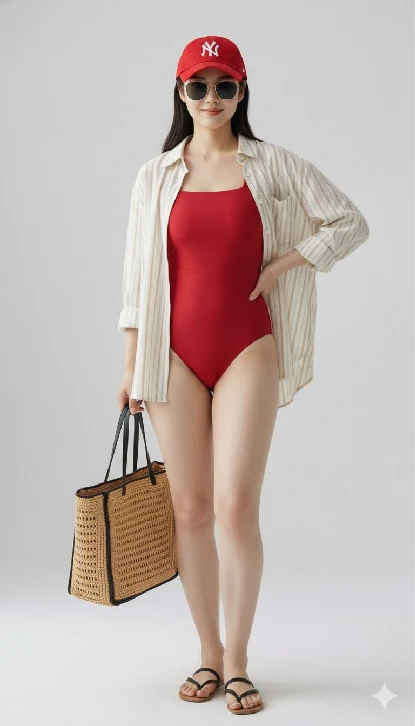
✅ 鉴于专注视频的Vidu,Kling,Hailuo在生图能力上的缺憾(无法实现多件单品的组合搭配试穿),我为它们的测试准备了一张Nano Banana生成的首帧参考图。在Nano Banana高质量体态还原度试衣图片基础上,以及墨镜遮挡之后,我们可以更聚焦在其他方面的表现。
⬇ Hailuo 2.3。侧脸时人物时序一致性丢失。
⬇ Vidu Q2。问题跟hailuo差不多,从帽子后脑的细节看,可能它对服饰的理解屡胜一筹。
⬇ Kling 2.5 Turbo。三款参与棚内展示的大模型中表现最佳,胜在不仅仅进入了“+音频”和“10秒”时代,更重要的是运动中服装的表现,比如泳装上的细微褶皱。(赛后我又用同样的模式测试了Wan 2.5,再次显示了后者强大的生成能力)。
✅ 各家大模型在首尾帧功能方面均表现出稳定的水准,并各自具备自己的特色。值得一提的是,AI视频这个赛道上,国产大模型实在是太给力了。本次测试,没有特别对背部有独特设计的服饰展开研究,但可以确定的是,在“多参考图”模式中,前期如果能提供每件单品正反面商品图(这在电商环境中普遍存在),或者如前文所述,先生成人物多角度面部肖像和A Pose虚拟试衣图作为输入,将能有效提高一致性。在首尾帧(或者智能多帧)模式中,如果在中间帧或者尾帧输入表现服饰背面的人物状态图,也能改善,但将对视频创意带来巨大限制(也许试衣环节本身也不需要太多创意,Vibe符合的环境就够了)。
测试后的思考:重构VVT的六大“解题思路”
❗ 干货警报,以下内容比较硬核枯燥,不感兴趣的朋友可以直接下拉文末读结论。
实测后再看前文谈到的3大模式。听起来简单,但要实现其实面临着巨大的技术挑战。这绝非简单地将服装图片“贴”到视频上,而是需要AI像一位经验丰富的裁缝和导演一样,深刻理解服装的材质版型、人体的三维结构以及两者在运动中的复杂互动关系。VVT领域近两年的所有前沿研究,几乎都在试图解决前文提到的“逐帧处理”原罪所引发的两大核心技术难题:
- 细节保真度 (Fidelity): 如何在人物运动和摄像机移动的动态过程中,保持目标服装的精细细节。例如,如何防止服装上的复杂纹理、Logo或精细图案在运动中变得模糊、变形或丢失。
- 时序一致性 (Coherence): 如何确保服装在连续的视频帧中“跟身”且稳定。这不仅要求服装能贴合“复杂的人体动作”和“摄像机运动” ,更要从根本上消除“闪烁”感。
以下将简要解读近期主要的VVT论文(❗ 见文末Notes)——研究者们为克服挑战所提出的六大“解题思路”,作为专业VVT模型,其性能可能被前面那些通用大模型淹没,但这些方法在基础视频大模型上调优、蒸馏、强化学习等方面发挥作用。它们共同构成了VVT技术的前沿景观。
思路一:重构问题 —— 从图像拼接到视频修复
面对恼人的“闪烁”问题,一些研究者没有在原有路径上修修补补,而是选择从根本上重新定义问题。ViTI这篇论文就提出了一个革命性的观点:视频试衣不应该被看作是“在视频的每一帧上做图片试穿”,而应该被定义为一个“条件性视频修复(inpainting)”任务。
想象一下,我们先把模特身上原有的衣物区域“抠掉”,形成一个动态的空白区域,然后让AI去“修复”和“填充”这段视频。这种方法的巧妙之处在于,它从一开始就将任务的本质锁定在视频层面。正如ViTI论文中所强调的:“我们从一个视频生成问题而不是一个基于图像的试穿问题开始,这从一开始就具有更好的时空一致性。”
换言之,这种思路的出发点就是保证视频的“流畅性”和“连贯性”,而不是在生成了N张不连贯的图片后再去亡羊补牢。通过将问题重构为视频修复,AI的首要任务变成了生成一段时序上稳定、动作上协调的动态内容,从根本上绕开了逐帧处理带来的不一致性难题。
思路二:算力聚焦—— 隧道视野,告别模糊
视频画面通常很大,但人物和服装只占其中一部分。如果让AI模型处理整个高清画面,计算资源会被大量浪费在背景上,而最需要精雕细琢的服装细节反而可能因为“注意力不集中”而被模糊处理。Tunnel Try-on模型提出了一个反直觉的解决方案:“隧道视野”策略。它的核心思想是,在生成服装前,先在原始视频中围绕人物的服装区域,挖掘出一条动态的“焦点隧道”。
具体操作上,模型会沿着这条“隧道”裁剪并放大每一帧的服装区域,让AI能够全身心地专注于生成高清的服装纹理、logo和图案。处理完成后,再将这段高清的、细节丰富的试衣视频无缝地融合回原始视频的背景中。这是一种绝妙的计算资源分诊。模型仿佛在说:“我将忽略80%的像素(静态背景),以便将100%的算力投入到那20%真正重要的地方——衣服本身。”正是这种战略性的“忽略”,才使其能够在消费者最关心的细节上达到如此高的保真度。
思路三:时空记忆——从U-Net到Transformer的架构革命
任何AI生成能力的飞跃,背后几乎都伴随着底层模型架构的革新。在视频试衣领域也不例外。早期的扩散模型大多依赖于经典的U-Net架构。然而,随着任务复杂度的提升,双层U-Net在处理视频时空信息上的局限性开始显现。因此,新一代的模型如Dynamic Try-On, MagicTryOn, 和 DreamVVT等,纷纷转向了表现力更强的Diffusion Transformer (DiT) 架构。这也是主流通用图像和视频大模型采用的策略。
为什么要进行这种转换?MagicTryOn的论文一针见血地指出,传统的U-Net架构:“限制了网络的表征能力,使其在重建复杂细节方面效果不佳” 与U-Net相比,DiT架构的核心优势在于其强大的“全自注意力机制”(full self-attention)。旧方法中分离的空间注意力(处理单帧画面)和时间注意力(处理帧间变化)在面对大幅度的快速运动时会力不从心。
想象一下,一个人迅速抬起手臂,分离式注意力可能难以将手臂在第10帧的位置与其在第11帧的新位置有效关联起来,从而导致伪影或“鬼影”效应。而Transformer的全注意力机制能够一次性处理整个视频块,对这类运动形成更直接、更稳固的理解,从而确保衣袖与手臂的动作完美协同。
思路四:语义介入—— 当Video LLM成为“导演”
当视频试衣的真实感要求越来越高时,单纯依赖像素、姿态等视觉数据已经不够了。AI需要更深层次的“理解”:这件衣服应该呈现出什么样的质感?在某个特定动作下,它的褶皱应该如何变化?为此,DreamVVT模型引入了一种先进的“分工协作”模式,它将复杂的视频生成任务拆解为两个更易于控制的步骤:先生成完美的静态关键帧图像,然后再将它们流畅地“动画化”。
第一阶段:生成高质量静态关键帧。 在这一步,DreamVVT利用一个视觉语言模型(VLM)为多视角图像试穿模型生成精确的文本指令。例如,VLM会描述“正面视角:一个穿着带有白色花朵图案的长袖运动衫的男人……”,从而引导图像模型生成一系列在关键姿态下高度逼真且多角度一致的静态图片。这个策略确保了在视频生成开始之前,服装在各个角度的外观就已经完美无瑕。
第二阶段:生成流畅的动态视频。 接着,一个视频大型语言模型(video LLM)会分析原始视频,提炼出一份关于人物动作的详细“剧本”,例如“他向前走,停下,然后轻微转身……”。这份动作剧本,连同第一阶段生成的关键帧静态图,共同被送入最终的视频生成模型,指导其创造出连贯自然的动态效果。
这种“分而治之”的策略,通过语言模型作为桥梁连接图像和视频阶段,为视觉生成提供了远比单独依赖像素数据更丰富、更结构化的指导,标志着虚拟试衣技术进入了一个更高级的、基于“语义理解”的阶段。
思路五:时间锚定 —— 用360°锚点关键帧作为创作大纲
直接生成长达数分钟的试衣视频是一项巨大的挑战。因为随着时间的推移,微小的生成错误会不断累积,最终可能导致视频前后的人物外观或服装样式发生严重的不一致,俗称“画风突变”。Virtual Fitting Room (VFR)模型为此提出了一个极具创意的解决方案。它不直接生成最终的长视频,而是分两步走:
第一步:创作大纲。 模型首先会生成一个极短的、360度全方位展示的“锚点视频”(anchor video)。在这个视频里,模特穿着目标服装,以标准的“A”字姿势缓慢旋转一周,完整地展示了服装在各个角度下的外观。
第二步:参照大纲进行创作。 之后,所有其他更长、更复杂的动作视频片段,都会以这个“锚点视频”作为绝对的视觉参照来生成。
VFR的论文将这个“锚点视频”生动地比作“写文章前的大纲”。有了这个全局一致的“大纲”作为基准,后续无论生成多长的视频片段,模型都能随时回顾和参照,确保人物和服装的外观在整个时间跨度内保持统一。这种“先立大纲,再填内容”的思路,为解决长视频生成中的一致性难题提供了全新的视角。
思路六:算力燃料—— 高质量数据集的军备竞赛
在惊叹于各种巧妙算法的同时,我们绝不能忽视一个常常被低估的幕后英雄:高质量的数据。算法的进步离不开海量、优质数据的“喂养”。以ViViD的研究为例,其团队发现,过去广泛使用的公开数据集(如VVT数据集)存在着分辨率低、服装款式单一、模特动作重复等诸多问题。这些“先天不足”的数据极大地限制了模型的学习上限。为此,ViViD团队选择自己动手,构建了一个规模大5倍、分辨率更高、服装和动作种类也更多样化的全新数据集。
这并非个例。包括ChronoTailor在内的多个前沿研究,都不约而同地投入精力去构建自己的高质量数据集。这揭示了一个深刻的现实:在AI领域,取得突破性进展往往依赖于算法创新和数据“燃料”的双轮驱动。没有优质、多样的数据,再先进的算法也只是无米之炊。
此外,UBC时尚视频以单一人类受试者为特色,具有高分辨率和静态相机。最值得注意的是,这些视频提供了多样化的服装和纹理,涵盖了可能外观的广泛范围。UBC时尚视频和VVT都提供了摄影棚内服装图像,这对于虚拟试穿应用至关重要。相比之下,TikTok数据集和Dance50k提供了更复杂的动作和背景,更接近真实场景。由于它们的动态性和背景多样性,这些数据集对测试基于视频的穿在身上虚拟试穿方法的鲁棒性非常有价值。
结语
试图用单一技术(无论是AR、GenAI还是3D物理引擎)解决所有问题,是当前应用落地遇阻的根源。VTO的“圣杯”不是一项技术,而是一套“混合智能”的业务流程:
- (“骨架”)合身引擎: 通过最轻量级、最便捷的方式建立精准的3D“数字尺码”档案。
- (“血肉”)VVT生成器: 一个先进的VVT模型,接收这三大输入——用户的原始视频、“骨架”的尺码数据、“大脑”的搭配方案。
- (“大脑”)AI造型师: 一个“AI Stylist” 和“多物件”(搭配)引擎 ,根据用户画像和场景,提供完整的造型搭配建议。当今时尚正在发生的预示着明天每个面向消费者的行业将要发生的事情:由生成性人工智能、计算机视觉和上下文分析提供支持的大规模超个性化。推荐完美服装的相同技术可能很快重塑我们买房、选择度假或管理健康的方式。
在前一篇文章生成式AI无法解决虚拟试衣尺码精准,难道回归最初的3D起点吗?提出“骨架”和“血肉”比喻之后,本文补充了“大脑”部分,该架构下生成“合身又合心”的动态试穿视频。是虚拟试衣的“中场战事”后,我们必须走向的下半场。
【Notes】文中涉及的论文
- ViViD: A High-Quality and Large-
Scale Dataset for Video Virtual Try-on
- Tunnel Try-on: Excavating Spatial-temporal Tunnels for High-quality Virtual Try-on in Videos
- Fashion-VDM: Video Diffusion Model for Virtual Try-On
- Dynamic Try-On: Taming Video Virtual Try-
on with Dynamic Attention Mechanism
- SwiftTry: Fast and Consistent Video Virtual Try-
On with Diffusion Models
- Pursuing Temporal-Consistent Video Virtual Try-
On via Dynamic Pose Interaction
- ChronoTailor: Harnessing Attention Guidance for Fine-
Grained Video Virtual Try-On
- Video Virtual Try-
on with Conditional Diffusion Transformer Inpainter
- DreamVVT: Mastering Realistic Video Virtual Try-
On in the Wild via a Stage-Wise Diffusion Transformer Framework
Virtual Fitting Room: Generating Arbitrarily Long Videos of Virtual Try-On from a Single Image Technical Preview
- ONCE IS ENOUGH: LIGHTWEIGHT DIT-
BASED VIDEO VIRTUAL TRY-ON VIA ONE-TIME GARMENT APPEARANCE INJECTION
CatV2TON: A Catenated Vision Transformer for Controllable Video Virtual Try-On
- RealVVT: A Realistic Framework for Video Virtual Try-on
- MagicTryOn: A Diffusion Transformer for Garment-detail-preserving Video Virtual Try-on