【写在前面】在2024年10月我整理了当时 虚拟试穿VTON(Virtual Try-On)技术的发展状况和市场实践。但在过去的这几个月里,AI技术高歌猛进,冲击着各行各业。不仅仅是时尚科技创业者,大厂(Google、 OpenAI)也纷纷落地应用,因此有必要认真研读最新的论文,更新我们对这一项消费级AI应用的认知,再次系统性地剖析VTON技术、当前的最佳表现(SOAT)以及未来趋势。对于时尚零售而言,VTON 已不再是可有可无的“锦上添花”,而是一项战略性必需品。但需要提前说明,本文讨论的虚拟试穿场景将以2C消费者应用为主,而非2B企业服务——传统电商生图工具专注批量部署,与消费端的需求存在明显差异。另外,本次只讲技术迭代,VTON在真实时尚消费场景中的深层意义和挑战请回看去年的文章。
0011::0022
青少年电影《Clueless独领风骚》30周年纪念,7月8日蓝光修复版重新上市。女主角Cher影响了一代时尚潮流,片中曾经是科幻的虚拟试穿衣橱,今天AI让这一切走进现实。女性对穿搭需求的本质从没有改变。
引言
尽管实施成本和技术细节(如复杂搭配、保真度等)仍是VTON普及面临的主要挑战,但技术已经从实验室阶段快速走向大规模商业应用,并在多个维度展现出价值,许多知名零售商和时尚品牌已在其电子商务平台和/或实体店中实施了虚拟试衣间。其中最重要的是,将逼真的虚拟试穿体验融入购物旅程,能够大幅减少商品退货,提升消费者体验,并减少与物流和浪费相关的碳足迹。
VTON技术正在不断演进,主要分为图像模型、3D模型、视频模型和增强现实(AR)融合试穿等几大技术路线,同时,生成式AI作为底层驱动力,贯穿并赋能了所有这些领域,基座大模型甚至有可能颠覆传统的VTON进化路线。以下是各主要技术路线以及具有代表性的20+ SOAT模型及其性能亮点。
Part-1,图像模型虚拟试穿
在去年的文章里我回顾了虚拟试穿发展历史,在2016年“新零售”这个概念被提出来时,得益于游戏产业建模技术高速迭代,包括AR/VR 浪潮的兴起,市面上出现了大批3D虚拟试穿解决方案。但要求每款衣服具备 3D 数字孪生资产是不现实的,服装试穿对于渲染效果显然也远远高于游戏玩家,恐怖谷效应让多数消费者和品牌公司退而却步。
虽然3D可能代表了终局(本文后面将展开),但2D VTON作为一种相对简单的技术,已经进入大众生活并投入使用,在3D VTON完全成熟和大规模普及之前,可以作为一种有效的过渡与补充工具。图像虚拟试穿的核心原理在于通过结合人物图片与服装图片,生成人物穿着目标服装的逼真照片,这种方法因其用户友好性和资源效率而备受青睐。
之前我们已经讨论了很多VTON技术演进早期的2D技术。2020年到2022年这段时间,采纳深度学习方法,通过卷积神经网络 (CNN) 检测和分割不同的身体部位,利用基于流的生成对抗网络(GAN),训练从 2D 图像“模拟”产品的3D效果。其流程通常是先将服装变形以适应人物姿态,再通过生成器将变形后的服装与人物图像融合。然而,GAN容易过拟合训练数据,扭曲模块本身在处理复杂变形时难以精准保留细节,再缺少特定训练数据下,生成图像质量不高且泛化能力差,训练过程可能不稳定易产生可见伪影。
2023年扩散模型(Diffusion)在大众层面开启了图像领域的AIGC时代,它被认为一定程度掌握了能生成“模拟”3D的几何和物理意识。此后从GAN到扩散模型的转变,标志着生成式VTON领域的一次重大范式变革。扩散模型将传统的服装扭曲和融合过程整合为一个统一的交叉注意力操作,其性能通常优于基于GAN的方法。扩散模型在保真度、稳定性方面的优势,使其成为后来研究和商业实现的主流选择。Amazon Nova Canvas和 Google TryOnDiffusion的技术底层核心也都是基于扩散模型的深度优化架构,这一时期其他值得注意的方法还包括:
OOTDiffusion: Outfitting Fusion Based Latent Diffusion for Controllable Virtual Try-On (论
文arXiv链接 https://arxiv.org/abs/2403.01779)
IDM-VTON: Improving Diffusion Models for Authentic Virtual Try-On in the Wild(论文arXiv链接 https://arxiv.org/abs/2403.05139)
CatVTON: Concatenation is All You Need for Virtual Try-On with Diffusion Models (论文
arXiv链接 https://arxiv.org/abs/2407.15886)
EfficientVITON: An Efficient Virtual Try-On Model using Optimized Diffusion Process (论文arXiv链接
https://arxiv.org/abs/2501.11776
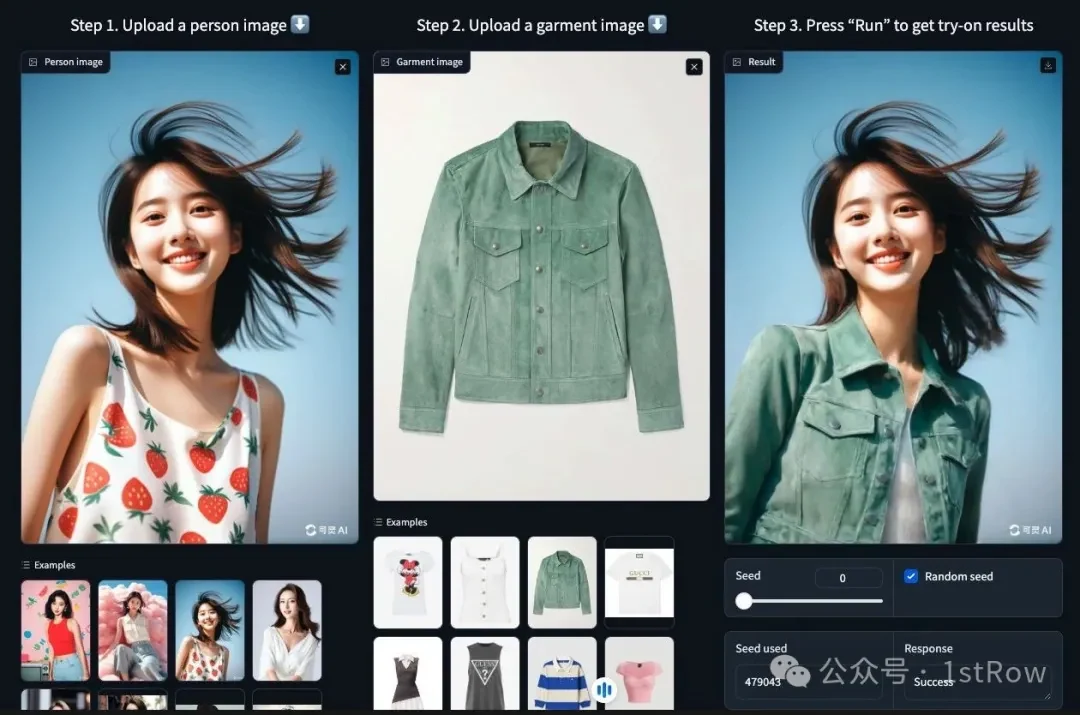
2024年下半年以来,扩散模型开始转向DiT(Diffusion Transformer)架构在可扩展性、长距离依赖建模以及处理多模态上下文方面表现出优势,进一步提升 VTON 性能。将Transformer架构应用于扩散模型中的去噪网络,与传统方法相比,具有更强的可扩展性:Transformer能够更好地处理复杂内容,这使得DiT在处理不同姿态、背景和服装类型时具有更强的鲁棒性和泛化能力。DiT架构拥有强大的条件注入能力,这使得研究人员可以更灵活地将多模态信息集成到去噪过程中,从而实现更精确的控制。
DiT架构不仅能处理图像输入(人物和服装),还能理解和利用文本描述来生成更符合用户意图的试穿效果。例如,TED-VITON就是一个利用DiT架构来提升VTON性能的框架,通过引入约束机制来优化大型语言模型(LLM)的提示生成,从而将文本提示与服装的语义信息相结合,旨在更好地保留服装细节、实现语义对齐并提高文本和标志的清晰度。ITVTON通过结合服装和人物图像的空间通道,利用多模态MM-DiT结构来增强服装与人物的交互,从而提高试穿的准确性。
FitDiT: Advancing the Authentic Garment Details for High-Fidelity Virtual Try-On (论文arXiv链接 https://arxiv.org/abs/2411.10499)
TED-VITON: Transformer-Empowered Diffusion Models for Virtual Try-On(论文arXiv链接
https://arxiv.org/abs/2411.17017)
ITVTON: Virtual Try-On Diffusion Transformer Based on Integrated Image and Text(论文
arXiv链接 https://arxiv.org/abs/2501.16757)
MC-VTON: Minimal Control Virtual Try-On Diffusion Transformer(论文arXiv链
接 https://arxiv.org/abs/2501.03630)
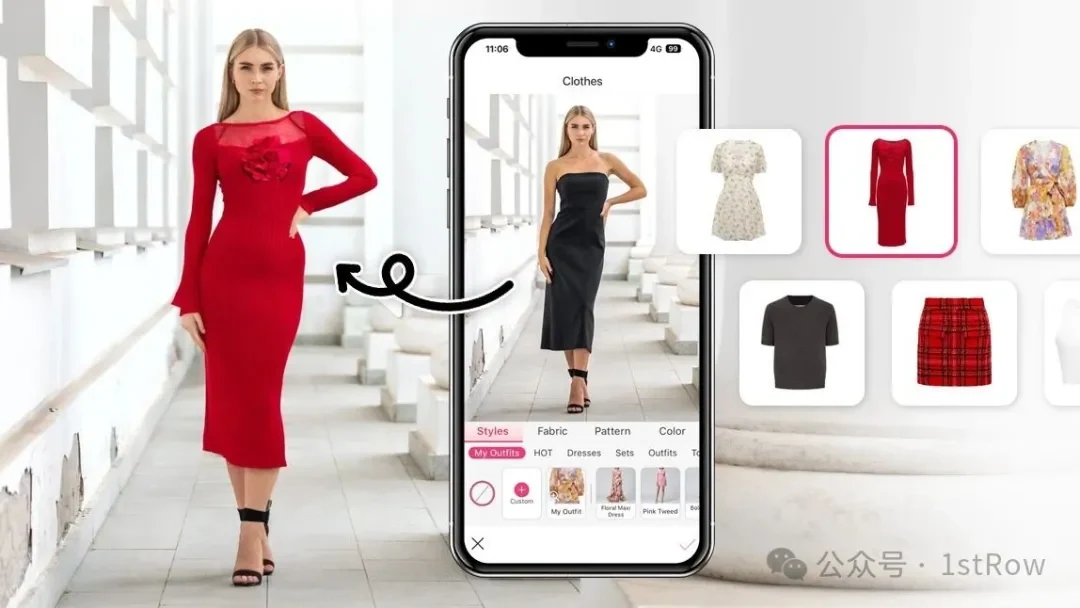
Part-2,来自基座大模型的挑战
基座模型(Foundation Models, FMs)是一类大型AI模型,它们在海量多样化的数据集上进行预训练,这些数据集通常包含文本、图像和视频等多种模态。它们的显著特点是卓越的适应性,能够以高精度执行广泛的下游任务,通常只需要极少或无需额外的任务特定训练。它们被认为是通用且多功能的模型,在庞大的预训练过程中积累了广泛的“世界知识”。在过去的VTON难题中表现出色,比如多服装层叠穿搭(layering)、配饰比例(如包、帽子、鞋子)、透明材质、非常规设计、极致细节保留(如刺绣、印花)。
GPT-4o是一款强大的原生多模态AI助手,能够有效驱动图像生成模型,展现出前所未有的通用图像生成和编辑能力。尽管它并非专门为虚拟试穿任务设计的,但其背后所代表的“Transformer为核心,融合Diffusion”的架构思想,通过Transfusion将文本、图像、视频编码为统一Token序列,Diffusion仅作为图像生成的执行模块,符合甚至是领引了虚拟试穿领域前沿且重要的发展方向。在虚拟试衣场景中凭借其强多模态理解 + 对话式 prompt 控制能力,展现了强大的指令遵循能力,以及灵活快速的创意试装优势。比如语音指令可直接驱动试穿效果调整,适合消费级交互场景;对抽象时尚风格的理解优于专业VTON模型,摆脱后者模型训练/部署复杂,需高端GPU + 多阶段调优的痛点。
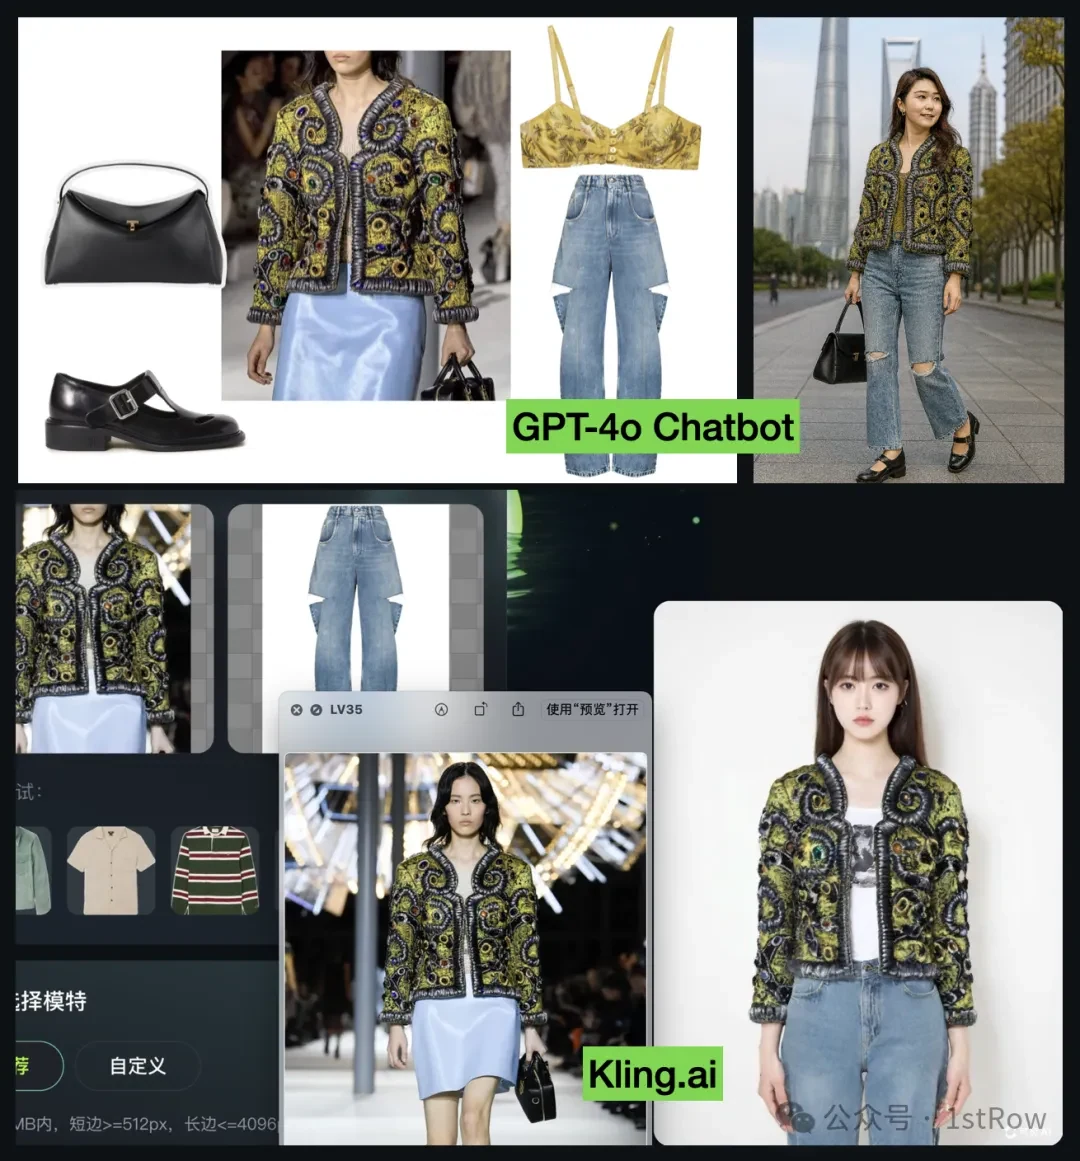
随机对比实验。GPT‐4o在服饰细节风格迁移上保持极高的底线。对比Kling AI采用专业VTON的方案,只能有限单品数量和类型的试穿,前者这一核心能力后续如果优化提示词和多轮次编辑,以及通过API工程接入其他模型或插件,能够实现SOAT效果。
Black Forest Labs的Flux.1系列(包括 Dev、Pro、Kontext),采用“并行扩散Transformer块 + 流匹配(一种与Diffusion类似的生成模型范式 )”的混合架构,通过流匹配(Flow Matching)提升生成质量与速度。今年发布的Kontext更是将文本+图像输入置入「统一生成」编辑框架中,并支持跨多轮对话保持角色与光影一致性。它通过流匹配构建一致的半结构连贯性,对局部换装编辑尤为利好。作为开源模型,通过Comfyui工作流,整合社区围绕官方工具(Fill, Depth, Canny, Redux)开发的丰富插件,实现完全自由的消费级GPU本地运行,为换装场景提供了我认为最高精度的操作能力。
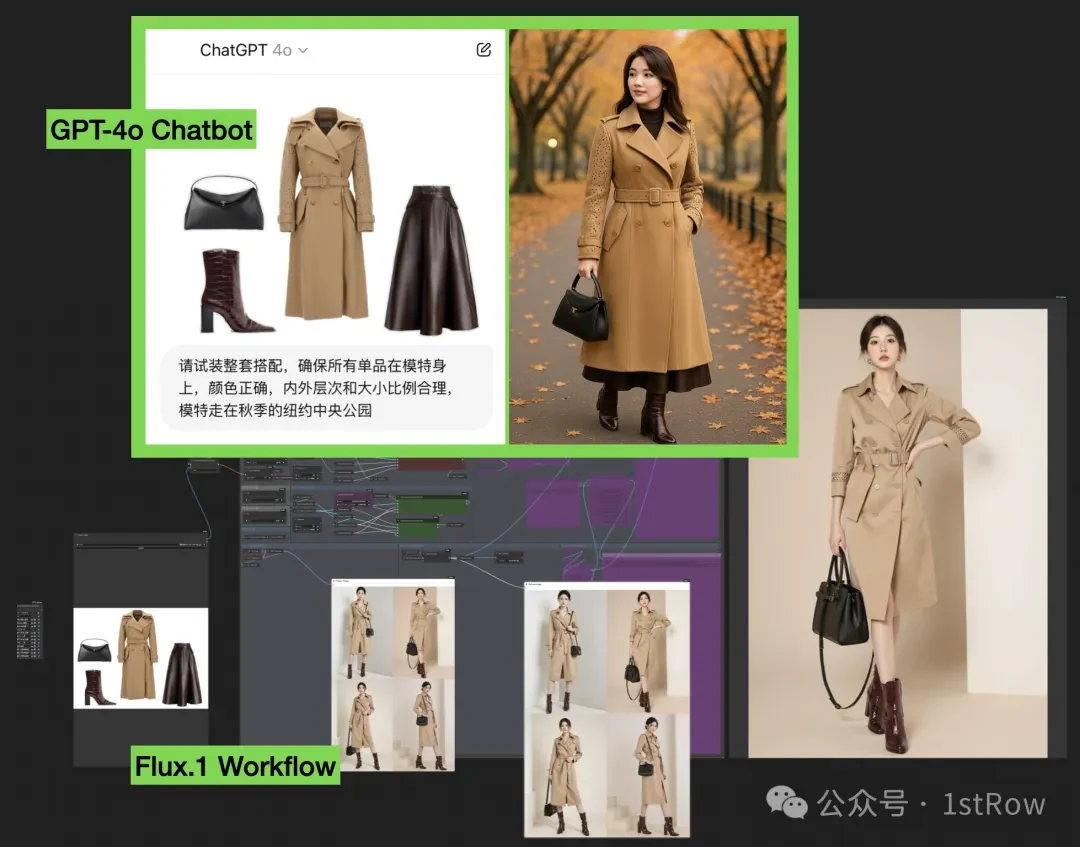
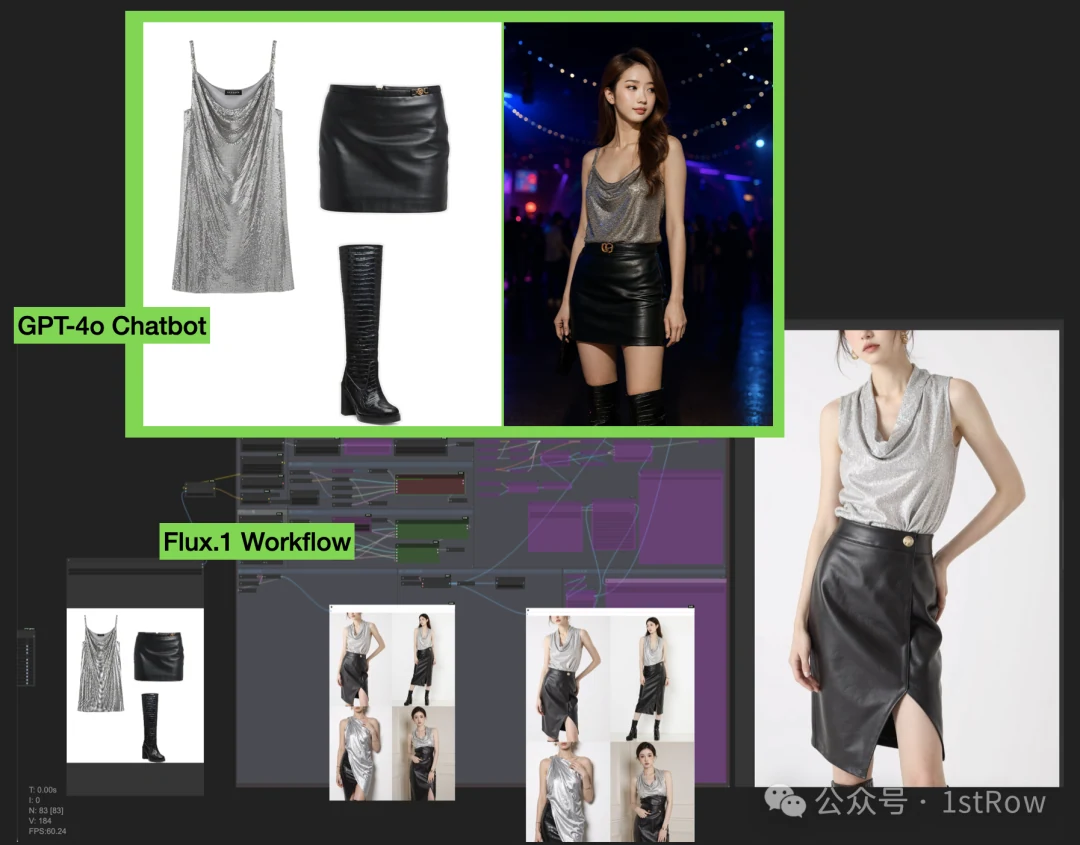
我也做了两次对比Flux的测试,都没有抽卡。GPT-4o表现极强的时尚理解力和友好的用户使用门槛。应该是虑及肖像保护,它关闭了角色一致性的功能。Flux依然是我最爱,它的开放性和灵活性特征,让上限无限高,取决于使用者的能力。
GPT‐4o 与 Flux.1 Kontext提供了开放、多轮、交互式、高效率的试装方式,在创意、社交、消费人群中已有显著优势,它们在控制力与一致性方面也超越传统 VTON。后者仅支持静态的“人体图 + 服装图”输入,无法响应抽象提示;服装类别和搭配层次数量受限(上装、下装、连衣裙),且每增加需重新微调模型,迭代成本高;交互方式依赖专业工具参数调节,缺乏对话式交互能力。这反映了AI领域中关于AI架构未来发展方向的持续争论,即基座模型在各种任务中进行泛化的能力,是否最终会取代或显著削弱对各行业垂直领域专业AI模型的需求。过去和当下在VTON领域投入的大量工作,随着大模型不断提高的“能力海平面”,它们到底是海滩上的“沙堡”,还是能够穿越浪潮的“方舟”?
基座模型可能表现出不透明的行为,使其结果难以调试或解释。它们还存在从其庞大训练数据集中获取偏差的风险,这可能导致不可靠或不适当的输出。现在VTON 依然具备的优势主要来自对布料物理属性和人体差异的深度建模,这种优化通常伴随着对特定数据集的依赖。以及为了保障电商高并发能力,通常采用严格预处理流程,支持大量模板自动生成,速度更快,Pipeline模块清晰,易追踪可解释性与微调。另外,在避免遮盖和身体变形问题上,专业模型通过掩码和感知损失方式提供可控性。
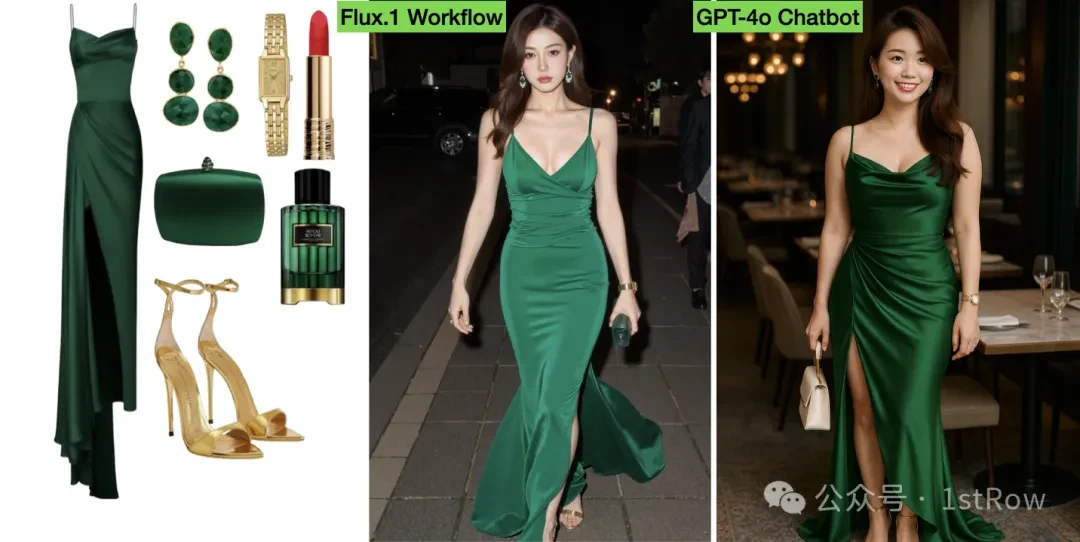
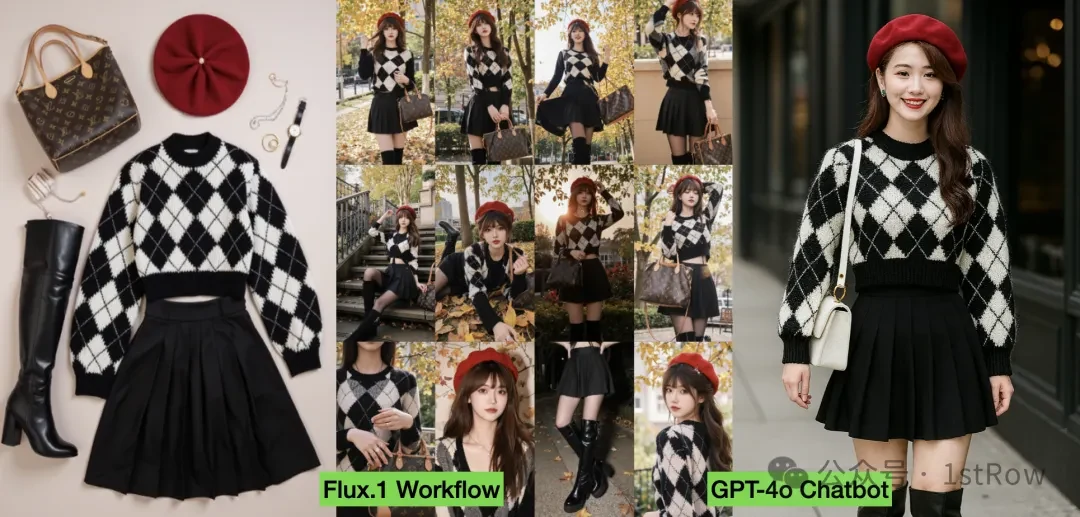
没有经过多轮编辑的GPT-4o出图首张效果已经很能打,对产品本身的解析和遵从强于FLUX的基模。当然,后者叠加LoRA等插件后,在2C消费者的应用场景中,是打造Ins或者小红书风格的最佳利器。
这预示着VTON市场可能出现细分。对于快速、易用、广受欢迎的VTON应用(例如,基本的在线试穿、社交媒体滤镜),基座模型适配成本相对较低,可能会因其易用性和通用逼真度而占据主导地位。然而,对于专业、高保真和专业VTON应用(例如,时尚设计原型、虚拟生产、对细节要求极高的中高端电子商务),专业模型或经过大量工程定制的基座模型可能会因其能够精确控制服装物理特性、复杂细节并保持保真度而不产生意外改变的能力,从而保持其竞争优势。
在计算效率方面,情况更为复杂。传统双网络VTON方法通常会引入显著的计算开销,限制其在高分辨率或长时间图像/视频VTON应用中的可扩展性 。然而,一些最新的专业模型正积极优化效率。例如,EfficientVITON显著缩短了推理时间和训练时间。单网络范式(MNVTON、CatVTON)也旨在通过更紧凑的架构降低计算开销。MC-VTON以极少的训练参数(136.5M)实现了具有竞争力的推理速度(5.23秒生成一张1024x768图像)。虽然基座模型在某些方面速度快,例如Flux.1 Kontext模型声称3-5秒内生成1MP分辨率输出,但其整体运营成本可能高于某些高效的专业模型。
未来发展趋势也许是“基座生成 + 垂直校正”双引擎协同架构。专业 VTON 可专注担任输入预处理(如高精度人体分割)、以及输出优化(如褶皱与物理校正)的角色,为生成模型提供定制化增强。研究者应从重复造轮子转型为基座模型的领域微调专家,通过注入 时尚知识图谱,结合专家经验数据等方式来增强其时尚理解能力,为 VTON 在AI 原生生态中构建坚固护城河。
Part-3,三维模型虚拟试穿
3D模型虚拟试穿的核心原理在于构建一个3D人体模型,并在此模型上逼真地呈现人物穿着目标服装的效果。通过渲染多视角图像来实现服装在虚拟环境中的逼真呈现,支持360度全方位视图渲染。这种技术能够提供更强的沉浸感和交互性,让用户直观地看到服装在不同角度、运动状态下的悬垂和流动效果。与2D方法相比,3D VTON能够提供精准的尺寸控制,这对于真实世界应用至关重要。以及带骨架的3D资产,是未来元宇宙虚拟空间中交互的重要基础设施。
前文提到的传统3D VTON方法通常依赖于三维扫描或布料模拟来生成精确的人体和服装几何结构。这些方法尽管有效,但成本高昂,且需要物理存在的人体和服装,从而限制了其在实际应用中的推广。这些显式形变技术往往难以准确模拟真实的服装褶皱和自然的光影效果,并可能导致不必要的失真和伪影,尤其是在处理复杂的细节或姿态时。现有的方法通常将服装作为图层叠加在参数化人体模型(如SMPL模型)之上,其中一些通过预测人物图像的双深度图来构建3D着装人体。以及采用分数蒸馏采样(SDS)损失技术,:通过利用预训练文本到图像模型学习到的强大2D生成先验来优化3D表示,将2D扩散模型的知识蒸馏到3D表示中,从而创建高质量的3D对象。
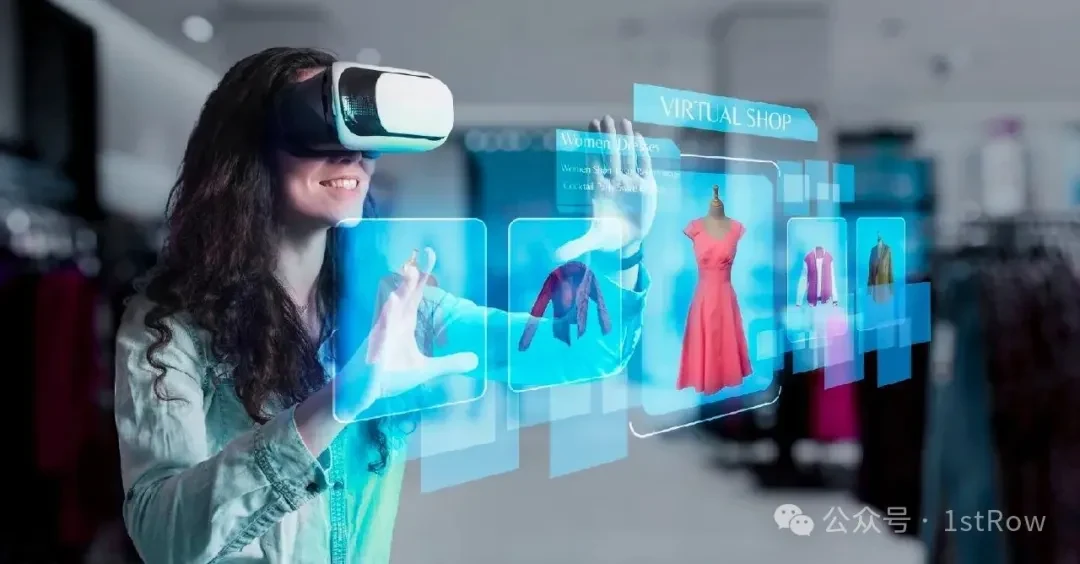
近期,高斯泼溅(Gaussian Splatting, 3DGS)和神经辐射场(NeRF)等新型3D表示技术在VTON领域得到了应用。特别是3DGS,作为一种新颖的2.5D(依赖多视角图像而非真3D建模)技术,它通过直接优化由不透明度、各向异性协方差和球面谐波系数等属性定义的3D高斯表示,实现了高保真渲染和实时性能。这为在3D空间中精确渲染服装和处理遮挡提供了关键基础。将个性化扩散模型(例如通过LoRA微调)与3DGS相结合,能够创建定制化的微调模型,更好地捕捉特定的服装特征,并保持不同视角下的一致性。这些模型并非仅仅尝试将2D结果“提升”到3D空间,而是被设计为在3D环境中固有地操作,直接解决了跨视角一致性和几何扭曲等复杂挑战,这些问题在2D到3D的扩展中难以解决。
GaussianVTON: 3D Human Virtual Try-ON via Multi-Stage Gaussian Splatting Editing(论文arXiv链接 https://arxiv.org/abs/2405.07472)
DreamVTON: Customizing 3D Virtual Try-On with Personalized Diffusion Models (论文arXiv
链接 https://arxiv.org/abs/2407.16511)
GS-VTON: Controllable 3D Virtual Try-On with Gaussian Splatting(论文arXiv链接3DV-TON: Textured 3D-Guided Consistent Video Try-On (论文arXiv链接
https://arxiv.org/abs/2504.17414)
3D VTON技术在不同视角和运动中准确保留服装上的精细图案、纹理、徽标和文字,仍然是一个重大难点;并难以保证变形后的服装在各种姿态和视图中与人体完美对齐,以及在动态连续帧中保持结果一致,避免闪烁、抖动或不自然的变形;将服装准确地适配到具有多样化和复杂姿态的人体上,并处理遮挡(例如,手、头发)是困难的,这常常导致服装变形不佳或产生伪影;3D VTON方法,特别是那些涉及三维重建或复杂模型的,通常比2D方法有更长的处理时间和更高的计算需求,在不损失质量的前提下减少推理成本是持续研究的领域;最后获取包含多视图人体和服装图像的大规模、高质量数据集,特别是在具有多样背景和光照的真实“野外”场景中,既关键又具挑战。
Part-4,视频模型虚拟试穿
视频虚拟试穿(Video Virtual Try-On, VVT)的目标是在视频流中无缝地为人物穿上特定服装,同时保持服装的视觉真实性,并动态适应人物的姿态和体型。从而让消费者无需实际试穿就能直观地看到服装在不同角度、动态下的悬垂和流动效果。与图像虚拟试穿相比,VVT 要求在保持服装细节的同时,还需确保视频帧之间的时间一致性。直接将图像试穿技术逐帧应用于视频,难以保证帧间的时间一致性,导致视频中出现闪烁、抖动或不自然的变形。
此外,传统及早期的VVT方法通常基于生成对抗网络 (GAN),并依赖于光流(optical flow)几何形变 (warping module) 来调整服装以适应人物姿态。这些方法通过预测中间值来扭曲目标服装到视频的每一帧中。然而,这些方法普遍存在以下问题:难以准确模拟真实的服装褶皱和自然的光影效果;在处理复杂姿态或大变形时,容易引入伪影和失真;生成结果的视觉质量较低,且缺乏服装细节;为此,解决方案包括在扩散模型中整合时序模块、3D卷积层和时序注意力机制。
渐进式时序训练,即从单帧开始逐步增加视频长度,有助于模型学习帧间的时间依赖性。视频VTON领域正从简单的帧生成向确保无缝、高保真度的视频体验迈进。这要求在视觉质量、时序一致性和计算成本之间取得精妙的平衡,推动研究转向更优化、更集成的架构,而非仅仅依靠暴力计算。与图像模型虚拟试穿一样,也面对来自基座大模型的挑战。Veo3、Sora、Kling,以及诸多开源的通用视频模型,可能导致这些专业模型的研究失去价值。
ViViD: A High-Quality and Large-Scale Dataset for Video Virtual Try-on (论文arXiv链接https://arxiv.org/abs/2405.01688)
CatV2TON: A Catenated Vision Transformer for Controllable Video Virtual Try-On(论文arXiv链接 https://arxiv.org/abs/2406.03953)
RealVVT: A Realistic Framework for Video Virtual Try-on ( 论 文 arXiv 链 接https://arxiv.org/abs/2406.05933)
MagicTryOn: A Diffusion Transformer for Garment-detail-preserving Video Virtual Try-on(论文arXiv链接 https://arxiv.org/abs/2406.09212)
Part-5,增强现实(AR)等其他试穿
增强现实(AR)融合试穿的核心原理是将虚拟内容实时叠加到真实世界影像中,从而创造出个性化、交互式的体验。现代VTON系统能够将数字物品动态地映射到用户的面部、脚部或全身轮廓上,并实时考虑运动、垂坠、拉伸和光照条件。计算机视觉技术能够检测面部特征点、骨骼轮廓和身体尺寸,以实现精确的数字叠加。实时交互功能允许用户移动身体,从不同角度观察产品效果。此外,针对特定物品,如手表(使用AR标记)、鞋子(足部姿态估计)和美妆产品(面部特征点检测),还采用了基于传感器的技术。
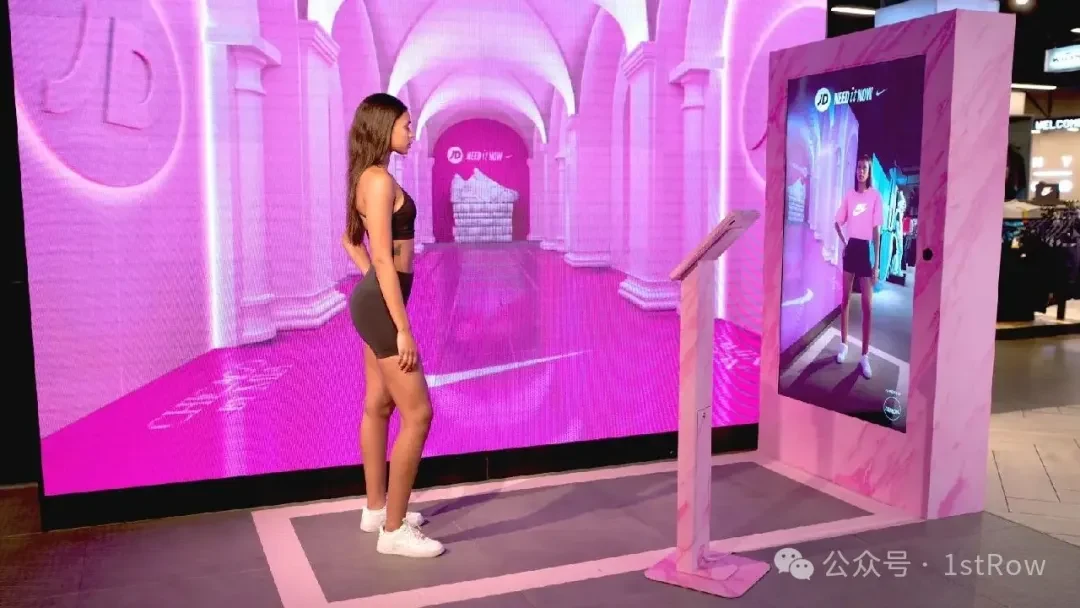
AR VTON的“魔力”直接来源于先进的、低延迟的计算机视觉算法,用于姿态追踪、物体识别和环境理解,并结合AI进行智能映射和个性化。这表明AR VTON并非一项独立的技术,不断推动着实时处理和精确度的边界。除了上述主要的试穿技术路线,以下也是值得关注的跨领域技术和其他方法:
AI大模型赋能: 生成式AI(特别是扩散模型)不仅是2D、3D和video VTON中的一个组成部分,更是塑造整个领域的一股强大力量。基座模型提供了前所未有的通用生成能力和易于集成性,而专业VTON技术将作为关键的“适配层”和“优化器”,将在精细细节保留、处理复杂服装物理特性以及确保动态场景中的时间一致性方面仍保持着独特的优势。未来的发展趋势可能不是基座模型的完全取代,而是一种协同的混合方法。在这种方法中,强大的基座模型将作为基础,并通过专业模块和参数高效微调技术进行适配,以满足VTON的特定需求。
逆向虚拟试穿:VTOFF是一项新颖的任务,旨在从穿着者的单张照片中生成标准化的服装图像。与VTON不同,VTOFF的目标是提取规范的服装图像,这对捕捉服装形状、纹理和复杂图案提出了独特挑战。它在电商领域具有广泛的应用前景,能提升用户体验和运营效率:可以从日常照片中生成标准化服装图像,减少对昂贵摄影设备和耗时编辑的需求;生成的标准化图像可以无缝集成到现有VTON解决方案中,实现更复杂的“人对人”试穿;还能为推荐系统和客户到产品检索系统提供标准化的服装表示。支持从内容中进行视觉检索,从个人衣橱上传照片中,比如从KOL或街拍图像中分离标准的服装单品静物图。
ControlNet和LoRA: 它们是广泛采用且高效的技术,用于针对VTON等特定任务微调大型预训练扩散模型。ControlNet为扩散过程提供精确的结构引导(例如,人体姿态关键点、分割掩码或深度图),从而实现对VTON输出的条件控制 。另一方面,LoRA实现了参数高效的适应,通过向大型模型的冻结权重中注入小型可训练模块,实现个性化或任务特定的VTON。这显著减少了可训练参数的数量和VRAM需求,同时保留了预训练模型的强大生成知识 。
参数高效微调(PEFT):像LoRA这样的技术是基座模型适应VTON的核心。PEFT方法通过冻结大部分原始基座模型权重并仅注入小型可训练模块(例如,低秩分解矩阵)来实现成本高效的微调。这显著减少了可训练参数的数量和VRAM需求,同时有效保留了基座模型庞大的预训练知识。这使得基座模型能够高度适应VTON,而无需承担全面再训练的巨大计算成本。
O2O混合模型:虚拟试穿的未来很可能走向混合模式,融合虚拟和实体试穿体验。例如,在实体店中设置智能试衣镜,或者提供在线预约到店试穿的服务。
结语
虚拟试穿技术正经历由生成式AI驱动的深刻变革,显著提升了图像、3D和视频试穿的真实感、效率和一致性。2D VTON已从传统图像处理和GANs转向高保真扩散模型,并开始关注效率优化。3D VTON通过高斯泼溅等新型3D表示与2D扩散模型的结合,实现了更逼真的多视角体验。视频VTON在解决时序一致性和动态姿态交互方面取得了显著进展,为实时应用奠定基础。AR融合试穿已成为商业化主流,其“魔法”背后是强大的计算机视觉和AI能力。
虚拟试穿技术正从简单的“试穿”功能,演变为一个更广阔的“数字时尚生态系统”的关键组成部分。个性化和“AI孪生”是未来VTON发展的核心驱动力,将带来超个性化的购物体验。
多模态融合与智能推荐:结合文本、语音、肢体语言等多模态输入,VTON将实现更自然的交互和更精准的智能推荐。依靠 时尚知识图谱,AI将能够更深入地理解用户的意图和偏好,提供高度定制化的时尚建议,甚至预测未来的需求。
边缘计算与设备端部署:为了实现隐私保护啊,无缝、实时的用户体验,模型优化将是关键,以支持在移动设备和智能穿戴设备上高效运行虚拟试穿应用。这将推动模型压缩、高效推理算法和硬件感知AI的进一步发展。
效率优化:进一步研发单网络范式或模型蒸馏技术,以在保持高保真度的同时,实现更低的计算开销和更快的推理速度,从而支持更广泛的部署,包括边缘设备。
全栈式沉浸体验:未来的VTON将融合AR/VR/MR技术,提供更具触感和空间感的试穿体验,超越纯粹的视觉层面。这将创造全新的交互方式,让用户不仅能“看到”服装,还能“感受”其材质和垂坠感。
行业标准:VTON技术走向商业化,行业标准(如服装数字化标准、人体扫描数据标准)的建立至关重要。
可持续时尚的赋能者:VTON作为减少退货、优化库存和促进循环经济的关键工具,将在可持续时尚中扮演更重要的角色。通过减少不必要的生产和运输,VTON有助于构建更环保的时尚产业。
信任和数据安全:因为用户的身体图像和数据通常是VTON的必要输入,确保这些敏感数据的隐私和安全,以及防止滥用(如深度伪造),是技术开发者和平台提供者的责任。
心理健康影响:模型在训练时可能需要更严格的数据筛选和偏见控制,例如可能引发身体形象焦虑,负责任的AI开发应包括对这些问题的持续研究、数据过滤、模型规范编码以及透明的用户沟通。
跨行业应用拓展:除了时尚零售,VTON技术将在医疗(如假肢试配、康复训练中的服装辅助)、娱乐(如虚拟角色定制、游戏内服装体验)、教育(如服装设计教学)等领域发挥更大作用,其应用边界将持续拓宽。
VTON的长期愿景远不止于减少退货。它旨在创造全新的方式,让消费者与产品互动、个性化其身份,并在数字优先的世界中与品牌互动。这意味着VTON将成为更广泛的元宇宙、数字孪生和AI驱动的商业战略中的关键组成部分,而不仅仅是一个独立的功能。