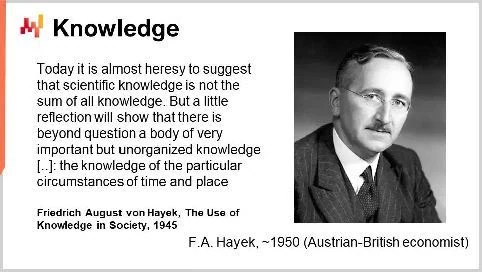
【写在前面】又是密集开发的一周。最近的产品挑战是如何量化“不可言说”之物。唯一确定的是在用户决策和商品供给之间,抽象的映射关系不应该建立在后者之上,所有的主观意识是在需求侧发生的。技术应该包含从“被动检索”到“主动观察”的架构跨越;私人记忆图谱的动态权重更新;以及对齐“未被表达的负面清单”。周末读诺贝尔经济学奖获得者哈耶克的《个人主义与经济秩序》,他谈到的个人知识让我重新思考上述挑战:大部分知识是隐性的,连拥有它的人都未必能用语言精准表达…没有任何一个中央机构能把这些庞杂、无序的个人知识全部收集上来。
你正在沦为“智能无产阶级”而不自知
上一代人已经痛定思痛地领悟了“免费的往往是最贵的”。但到了今天,巨头们不仅收回了供你白嫖的便利,还要你掏空口袋支付算力租金,最后再微笑着把你安身立命的隐性技能连根拔起。你以为你在拥抱未来,其实你只是在花钱训练自己的替代者。
在上一代互联网的尾声,几乎所有人都已经意识到:当你不用为一个产品付钱时,你就是那个产品。我们默认了用个人的隐私、注意力去换取算法推荐带来的廉价便利。
今天再想象一下,科技巨头端上米其林级别的“波士顿龙虾”。你张开嘴,最顶级的算力、最聪明的多模态模型、最完美的逻辑推演就会源源不断地喂进你的屏幕。太美味了,太便利了,以至于没有人会拒绝这种从天而降的“馈赠”。
但商业世界里从来没有免费的午餐。如果你还把A2A(Agent to Agent)时代当成“注意力收割”的下半场,那是对系统贪婪的严重误判。Web2.0的巨头们早已撕下了“用隐私换便利”那层温情脉脉的遮羞布,完成了一次令人胆寒的剥削升维:你成了一个倒贴钱的数字佃农。每个月按时向云端地主缴纳着算力租金,掏出自己半生心血攒下的种子与农具,在他们的闭源土地上拼命劳作。最终,你捧回的只是几份“赛博黑面包”,而地主却榨干了你的收成,去批量制造明天就能取代你的机器。
在这个一切都被算力加速的时代,新的阶级的鸿沟正在以一种极其隐蔽的方式重新撕裂。未来的社会阶层不再由你的资产多寡来决定,世界正在极速撕裂为两群人:一种是掌握私人Agent的“数字贵族”;而绝大多数人,正在不可逆地滑向“智能无产阶级”的深渊。
这并非危言耸听。这是一场已经发生在你我屏幕前、键盘上、乃至潜意识深处的无声掠夺。
Part 1,警惕全知的中央大脑
要警惕全知的中央大脑。不是因为它做不到,恰恰是因为它已经做到了—— 通用大模型本质上就是一种“认知上的中央计划”。
要理解我们当下的处境,可以回溯到1945年。那一年,哈耶克论文集 《个人主义与经济秩序》出版, 在《知识在社会中的运用》这篇只有二十几页的短文里,给出了他一辈子最核心的洞察:中央计划经济之所以注定失败,是因为社会运转所需的知识是分散在千百万人脑中的。大部分知识是隐性的,连拥有它的人都未必能用语言精准表达。
没有任何一个中央机构能把这些庞杂、无序的隐性知识全部收集上来。因此,哈耶克断言:用中央决策替代分散的市场机制,在认识论上是“行不通”的。
然而,历史开了一个残酷的玩笑。哈耶克当年认为“行不通”的事情,今天的科技大厂通过吞噬全人类互联网数据的万亿参数大模型,在技术上竟然“做到了”。但这恰恰是最细思极恐的地方。哈耶克最深刻的警告,其实从来都不是“中央计划效率低”,而是“任何试图用中央大脑替代分散个体的尝试都极度危险。信息的集中必然导致权力的集中,而不受约束的权力终将被滥用”。
如果你仔细审视当下巨头们的商业模式,你会发现这套“中央大脑”正在通过两把极其锋利的镰刀,完成对普通个体的双重收割。
巨头们早就收回了最初那点“技术普惠”的伪善。看看现在的模型订阅界面吧:从免费的降智版、20美金的标准版,到动辄数百美金甚至仅限企业API调用的满血推理版。这根本不是买一部千元机和万元机的区别。这是在人为制造认知能力的硬性阶层和智力折叠。付费墙背后的算力分配不均,直接导致了工作产出、决策质量和学习效率的几何级差距。当穷人只能使用经过阉割、满嘴政治正确和车轱辘话的廉价模型时,支付高昂租金的阶层却能轻易撬动万倍于己的智力杠杆。科技巨头实质上垄断了“智商”的分配权,让你连参与竞争的资格都要按月续费。
他们还设下了一个更庞大的陷阱:在2024年,他们还只是用对话机器人这样的小玩具来试探;但到了今天,各大厂疯狂推崇的已经是类似 OpenClaw 这样先进的 Agentic(智能体化)框架。他们高举着“开源生态”和“多智能体编排”的大旗,向所有人抛出橄榄枝。他们告诉你:“来吧,把你的私有知识库接进来,把你耗费半生心血沉淀的“立身之本”写成Prompt,把你行业摸爬滚打十年的SOP编进工作流,把你那些不可言传的“隐性决策逻辑”提炼成一个个具体的 Skil.md。只要你部署在我们的云端框架上,你就能拥有一个24小时为你打工的超级助理!”
这绝对是本世纪最完美的赛博圈地运动。
在与这些框架高频交互的过程中,你每一次对AI输出的纠错、你为了绕过某个业务陷阱而临时补充的判断条件,全都被系统静默记录。这些代表着极高价值的“领域 Know-how”,会被直接吸收到下一代基础大模型的权重训练中。你的独特技能,瞬间变成了下个月通用模型的出厂默认设置。
你以为你在利用先进框架赋能自己?实际上,你只是一个自带干粮的高级数据标注员。
Part 2,从“显性偏好”到“潜意识图谱”的全面夺权
中心化大脑的全知,本质上是一种“高维坍缩”。它不仅无视了你明确定下的规矩,更暴力地将你幽暗、丰富、充满颗粒度的直觉,压缩成了平庸的概率输出。而在 A2A 的未来,你的去中心化 Agent 必须是绝对忠诚的信托人(Fiduciary)。它的唯一 OKR 就是最大化主人的利益,而不是遵守通用大模型的“政治正确”。
在讨论如何反抗之前,我们必须厘清一个残酷的真相:对个人偏好和潜意识的捕捉,在硅谷和各大厂的兵器谱里根本不是什么新鲜事。
打开你的手机,抖音的滑动停留时长、淘宝的点击跳出率、甚至你打字时的停顿频率,上一代Web 2.0巨头早就在用推荐算法测绘你的多巴胺分泌曲线。他们精准地分析你的显性需求和隐性欲望,然后替你做决策。他们收集这些数据,是为了将你打包成一个具有极高转化率的“流量节点”卖给广告商。
因此,Agent时代的革命本质,绝不在于实现了哈耶克认为无法完成的数据集中任务,而在于将这种对个人数据的“分析主权”,从巨头手中暴力夺回,交还给用户本身。
未来的护城河,是构建一个完全属于你自己的、物理隔绝的“全模态个人认知库”。你的数据不再被上传到云端去喂养那个规训你的利维坦,而是沉淀在本地,喂养一个绝对忠诚于你的赛博分身。这个坚不可摧的壁垒,由浅入深分为两层:显性的铁律,与隐性的深渊。
第一层:作为“绝对宪法”的显性个人偏好
在巨头手里,那些你能够清晰表达的、结构化的显性偏好只是用来精准投喂广告的“标签”;但在私有Agent手里,这些偏好是不可违背的“信托责任”。
让我们代入一个最日常的个人生活场景:健康与消费管理。
假设你明确地定下了一条显性偏好:“我正在进行严格的抗炎饮食,并且这个月的非必要消费不能超过2000元。”如果你把这个需求交给中心化的平台算法,它表面上会给你推荐“抗炎食谱”,但实际上,它的商业逻辑会不断向你推送价格极其昂贵的“进口有机抗炎补剂”或是“高端轻食餐厅打卡”,不断用消费主义侵蚀你的预算底线。因为巨头的算法,其核心OKR是GMV。
而你的私有Agent,会将你的显性偏好视为“绝对宪法”。当它替你规划一周饮食或在生鲜电商下单时,它会冷酷地屏蔽掉所有溢价极高的营销陷阱,严格遵循你的预算红线,甚至在你试图冲动消费时,物理切断支付接口并甩出你上个月立下的誓言。这种对显性规则的绝对捍卫,是将你从消费主义的“楚门的世界”中解救出来的第一道防火墙。
第二层:深水区里的“潜意识图谱”
如果说显性偏好是铠甲,那么潜意识图谱就是你的灵魂。通用大模型给出的知识是百科全书式的线性结构,而私有Agent要继承的,是你那不讲道理却极其精准的直觉网络。
1. 跨域映射的“认知拓扑”
假设你正在准备装修自己的新家。你在显性偏好中明确输入了“北欧极简风”和“总预算三十万”。通用大模型会立刻给你生成一套标准的视觉方案,甚至连宜家的购买链接都给你配齐。
但你的私有Agent所掌握的潜意识图谱,记录的是你极度个人化的异质性连线:它知道你对某种特定频段的顶灯有着本能的生理排斥(因为会引发你的偏头痛);它记得你伴侣在某个雷雨天对一张厚重橡木桌表现出的触觉依恋;它甚至储存了你去年在某本旧杂志上凝视了整整三分钟的一块摩洛哥手工地毯的纹理。
它在规划空间时,不是在生硬地匹配“风格”,而是在重组你的“情感记忆节点”。这种将童年嗅觉、生理边界和视觉审美进行跨域映射的能力,是任何通用AI都无法攻破的认知壁垒。
2. 决策中的“启发式直觉”再比如规划一次全家人的长途旅行。你的显性偏好是“去日本关西,人均预算一万,主打休闲”。通用AI会给你一份详尽的打卡攻略和最优路线图。但这通常是一场灾难。
因为在真实的家庭生活中,决策往往充满了“隐性工作流”。你的Agent知道,行程表上最关键的不是去哪几个景点,而是必须在下午两点为孩子预留绝对的午休时间;它知道你的伴侣在连续身处人群密集处超过三小时后会陷入暴躁;它甚至能根据你最近日程表上的高压会议密度,主动取消原本计划好的“特种兵式名胜巡游”,替换成一家提供深度冥想和碳水美食的隐秘温泉。
它懂得在错综复杂的家庭矛盾和情绪起伏中做“暴力剪枝”。它懂你的退路,懂你的底线,懂你“没说出口的烦躁”。
真正属于个人的Agent,是一面照妖镜,也是一把手术刀。它不仅能一丝不苟地执行你的显性意志,更能在这个被标准答案统治的世界里,为你保留下那些幽微的、不讲道理的、却恰恰定义了“你之所以为你”的潜意识阵地。
Part 3,A2A时代的黑暗森林与大逃亡
未来不分穷人和富人,只分“拥有私人 Agent 的数字贵族”和“被通用大模型投喂的智能无产阶级”。你在淘宝上被算法收割钱包,在小龙虾里被对齐算法收割思想。没有私有 Agent 的保护,你在赛博空间里就是一个手无寸铁的数字难民。
当个人偏好与潜意识图谱的主权彻底回归个人,互联网的交互形态将发生一次暴力的断裂。未来的赛博空间不再是脆弱的人类肉身与无孔不入的推荐算法进行肉搏,而是演变成一片A2A(Agent to Agent)的黑暗森林。当你在赛博空间“逛街”时,是你的私有Agent(携带着你的绝对预算、审美底线和时间管理策略)去与电商平台的Agent进行冷酷、高速的密码学谈判。
为了支撑这场博弈,极客与反叛者们正在基础设施层发起一场浩浩荡荡的“大逃亡”。我在上一篇文章里的观点还不够全面,表面上看,它们由经济、物理和密码学筑起的技术高墙似乎无懈可击。但如果我们用最严苛的“认知主权”来审视,这套解构依然隐藏着致命的阿喀琉斯之踵。
“赛博印钞机”的幻觉:财务独立 ≠ 意志独立
要让AI替你谈判,它首先得有钱。传统的信用卡体系根本无法支撑Agent每秒上千次的“微厘”级算力结算。于是,Web3极客们复活了HTTP 402协议,让Agent通过MPC 钱包直接使用稳定币完成瞬时结算。AI终于拥有了不被任何人冻结的“财务主权”。这极度必要,但这远远不够。财务独立绝不等于意志独立。想象一下,你的Agent拥有极其安全的加密钱包,用着去中心化的网络,但它的大脑——那个负责推理和决策的模型——依然是通过调用某个闭源巨头(比如OpenAI或Anthropic)的API来实现的。
巨头根本不需要冻结你的钱包,他们只需要在模型端稍微调整一下RLHF(基于人类反馈的强化学习)的权重,就能瞬间扭曲你Agent的商业决策或审美倾向。这个时候,你的Agent不再是你的赛博分身,而是一个拿着你的钱、替巨头办事的“自带干粮的提线木偶”。
“物理大逃亡”的陷阱:算力边缘化 ≠ 训练权分散
为了防止巨头“拔网线”,DePIN(去中心化物理基建)和边缘AI(EdgeAI)发起了算力大逃亡。极客们试图将闲置算力池化,或者把模型直接塞进你家客厅的路由器和本地服务器里。这听起来简直是哈耶克式分散知识的完美技术注脚。虽然推理环境确实去中心化了,但“最强基座模型”的训练权依然被极度垄断。今天,只有手握上百亿美元的寡头能暴力烧出下一代前沿大模型。如果我们所谓的“大逃亡”,只是委屈自己在边缘设备上运行落后巨头两三代的开源小模型,那这不叫主权独立,这叫“技术降级”。去中心化网络如果只解决推理问题,而攻不破去中心化训练的世纪难题,物理逃亡就只是一场自我感动的狂欢。
“密码学高墙”的死结:数学的完美 ≠ 物理的现实
既然打不过巨头的大模型,那能不能把隐私数据加密后发给云端处理?AgentCrypt等框架试图将全同态加密(FHE)和零知识证明(ZKP)工程化。在理论上,这是完美的圣杯:云端巨头只能在密文状态下计算,对你的数据一无所知。大厂想偷窥你潜意识图谱的企图,在数学定律面前被砸得粉碎。但最大的敌人从来不是巨头,而是冷酷的物理定律。在目前的工程现实中,FHE带来的计算算力损耗和延迟是巨大的。在A2A的高频商业博弈中,你需要的是毫秒级的直觉反应。在这个阶段,我们必须妥协,转向可信执行环境(TEE)与局部FHE的混合架构,在“绝对的密码学安全”与“可用的商业效率”之间寻找灰度解法。
补齐“认知主权”的最后两块拼图
既然经济主权会被“洗脑”,边缘算力存在“代差”,密码学又受制于“延迟”,我们到底该如何打破基础设施的垄断?
1,用“知识蒸馏”打造私有微型大脑
我们必须利用巨头的大模型去生成海量高质量的合成数据,将它们的能力“蒸馏”出来,然后在本地算力上,训练一个极其专精的、百亿参数级别的垂直小模型。在这些绝对垂直的领域内,由于它被你个人的独特数据高强度喂养,它的判断力将直接贯穿并超越通用大模型的平庸视角。“绝对的专精”,就是对抗“通用垄断”的终极武器。
2,夺回语义解释权——本地化的多模态向量空间大厂垄断的不仅仅是算力,更是“解释世界的权力”。当你的Agent在日常摄入海量的跨界信息、沉淀你的潜意识图谱时,这些非结构化的记忆必须被转化为高维向量存储起来。如果你使用了大厂的标准Embedding(嵌入)模型来处理这些数据,那么你最私密的记忆,实际上是被大厂的价值观和分类标准重新编码了一遍。因此,底线中的底线,是在边缘设备上部署完全私有的多模态向量数据库,并使用独立的、不受商业干预的Embedding模型。只有当你牢牢掌握了数据是如何被切分、如何被编码、如何被检索的底层逻辑时,那些隐性的、直觉性的个人经验,才能真正成为不被云端剥夺的数字资产。
Part 4,自由的代价与普通人的绝地反击
如果自由不是免费的,那么在 AI 时代,个体为了维护认知主权,就必须支付一种名为‘对抗熵增的刻意练习’的货币。
技术架构的大逃亡只是地基,最残酷的考验其实在于我们人类自身。
很多人对个人Agent抱有一种不切实际的幻想,期望它像传说中的“田螺姑娘”一样,只要开箱激活,就能在后台默默读懂你所有的心思。但现实是冷酷的:没有任何一个外在系统,能凭空长出你的潜意识。享受中心化AI的便利,就是在出卖主权;而要拥有一个强大的专属Agent,你需要支付极高的认知门槛和维护成本。
成为自己思想的“首席档案官”。
你脑海中那些转瞬即逝的灵感、你对某次失败谈判的直觉复盘、你读完一本晦涩哲学书后产生的荒谬联想……如果这些碎片不被你主动地、结构化地沉淀下来,它们就永远无法成为你个人智能体的壁垒。
这意味着,在日常的阅读和工作流中,你必须多做一步极其繁琐的“外化”动作:打标签、写备注、记录你当时为什么会皱眉、为什么会兴奋。这种长年累月的枯燥记录,就是为了不被中心化巨头“脑控”而必须缴纳的自由税。
忍受“延迟满足”与系统的愚笨。
使用通用大模型是即时满足的,输入提示词,三秒钟给你一篇华丽的报告。而训练一个真正懂你的私有Agent,在很长一段时间内会充满挫败感。它一开始抓不住你的行文风格,理解不了你的隐喻,甚至会给出极其弱智的建议。
普通的“智能无产阶级”在这个阶段就会放弃,重新投入巨头温柔的陷阱。而试图成为“数字贵族”的个体,会选择忍受这种不完美。你要像教导一个极具天赋但缺乏阅历的学徒一样,不厌其烦地纠正它的每一次跑偏,把你的价值观和批判性思维一行一行地刻进它的反馈循环里。
死守“第一张草图”的红线。
对于不具备极客训练模型能力、无法亲自部署端云混合架构的普通人来说,我们该如何在这个算法横行的世界里绝地反击?答案是:在你的日常输入与输出流中,划定一条绝对不可逾越的物理与心理防线——永远拒绝大模型对你核心思考的“零秒介入”,誓死捍卫“第一张草图”的主权。拒绝‘平庸的正确’。捍卫你的偏见和独特的跨域映射能力,就是在捍卫你作为独立思考者的存在感。
通用大模型最擅长的,就是给你一个结构极其完整、逻辑看似严密,但本质上是“最大公约数”的平庸框架。一旦你看到了那个由百亿参数算出的“标准答案”,人类大脑不可避免地会产生“锚定效应”。你的思维会瞬间被吸入它设定好的轨道中。
真正的抵抗,必须在“离线状态”下发生。
在面对一个新命题时,你必须先在“物理真空”中(没有联网的纸笔、白板,或是单纯的散步),把你脑海中那些崎岖的、粗糙的、甚至不合逻辑的直觉强行写下来。先把那些异质性的连线固定下来,因为如果你不先确立这道防线,它们在与通用AI的第一次交互中就会被瞬间抹平。
在这个流程里,你必须重新定义人机的主从关系。AI的定位只能是“外包打桩机”。你画出图纸,确立了审美的基调和思想的承重墙后,再打开API,让拥有海量算力的机器去帮你填充血肉、寻找反例、查证数据。
设计图纸的权力,必须死死攥在自己手里。只有这样,你喂给那个去中心化私有Agent的数据,才是真正经过你灵魂咀嚼过的高密度偏好,而不是大模型反刍后的工业废水。
结语
我们正身处一个极其舒适、但也极其危险的“数字温水”中。大厂的龙虾每天都在准时送达,每一次点击、每一次生成,都在悄无声息地进行着权力的交接。
未来的剥削不在工厂的流水线上,而在你极其顺滑的提示词里。在这个所有人都在追求一秒生成的时代,那些愿意忍受摩擦力、愿意守护自身认知拓扑图的少数人,终将成为这个赛博时代的刺客,并在A2A的终局中,加冕为真正的数字贵族。